提示词反复优化,模型换了一轮又一轮;chunk 从固定切分到语义动态切分,召回有单路也有多路,策略包括粗排、精排、前置和后置过滤、混合检索等。回头一看,结果还是垃圾进、垃圾出。
文档格式设计
我们常见的文档格式中 DOCX、HTML 和 PDF 是完全不同的三种设计。
DOCX:内容优先,渲染交给应用程序
DOCX 本质是一个 ZIP 压缩包,解压后得到一系列 XML 文件,明确声明内容的语义结构,由应用程序决定如何渲染。解析 DOCX 的程序遍历 XML 树,语义是显式编码在文件里的,解析过程不需要任何空间推断。
HTML:语义标签 + 层叠样式,内容与表现分离
HTML 同样以语义为核心,比如 <h1> 到 <h6> 声明标题层级,<table>/<tr>/<td> 声明表格结构。CSS 样式是可以完全覆盖元素的视觉表现,虽然一个 <h1> 可以被渲染成极小的字号,但它在语义上依然是一级标题。解析 HTML 是读取标签的问题,而非推断视觉关系的问题。
PDF:渲染优先,内容服务于像素
PDF(Portable Document Format)由 Adobe 于 1993 年发布,基于 PostScript 的子集演化而来,本质是一套页面描述语言(Page Description Language)。PDF 解决的问题是实现文档的跨平台、跨设备的可移植性,确保无论在什么操作系统、什么打印机(或屏幕)上,文档的布局和字体渲染保持一致。
PDF 没有段落、没有标题、没有表格这些语义概念。有的只是坐标、字形(glyph)、线段、颜色,以及绘图操作符序列。解析器需要自己去推断这些线段和文字之间的空间关系,才能还原出表格结构,而这种推断在合并单元格、多级表头的情况下很容易出错。
PDF 结构
一个 PDF 文件由四个部分构成:Header、Body、Cross-Reference Table、Trailer。
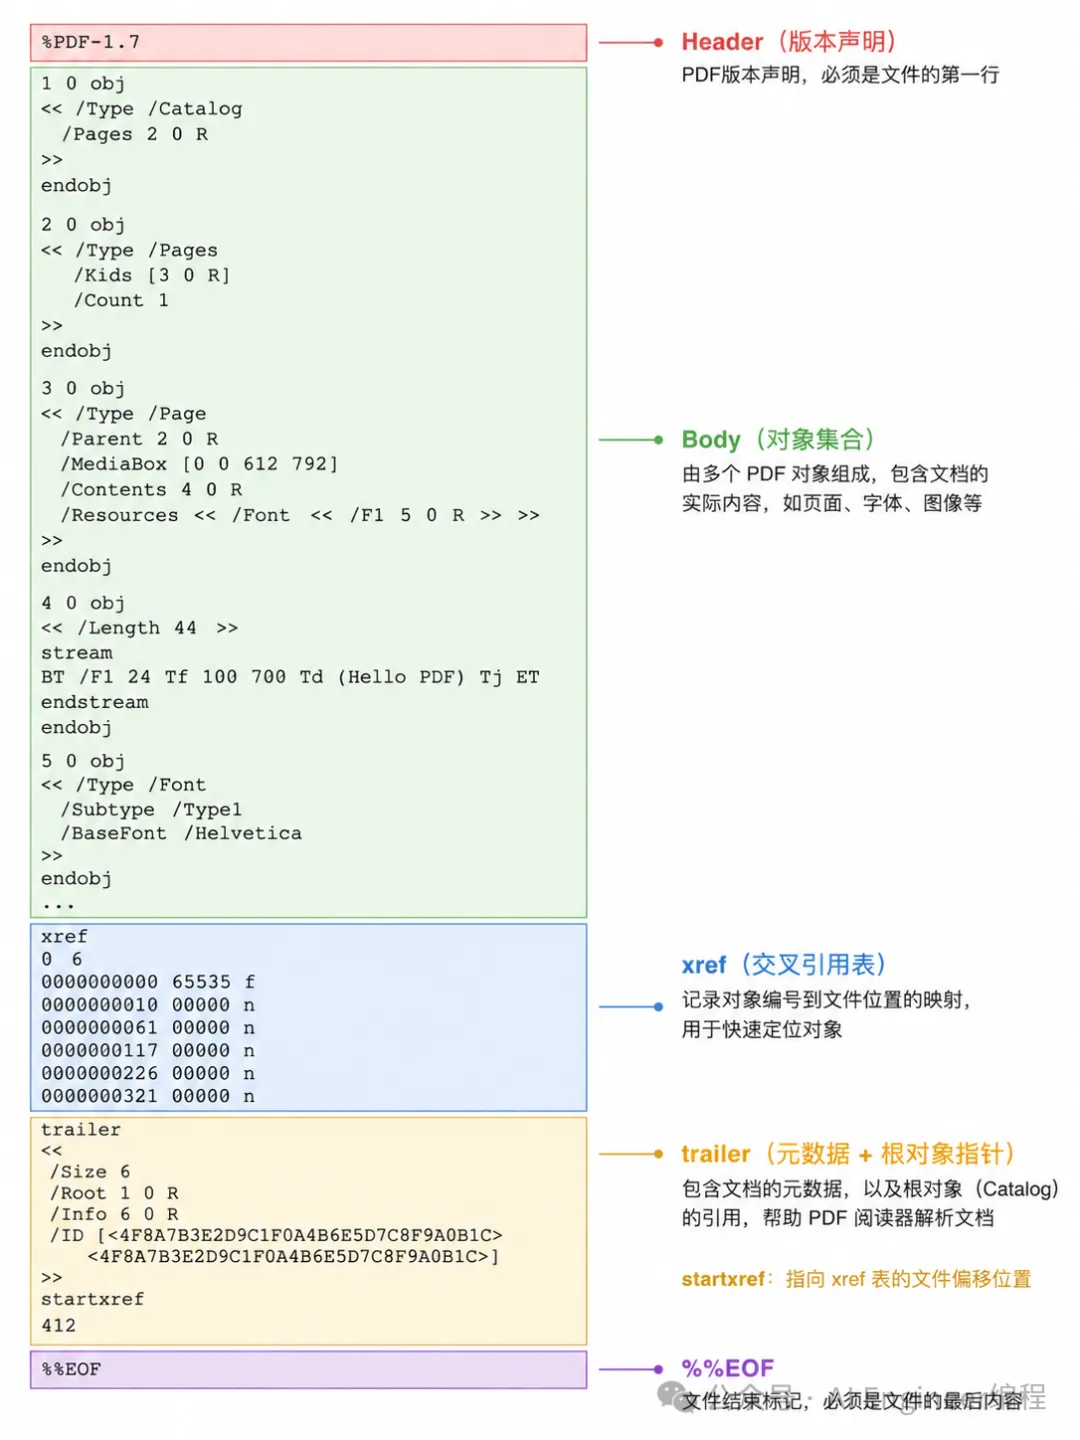
Body 是核心,由大量 COS 对象(Carousel Object System)组成,包括:
| 对象类型 | 作用 |
|---|---|
| 字典(Dictionary) | << /Type /Page /MediaBox [...] >> 描述结构 |
| 流(Stream) | 实际内容数据 |
| 数组(Array) | 页面树、字体列表等 |
| 字符串(String) | 文本内容 |
| 间接引用(Indirect Reference) | 5 0 R 表示引用第 5 号对象 |
xref 表 是 PDF 的索引,记录每个对象在文件中的字节偏移量。PDF 读取器通过 xref 实现随机访问,可以直接跳转到任意对象而无需扫描整个文件。
文字内容存储在每个页面的内容流(Content Stream)中,通过操作符序列描述渲染指令。字体、图像等资源通过资源字典(Resource Dictionary)以间接引用的方式关联到页面。
结构性解析难点
基于上述格式,PDF 解析有几个结构性问题:
无显式阅读顺序
PDF 中的字符对象按渲染顺序存储,不是阅读顺序。对于双栏学术论文,PDF 生成工具可能先写完左栏所有文字再写右栏,也可能按视觉从左到右逐行交替写入。解析器必须基于字符坐标重建阅读顺序,对于任意复杂度的多栏布局,没啥太好的方案。
表格无数据结构
PDF 表格是用线段和坐标定位的文字在视觉上模拟出来的。解析器需要检测线段并判断是否构成表格边框,根据交点确定单元格边界,将字符分配到对应的单元格坐标,处理合并单元格(内部线段缺失导致边界推断失败)。合并单元格是最高频的失败场景。
字体编码映射
PDF 存储的是字体内部的字形 ID(glyph ID),而非 Unicode 字符。解析器需要通过字体的 ToUnicode CMap 将字形 ID 映射为 Unicode 码位。部分 PDF 生成工具不嵌入完整的 ToUnicode 表;Type 3 字体允许完全自定义字形形状;复合字体(CIDFont)的映射关系更复杂。典型表现是提取结果出现乱码、词语内部有异常空格,或部分字符缺失。
扫描件无文本层
基于图像扫描的 PDF 内部没有任何文本流,只有光栅图像对象。必须先对图像做 OCR 将像素还原为字符,才能进入正常的解析流程。
解析原理:从字节流到可读文本
常见的 PDF 解析方案可以归纳为三种不同的技术体系。
原生文本提取
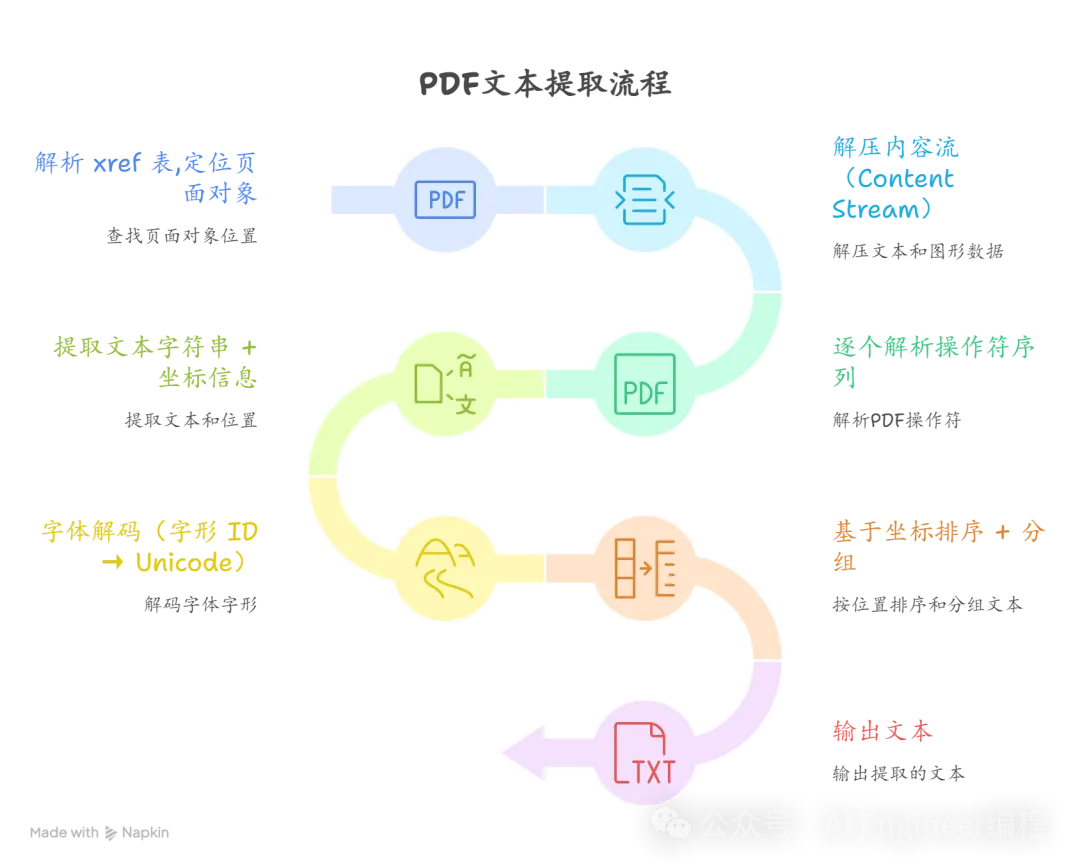
这是最快、资源消耗最低的路线,适用于原生 PDF(由 Word、LaTeX、Adobe InDesign 等软件直接生成,含完整文本层)。
PDF 内容流的核心文本操作符序列如下:
BT                          % Begin Text object
  /F1 12 Tf                 % 选择字体 F1,大小 12pt
  72 720 Td                 % 移动到坐标 (72, 720)
  (Hello, PDF!) Tj          % 显示字符串
  0 -14 Td                  % 移动到下一行(行距 14pt)
  [(Rag) 20 ( pipeline)] TJ % TJ 操作符:允许字形间距调整
ET                          % End Text object
解析器逐条读取这些操作符,维护一个图形状态机(Graphics State Machine),追踪当前变换矩阵(CTM)、当前字体、文字矩阵(Text Matrix)等状态,最终得到每个字符的绝对页面坐标。
难点: 提取出来的是离散的字形点,解析器需要将它们重新组合成词、句、段落。PyMuPDF、pdfplumber 等库的核心差异就在于这个聚合算法的实现质量。
OCR
对于扫描件或图像型 PDF,必须先将页面光栅化为图像,再用 OCR 引擎识别字符。
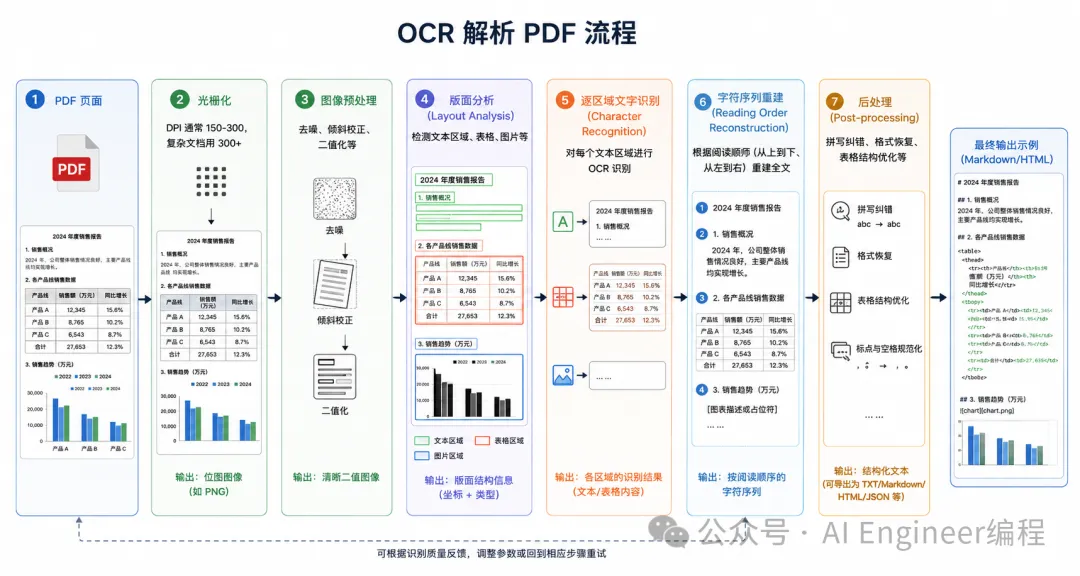
Tesseract 首先对二值图像做连通分量分析找到字符候选,然后用 LSTM 网络对文字行图像做序列到序列的转录。它预设文档是单栏的,多栏处理依赖启发式的列分割,在复杂布局上表现不稳定。
PaddleOCR 引入了独立的版面分析模型,在识别字符之前先检测文档区域,然后对每个区域独立 OCR。
难点:
- 表格识别:OCR 引擎识别出文字后,还需要额外的表格结构恢复模块才能还原单元格关系
- 版面分析错误的级联效应:一旦区域检测出错,该区域内所有文字的阅读顺序都会乱序
视觉语言模型
VLM 将整个页面作为图像输入,直接输出结构化文本,绕过了坐标提取、字体解码、阅读顺序重建等所有中间步骤。
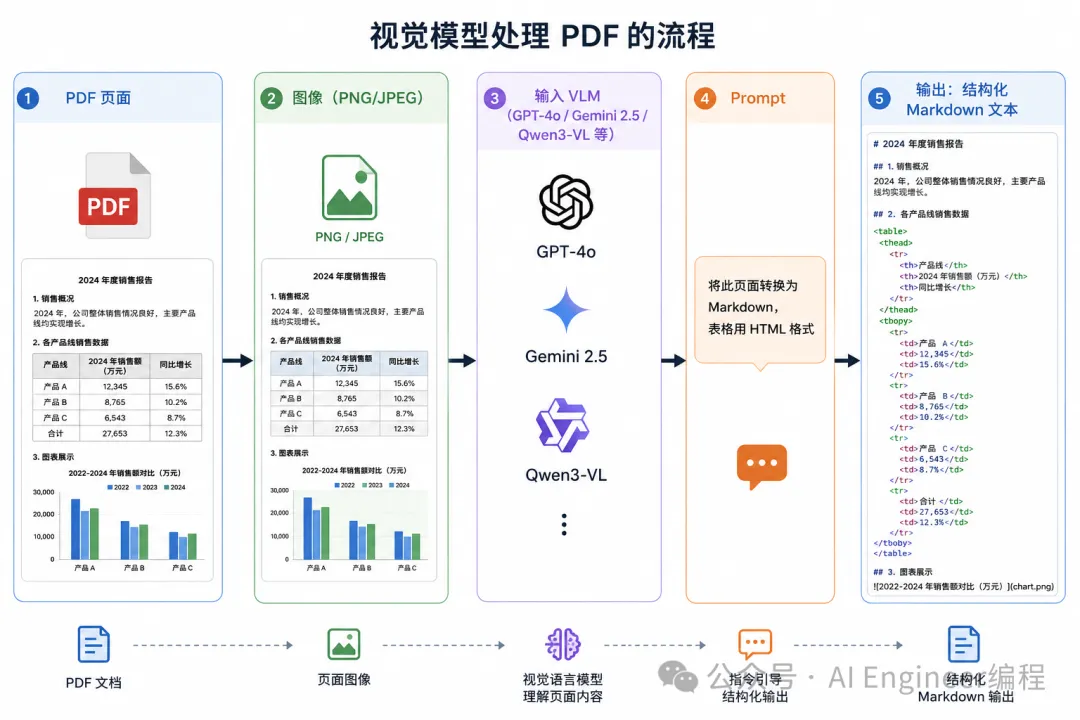
优势:
- 自然处理复杂布局:多栏、嵌套表格、混排图文
- 对合并单元格、跨页表格有理解能力
- 直接输出语义结构,不需要后处理
难点: 模型会产生幻觉,另外就是成本问题;数据合规和隐私某些时候也是个问题。
主流解析方案
目前常见的 PDF 解析工具可以分为:
- 轻量文本提取库:PyMuPDF、pdfplumber、pypdf,原生文本提取路线,速度极快
- AI 增强开源框架:Docling、MinerU、Marker-PDF,集成布局分析模型,面向 RAG 场景
- 收费 API:各大云厂商都有提供 API,托管服务,开箱即用
- VLM 直接调用:GPT-4o、Gemini 2.5、Qwen3-VL,最高理解能力,成本最高
轻量文本提取库
这类工具直接读取 PDF 内容流中的字符坐标,按坐标排序后输出文本;不做版面分析,速度极快,但处理能力受制于 PDF 格式本身的局限。
PyMuPDF:底层基于 MuPDF 引擎,对 PDF 规范的高兼容性。PyMuPDF4LLM 是面向 LLM 场景的扩展,在原始提取结果上加了 Markdown 格式化层,处理标题层级、列表识别,以及基于坐标的简单表格重建。
pdfplumber:基于 pdfminer.six,专注于表格提取,在页面上找到所有水平和垂直线段,计算交点,以交点网格为单元格边界提取文字。对于有清晰边框线的表格效果很好,对于无线框表格或合并单元格效果很差。
AI 增强开源框架
这类工具在文本提取的基础上,引入了布局分析模型对页面进行区域分类,能处理复杂版面问题。
Docling:底层使用 PyMuPDF 做文本提取获取字符坐标,中间层用 DocLayNet 布局分析模型将页面划分为标题、段落、表格、图片等语义区域,上层用 TableFormer 模型专门处理表格结构恢复。引入了统一的中间表示 DoclingDocument,是一棵完整保留层级结构的文档树,可以导出为 Markdown、HTML、JSON 或 DocTags 格式。
MinerU:以 PaddleOCR 作为字符识别引擎,配合 PDF-Extract-Kit 布局检测模型,在处理中文文档和包含 LaTeX 公式的学术论文上效果比较好。
Marker-PDF:多格式统一入口,支持 PDF、DOCX、PPTX、XLSX、EPUB、HTML 以及各种图像格式,对需要统一处理异构文档库的场景有便利性优势。
VLM 直接调用
VLM 将 PDF 页面光栅化为图像后直接输入多模态模型,由模型输出结构化文本。直接绕过了复杂的坐标提取、字体解码、阅读顺序重建的所有中间步骤。
| 场景 | 模型 |
|---|---|
| 综合最强(闭源) | Gemini 2.5 Pro |
| 综合最强(开源) | Qwen2.5-VL-72B、InternVL3 |
| 文档 OCR | Gemma 3、LLaMA 3.2 Vision、DeepSeek-OCR |
| 轻量部署 | Phi-4、Pixtral 12B、DeepSeek-VL2 |
| 中文场景 | Qwen2.5-VL、GLM-4.5V |
常见解析问题
RAG 应用在生产环境中的 PDF 解析问题主要在解析层和内容层。
多栏混排导致阅读顺序错乱
问题描述:多栏布局是 RAG 解析中影响最大的单一问题。PDF 的物理存储顺序不保证阅读顺序,轻量解析库按存储顺序提取字符,导致左右栏文字被交织拼接。
处理方案:按坐标排序是最基础的改善。最好的解决方案是进行版面分析(DocLayNet 或 PP-StructureV2 等),对于极复杂版式需使用 VLM。
字体编码缺失导致乱码
问题描述:当 PDF 生成工具未嵌入完整的 ToUnicode CMap 时,输出结果为乱码、方框(□□□□)或空白。
处理方案:换用不同解析库(不同引擎对字体编码的处理能力有差异);如果多个解析器都失败,绕过文本层直接对页面图像做 OCR。
跨页内容断裂
问题描述:物理分页与逻辑分段天然无法对齐,跨越页面边界的段落/表格被物理截断。
| 跨页类型 | 出现频次 | 可能导致的问题 |
|---|---|---|
| 段落跨页 | 常见 | 段落语义断裂,上下文不完整 |
| 表格跨页 | 一般 | 表头在一页,数据在下一页,行列关系丢失 |
| 图表与说明跨页 | 一般 | 图片和其对应说明文字被分离 |
处理方案:分块阶段设置 overlap;语义分块(基于 embedding 检测语义边界后切割);表格跨页需专门检测并合并(Docling、MinerU 内置此逻辑)。
页眉页脚污染索引
问题描述:100 页文档中相同页眉出现 100 次,产生大量近似重复 chunk,影响检索区分能力。
处理方案:位置过滤(过滤 y 坐标落在页面顶部/底部 8% 区域内的文字块);跨页重复检测(统计每行文字跨页出现频率,超阈值的标记过滤)。
图表信息丢失
问题描述:纯文本解析对嵌入 PDF 的图片、图表的处理结果是完全丢失的。
处理方案:先用文本解析完成检索定位相关页面,再将页面光栅化为图像输入 VLM 进行深度理解,结合文本内容与 VLM 输出生成回答。
参考文献与脚注处理
问题描述:引用标记所在的 chunk 和对应的参考文献/脚注内容 chunk 被分离到向量索引的不同位置。
处理方案:版面分析区分正文和脚注区域(Docling/MinerU 输出文档树中脚注作为独立类型节点);参考文献可在索引时解析引用链嵌入元数据,或在检索后扩展上下文返回对应条目。
标题层级在分块后丢失
问题描述:按 token 数固定分块不感知文档层级结构,每个 chunk 不携带在文档层级中的位置信息。
处理方案:为每个 chunk 构建文档层级完整路径作为元数据前缀;按语义边界(章节、小节)切割而非按 token 数;父子 chunk 策略——小 chunk(128-256 token)做检索,命中后返回父节点(512-1024 token)给 LLM 生成。
结语
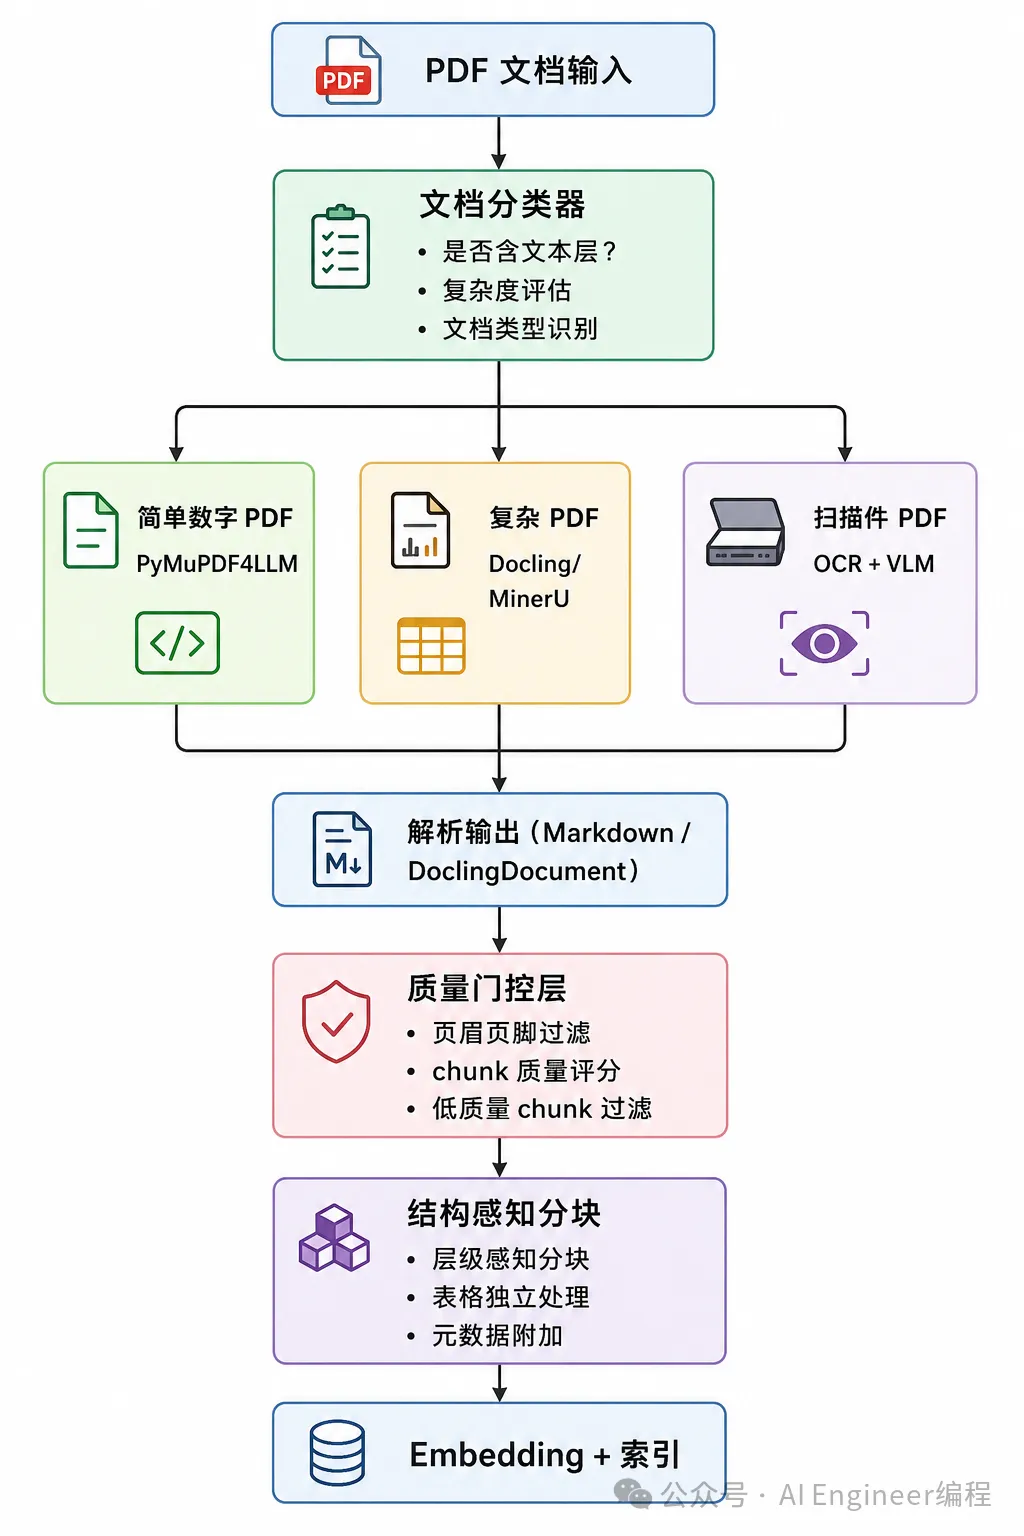
PDF 解析目前仍然没有完美的解决方案。格式的设计目的是根本原因——PDF 的页面描述语言架构导致语义信息在格式层面缺失,解析工具本质上都是在用启发式方法或统计模型还原这些缺失的语义。
如果实际业务场景要求比较高,混合解析可能是折中的办法,但也会带来复杂度上升。