从 0 到 1 搭建 Confluence 内部 Wiki RAG 知识库增强检索系统:正文、评论、附件、图片全量打通
公司的 Wiki 知识库积累了运维部门近五年的知识内容。如何结合大模型实现内部知识库的 RAG 增强检索?检索结果不仅可以展示正文,也可以呈现插入的图片、附件和评论等内容。
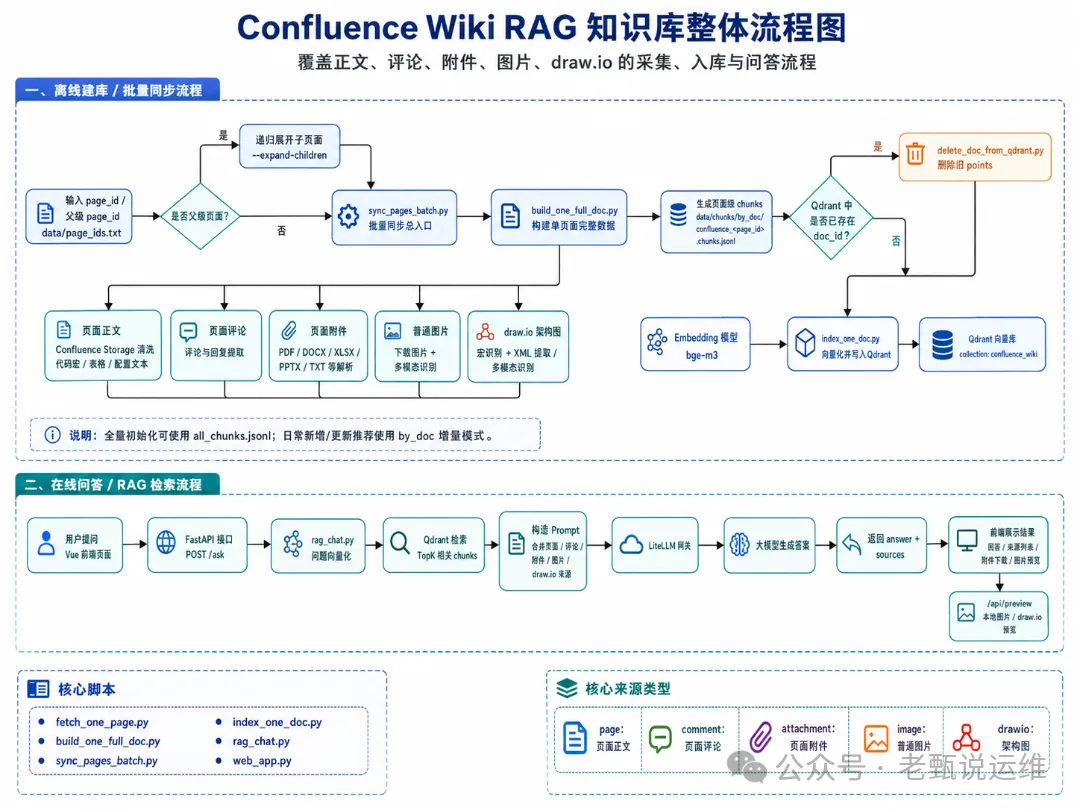
为什么要做 RAG 知识库检索
传统 Wiki 检索存在以下问题:
- 搜索关键词不准,很难找到真正需要的内容
- 页面里有大量代码宏、配置文件、附件、图片、架构图,普通文本检索覆盖不完整
- 知识分散在正文、评论、附件、图片和 draw.io 图里
- 新增或更新页面后,需要有增量同步机制
- 大模型回答时必须可溯源,不能胡编
因此,我们设计了一套基于 Confluence + Qdrant + LiteLLM + FastAPI + Vue 的内部 Wiki RAG 知识库方案。
最终目标
Confluence Wiki
  ├── 页面正文
  ├── 代码宏
  ├── 页面评论
  ├── 页面附件
  ├── 普通图片
  └── draw.io 架构图
        ↓ 采集 / 清洗 / 解析 / 切分
Qdrant 向量库
        ↓ RAG 检索
LiteLLM 网关 + 大模型
        ↓
FastAPI HTTP 服务
        ↓
Vue 前端问答页面
整体架构
┌──────────────────────────────┐
│        Confluence Wiki        │
│ 正文 / 评论 / 附件 / 图片 / 图 │
└───────────────┬──────────────┘
                │ REST API
                ↓
┌──────────────────────────────┐
│          数据采集层            │
│ fetch_one_page.py             │
│ fetch_pages_tree.py           │
│ build_one_full_doc.py         │
└───────────────┬──────────────┘
                ↓
┌──────────────────────────────┐
│        内容解析清洗层          │
│ confluence_cleaner.py         │
│ 附件解析 / 图片识别 / draw.io解析│
└───────────────┬──────────────┘
                ↓
┌──────────────────────────────┐
│          Chunk 构建层          │
│ data/chunks/by_doc/*.jsonl    │
└───────────────┬──────────────┘
                ↓
┌──────────────────────────────┐
│          向量化入库层          │
│ index_one_doc.py              │
│ index_qdrant.py               │
│ Embedding: bge-m3             │
│ Vector DB: Qdrant             │
└───────────────┬──────────────┘
                ↓
┌──────────────────────────────┐
│           RAG 服务层           │
│ rag_chat.py                   │
│ web_app.py FastAPI            │
│ LiteLLM Gateway               │
└───────────────┬──────────────┘
                ↓
┌──────────────────────────────┐
│            Vue 前端            │
│ 问答 / 来源 / 图片预览 / 附件下载│
└──────────────────────────────┘
技术选型
| 模块 | 技术方案 |
|---|---|
| Wiki 来源 | Confluence Server / Data Center |
| 页面采集 | Confluence REST API |
| 文本清洗 | BeautifulSoup + 自定义 Confluence Storage Format 清洗 |
| 向量模型 | BAAI/bge-m3 |
| 向量数据库 | Qdrant |
| 大模型网关 | LiteLLM |
| 后端接口 | FastAPI + Uvicorn |
| 前端页面 | Vue 3 + Vite |
| PDF 解析 | pypdf |
| Word 解析 | python-docx |
| Excel 解析 | openpyxl |
| PPT 解析 | python-pptx |
| 图片理解 | LiteLLM 后接多模态模型 |
| 图片压缩 | Pillow |
为什么不能只处理页面正文
Confluence Wiki 的内容并不只是普通文本。一个真实的内部 Wiki 页面中,可能同时包含:
- 页面正文
- 代码宏
- 配置文件
- 表格
- 页面评论
- PDF 附件
- Word 附件
- Excel 附件
- PPT 附件
- 普通图片
- draw.io 架构图
如果只处理正文,会丢掉大量关键信息。例如一个 DNS 架构页面里:
- 正文中描述了 dnsdist、Bind9、PowerDNS 的功能
- draw.io 图里展示了请求流量、响应流量、代理、出口和集群关系
- 附件里可能有部署说明
- 评论里可能有后续变更提醒
因此,最终方案需要把不同来源统一处理成 RAG 可检索的 chunk。
数据来源类型设计
我们用 source_type 区分不同来源:
| 数据来源 | source_type | 说明 |
|---|---|---|
| 页面正文 | page | 普通正文、代码宏、配置文件、表格 |
| 页面评论 | comment | 评论和回复 |
| 页面附件 | attachment | PDF、docx、xlsx、pptx、txt、conf 等 |
| 普通图片 | image | 页面插入图片,经多模态模型解析 |
| draw.io 图 | drawio | Confluence draw.io 宏解析 |
| 空页面元信息 | page | 目录页或空页的最小元信息 |
最终所有内容都会被转换为统一格式:
{
  "chunk_id": "confluence_34144478_page_v10_0000",
  "source_type": "page",
  "doc_id": "34144478",
  "title": "1-生产环境xxx 架构",
  "url": "https://wiki.net-inc.com/pages/viewpage.action?pageId=34144478",
  "text": "..."
}
推荐目录结构
/data1/confluence-rag/
├── config.py
├── confluence_cleaner.py
│
├── fetch_one_page.py
├── fetch_pages_tree.py
├── build_one_full_doc.py
├── sync_pages_batch.py
├── delete_doc_from_qdrant.py
├── index_one_doc.py
├── index_qdrant.py
├── query_test.py
├── rag_chat.py
├── web_app.py
│
├── data/
│   ├── raw/
│   │   └── confluence_<page_id>.json
│   ├── chunks/
│   │   ├── all_chunks.jsonl
│   │   └── by_doc/
│   │       └── confluence_<page_id>.chunks.jsonl
│   ├── comments/
│   ├── attachments/
│   ├── attachment_text/
│   ├── images/
│   ├── image_text/
│   ├── drawio/
│   ├── drawio_text/
│   └── drawio_preview/
│
└── rag-web/
    ├── package.json
    ├── vite.config.js
    └── src/
其中最重要的是:data/chunks/by_doc/confluence_<page_id>.chunks.jsonl
核心配置文件
config.py 用于统一管理 Confluence、Qdrant、Embedding、LiteLLM 等配置。
# Confluence
CONFLUENCE_BASE_URL = "https://wiki.net-inc.com"
CONFLUENCE_API_BASE = "https://wiki.net-inc.com/rest/api"
USERNAME = "your_username"
PASSWORD_OR_TOKEN = "your_password_or_token"

# 递归同步时使用的根页面
ROOT_PAGE_IDS = [
    "45253066",
]
INCLUDE_ROOT_PAGE = False

# Qdrant
QDRANT_URL = "http://127.0.0.1:6333"
QDRANT_COLLECTION = "confluence_wiki"

# Embedding
EMBEDDING_MODEL_PATH = "/data1/models/bge-m3"

# LiteLLM Gateway
LLM_BASE_URL = "http://your-litellm-host:4000/v1"
LLM_API_KEY = "sk-xxx"
LLM_MODEL = "your-text-model"

# 多模态模型
VISION_MODEL = "your-vision-model"

# Chunk 参数
CHUNK_SIZE = 1800
CHUNK_OVERLAP = 200
单页面采集
单个页面可以通过 fetch_one_page.py 拉取:
python fetch_one_page.py 34144478输出:data/raw/confluence_34144478.json
结构示例:
{
  "doc_id": "34144478",
  "title": "1-办公网 DNS 架构",
  "space_key": "ost",
  "space_name": "运维中心/xx组/系统运维",
  "ancestors": [
    "运维中心/xx组/系统运维",
    "9-内部知识",
    "03-基础服务",
    "02-内部DNS系统"
  ],
  "version": 10,
  "updated_at": "2024-07-15T15:37:12.360+08:00",
  "url": "https://wiki.net-inc.com/pages/viewpage.action?pageId=34144478",
  "content_storage": "..."
}
父级页面递归采集
如果输入的是父级目录页,可以通过:
python sync_pages_batch.py data/page_ids.txt --mode auto --expand-children脚本会调用 Confluence 接口:
GET /rest/api/content/{page_id}/child/page
递归处理所有子页面。默认只处理子页面,不处理父级页面本身。如果父级页面本身也要处理:
python sync_pages_batch.py data/page_ids.txt --mode auto --expand-children --include-rootConfluence 正文清洗
Confluence 正文不是普通 HTML,而是 Storage Format。例如代码宏:
<ac:structured-macro ac:name="code">
  <ac:plain-text-body><![CDATA[yum install -y chrony
  ]]></ac:plain-text-body>
</ac:structured-macro>
如果用普通 HTML 清洗,很容易丢失代码块内容。因此我们使用 confluence_cleaner.py 专门处理 Confluence 宏。
支持的宏处理
| 宏类型 | 处理方式 |
|---|---|
| code | 提取 CDATA,转 Markdown 代码块 |
| drawio | 保留占位,实际走 draw.io 处理流程 |
| info / note / warning / tip | 保留提示内容 |
| panel | 保留面板内容 |
| toc | 丢弃 |
| children | 丢弃 |
| 未识别宏 | 尽量保留可见文本 |
代码宏清洗后:
yum install -y chrony这对运维类 Wiki 非常关键,因为很多页面的命令和配置都在代码宏中。
Chunk 切分策略
切分原则:
- 优先按 Markdown 标题切分
- 超长内容按行切分
- 保留 chunk overlap
- 代码块内部不按
#切分 - 每个 chunk 都补充标题、路径、URL 等上下文
注意,配置文件中常见:
# cat /etc/chrony.conf
# Enable kernel synchronization of the real-time clock
rtcsync
user root
这里的 # 是注释,不应被当成标题。所以切分时需要识别代码块状态。
附件处理方案
附件作为独立来源入库,source_type=attachment。
支持类型
| 文件类型 | 解析方式 |
|---|---|
| .txt / .log / .conf / .ini | 直接读取文本 |
| .yaml / .yml / .json / .xml | 直接读取文本 |
| .md / .sh / .sql | 直接读取文本 |
| .csv | CSV 转文本 |
| pypdf | |
| .docx | python-docx |
| .xlsx | openpyxl |
| .pptx | python-pptx |
默认跳过:图片、drawio、压缩包、rpm、exe、jar、war、视频、音频
附件 chunk 示例
{
  "chunk_id": "confluence_34144478_attachment_987654_0000_部署文档.pdf",
  "source_type": "attachment",
  "doc_id": "34144478",
  "attachment_id": "987654",
  "title": "1-办公网 DNS 架构 / 附件 / 部署文档.pdf",
  "filename": "部署文档.pdf",
  "mime_type": "application/pdf",
  "download_url": "https://wiki.net-inc.com/download/attachments/...",
  "attachment_local_path": "data/attachments/34144478_987654_部署文档.pdf",
  "url": "https://wiki.net-inc.com/pages/viewpage.action?pageId=34144478",
  "text": "来源类型:页面附件\n..."
}
普通图片处理方案
普通图片一般来自:
<ac:image>
  <ri:attachment ri:filename="xxx.png" />
</ac:image>
处理流程:
识别图片附件
  ↓
下载图片
  ↓
调用 LiteLLM 多模态模型
  ↓
生成结构化图片说明
  ↓
作为 source_type=image 入库
图片 chunk 示例
{
  "chunk_id": "confluence_34144478_image_dns.png",
  "source_type": "image",
  "doc_id": "34144478",
  "title": "1-办公网 DNS 架构 / 图片 / dns.png",
  "filename": "dns.png",
  "image_url": "https://wiki.net-inc.com/download/attachments/...",
  "download_url": "https://wiki.net-inc.com/download/attachments/...",
  "image_local_path": "data/images/34144478_dns.png",
  "preview_path": "data/images/34144478_dns.png",
  "url": "https://wiki.net-inc.com/pages/viewpage.action?pageId=34144478",
  "text": "来源类型:图片 / 架构图\n..."
}
多模态模型输出格式建议
# 图片主题
# 核心组件
# IP / 域名 / VIP / 端口
# 请求流量路径
# 响应流量路径
# 架构关系说明
# 运维检索关键词
# 完整图片说明
draw.io 架构图处理方案
Confluence 中 draw.io 不是普通图片,而是宏:
<ac:structured-macro ac:name="drawio">
  <ac:parameter ac:name="diagramName">内部dns网络架构图</ac:parameter>
  <ac:parameter ac:name="revision">18</ac:parameter>
</ac:structured-macro>
处理流程:
识别 draw.io 宏
  ↓
提取 diagramName / revision
  ↓
从页面附件中查找相关 .drawio / .xml / .png / .svg 文件
  ↓
如果是图片:调用多模态模型解析
如果是 .drawio/.xml:提取 mxCell 节点文字,再让模型整理
  ↓
生成 source_type=drawio chunk
draw.io chunk 示例
{
  "chunk_id": "confluence_34144478_drawio_内部dns网络架构图",
  "source_type": "drawio",
  "doc_id": "34144478",
  "title": "1-办公网 DNS 架构 / draw.io / 内部dns网络架构图",
  "diagram_name": "内部dns网络架构图",
  "filename": "内部dns网络架构图.drawio",
  "download_url": "https://wiki.eeo-inc.com/download/attachments/...",
  "drawio_local_path": "data/drawio/34144478_内部dns网络架构图.drawio",
  "preview_path": "data/drawio_preview/34144478_内部dns网络架构图.png",
  "url": "https://wiki.eeo-inc.com/pages/viewpage.action?pageId=34144478",
  "text": "来源类型:draw.io 架构图\n..."
}
路径字段规范
为了避免不同文件类型混用 local_path,最终推荐使用:
| 字段 | 说明 |
|---|---|
| image_local_path | 普通图片本地路径 |
| drawio_local_path | draw.io 源文件本地路径 |
| attachment_local_path | 附件本地路径 |
| preview_path | 前端预览用路径 |
| download_url | Confluence 原始下载地址 |
| image_url | 图片原始地址 |
| filename | 文件名 |
| diagram_name | draw.io 图名 |
前端展示图片时只需要关注:
{
  "preview_url": "/api/preview?path=data/images/xxx.png"
}
Qdrant 入库策略
1. 全量入库
首次初始化或规则大改时使用:
python index_qdrant.py读取:data/chunks/all_chunks.jsonl
2. 单页面入库
日常新增或更新使用:
python index_one_doc.py data/chunks/by_doc/confluence_34144478.chunks.jsonl3. 稳定 point id
为了避免重复数据,point id 使用稳定 UUID:
def stable_uuid(text: str) -> str:
    return str(uuid.uuid5(uuid.NAMESPACE_URL, text))
写入 Qdrant:
PointStruct(
    id=stable_uuid(chunk["chunk_id"]),
    vector=vector.tolist(),
    payload=payload,
)
只要 chunk_id 不变,重复执行就是覆盖,不会重复新增。
RAG 查询服务
rag_chat.py 负责:
用户问题
  ↓
Embedding 问题
  ↓
Qdrant 检索 TopK
  ↓
构造 Prompt
  ↓
LiteLLM 调用大模型
  ↓
返回 answer + sources
Prompt 规则
- 只基于知识库内容回答
- 找不到明确答案就说”知识库中没有找到明确说明”
- 不要编造内部流程、IP、命令、负责人、域名或配置
- 页面正文优先级高于评论
- 附件也是正式资料
- 图片/draw.io 说明来自图像解析
- 冲突时说明冲突
来源返回 sources
由于新 payload 使用:
preview_pathimage_local_pathdrawio_local_pathattachment_local_path
extract_sources() 不能只读旧字段:
local_path = payload.get("local_path", "")应该优先读取:
preview_path = payload.get("preview_path", "")
image_local_path = payload.get("image_local_path", "")
drawio_local_path = payload.get("drawio_local_path", "")
并生成:
preview_url = f"/api/preview?path={final_preview_path}"结语
这套方案的核心是:
一个 page_id,生成一个完整 chunks 文件,然后整体替换 Qdrant 中这个 doc_id。
日常使用说明
日常使用只需要一个入口:
python sync_pages_batch.py data/page_ids.txt --mode auto如果输入的是父级页面:
python sync_pages_batch.py data/page_ids.txt --mode auto --expand-children系统会自动完成:
- 拉取页面
- 清洗正文
- 处理评论
- 解析附件
- 识别图片
- 解析 draw.io
- 生成 chunks
- 判断新增或更新
- 写入 Qdrant
最终实现一个支持正文、评论、附件、图片和架构图的企业内部 Wiki RAG 知识库系统。