RAG-Agent是一个基于 RAG 架构的企业级 AI 知识库项目,包含完整的源码和教程。
一、RAG-Agent简介
RAG-Agent 是一个 AI 知识库项目,下个版本计划加入 MCP 和 Agent。
二、RAG-Agent的技术栈
先说后端的:
-
框架/依赖管理 : Spring Boot 3.4.2 (Java 17)+Maven
-
数据库 : MySQL 8.0 + Spring Data JPA
-
缓存 : Redis
-
搜索引擎 : Elasticsearch 8.10.0
-
消息队列 : Apache Kafka
-
文件存储/解析 : MinIO + Apache Tika
-
安全认证 : Spring Security + JWT
-
AI 集成 : DeepSeek API/本地 Ollama+豆包 Embeddin g
-
实时通信 : WebSocket
-
响应式编程 : WebFlux
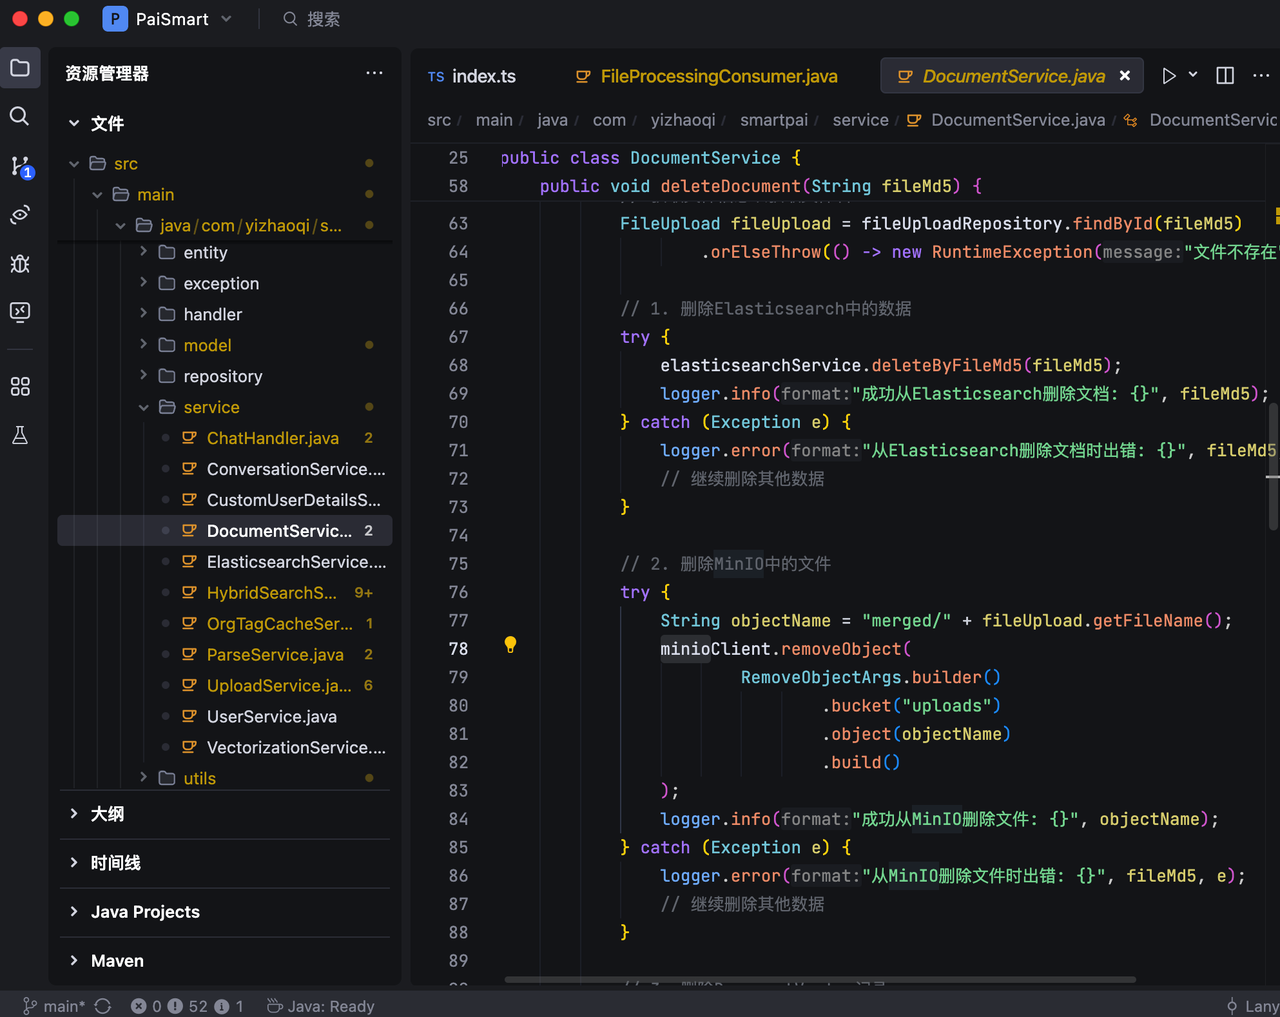
后端的整体项目结构:
前端其实用到的技术栈也非常新,包括:
-
框架 : Vue 3 + TypeScript
-
构建工具 : Vite
-
UI 组件 : Naive UI
-
状态管理 : Pinia
-
路由 : Vue Router
-
样式 : UnoCSS + SCSS
-
图标 : Iconify
-
包管理 : pnpm
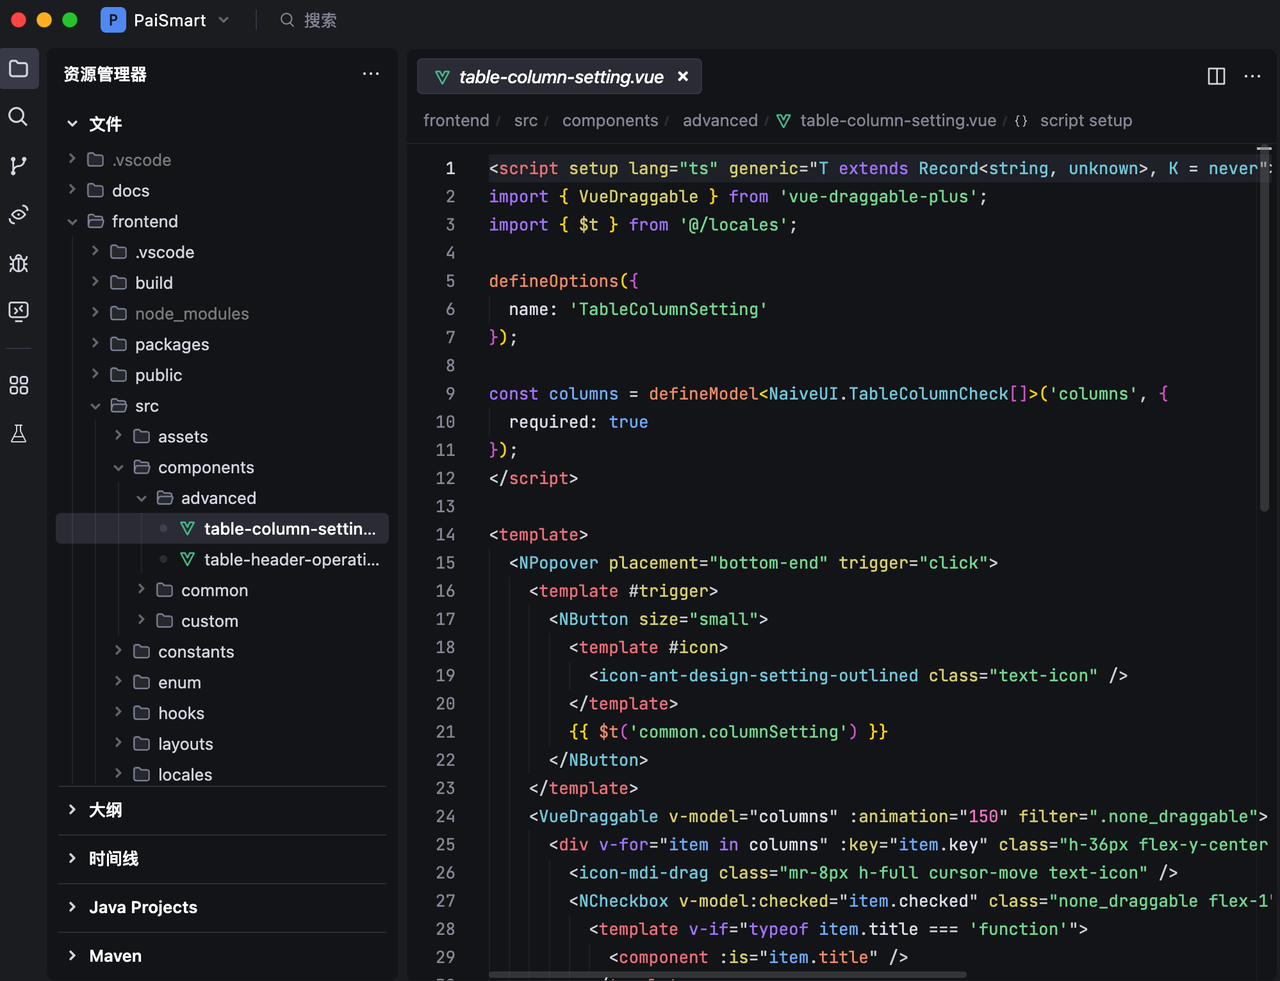
前端的整体项目结构:
三、RAG-Agent的技术架构
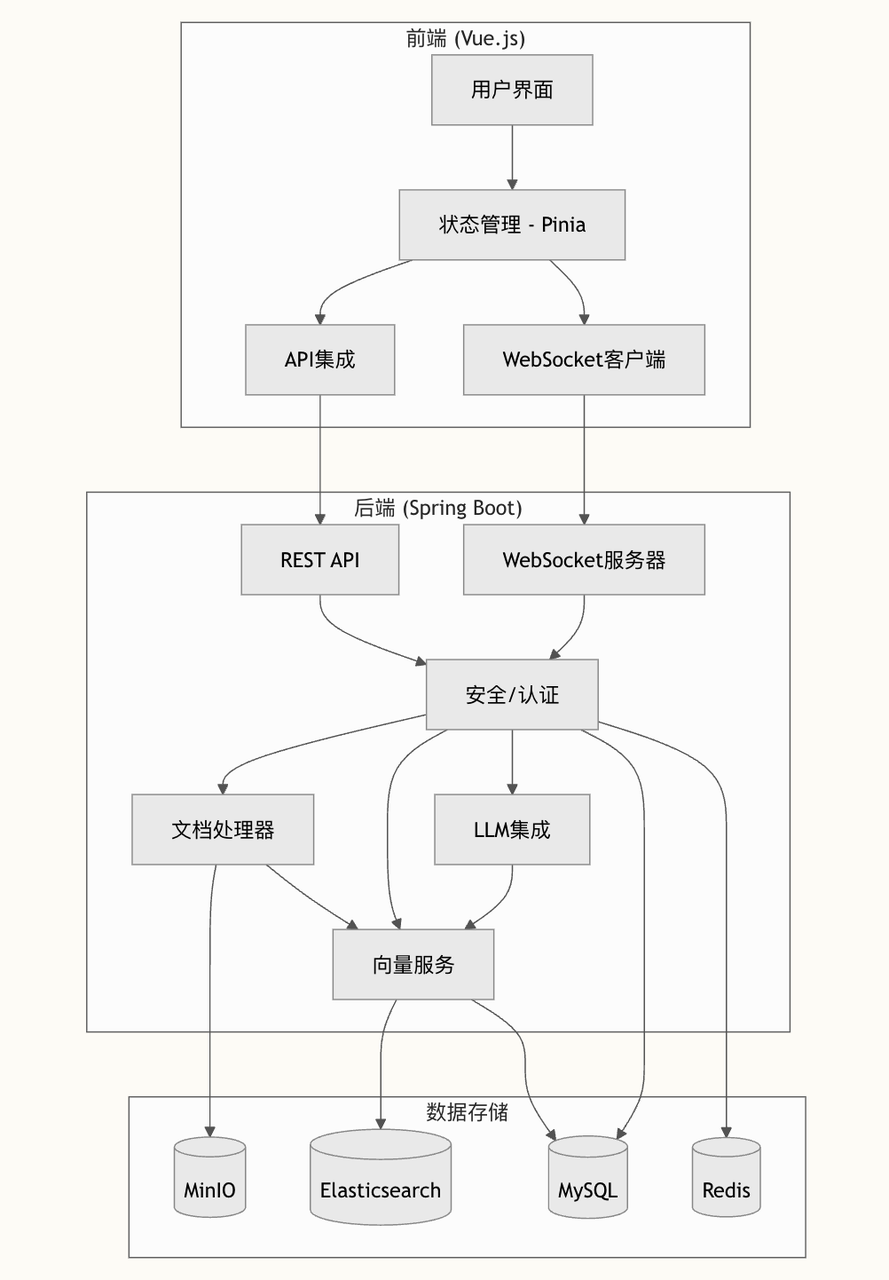
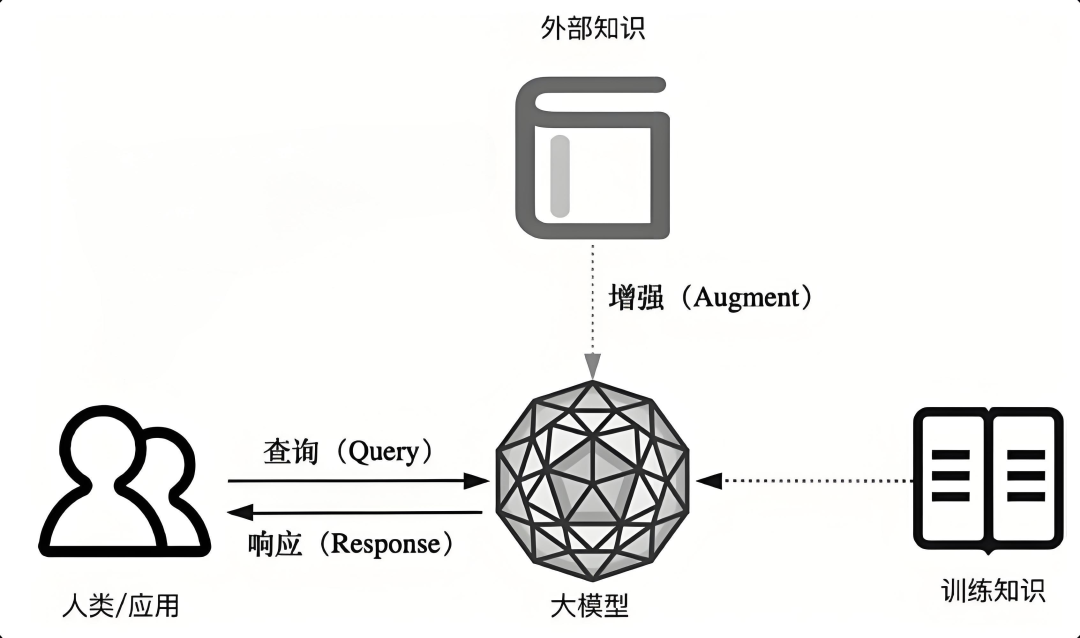
下面这张图与 RAG-Agent RAG 知识库比较吻合,我贴在这里供大家参考。
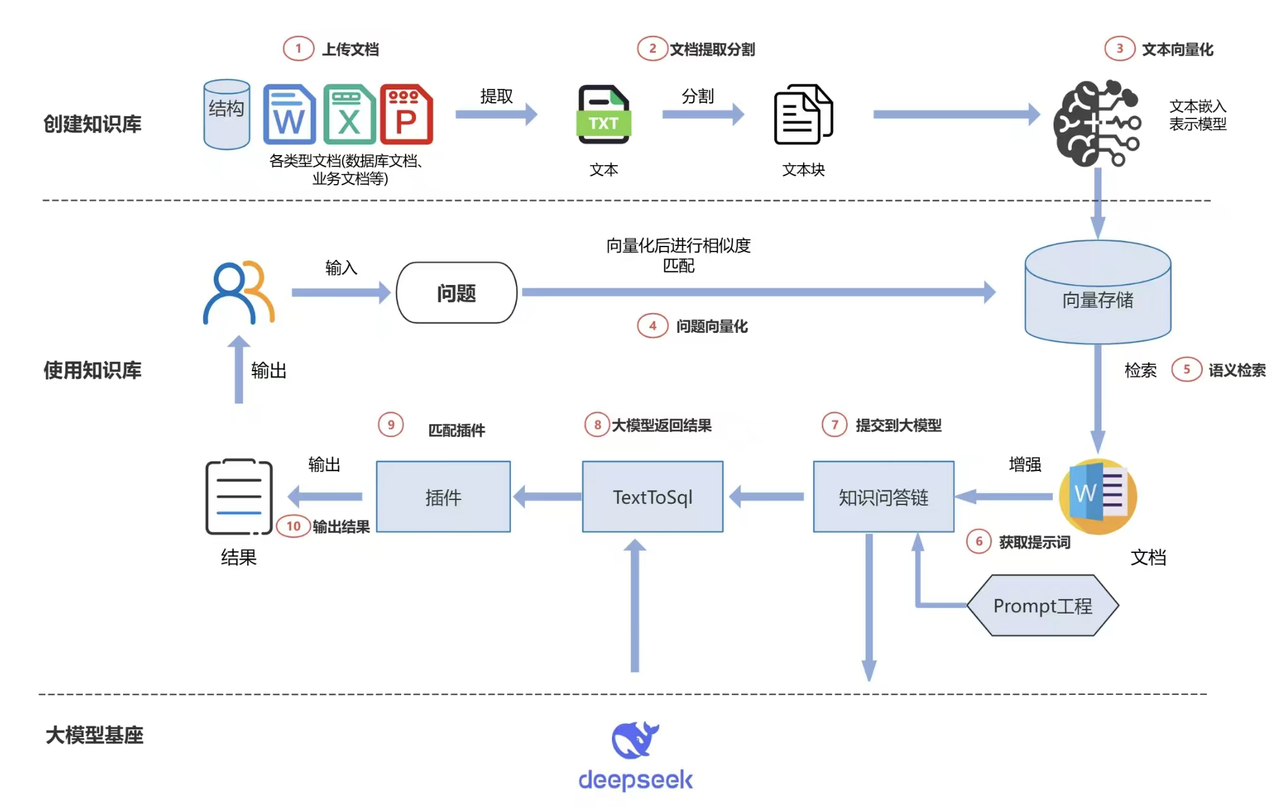
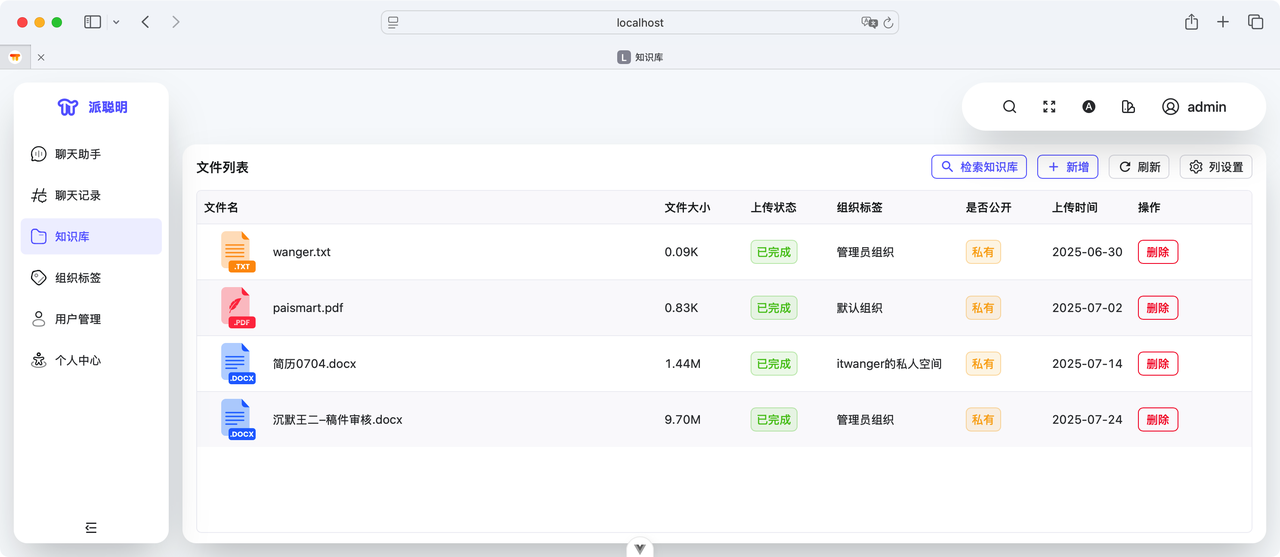
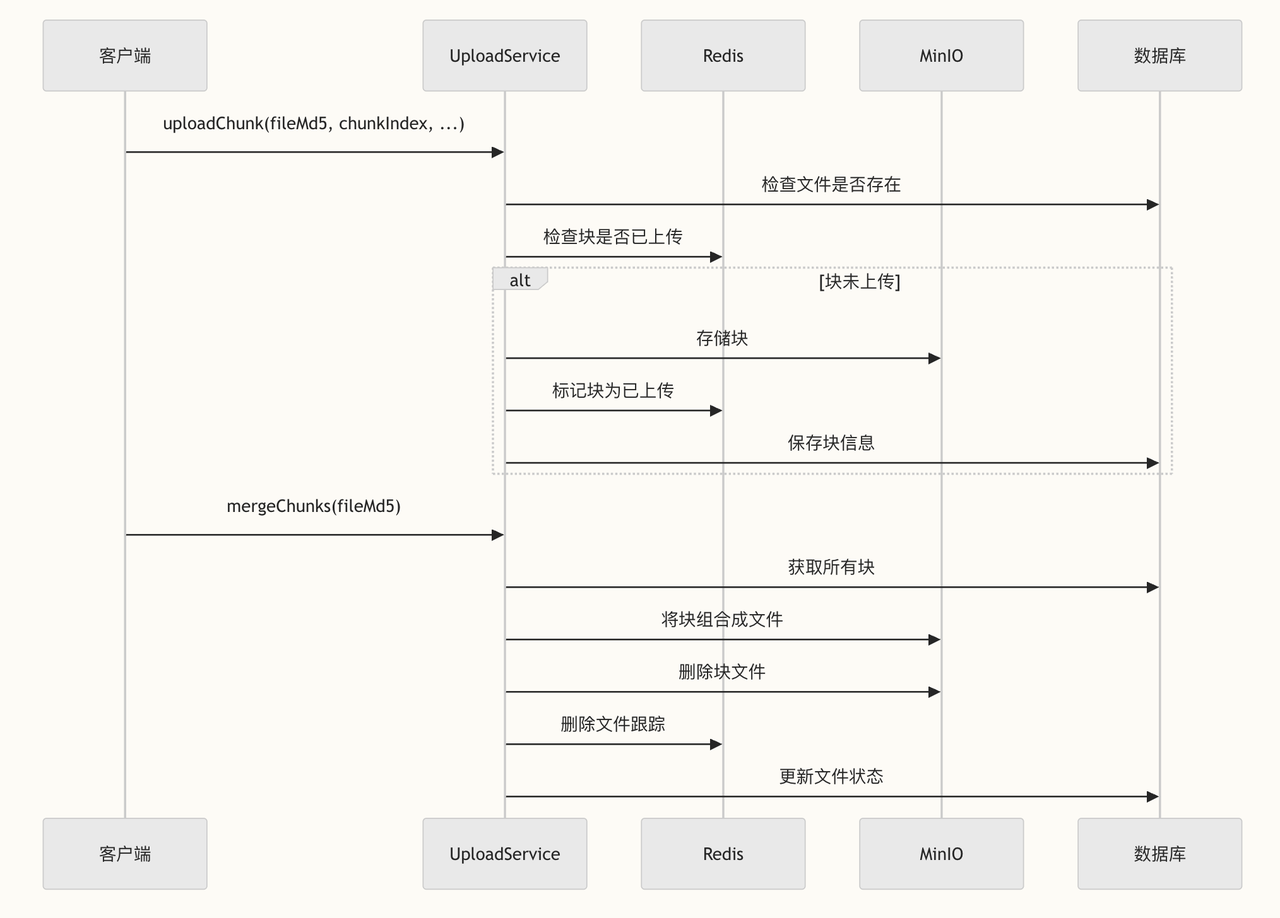
底层使用 DeepSeek 大模型。业务流程是:将企业私有的 Word、PDF、txt 文件上传到 RAG-Agent 后,系统会自动进行向量化处理,并支持大文件断点续传和分片上传。分片状态保存在 Redis 的 BitMap 中,文件本身存储在 MinIO 中。
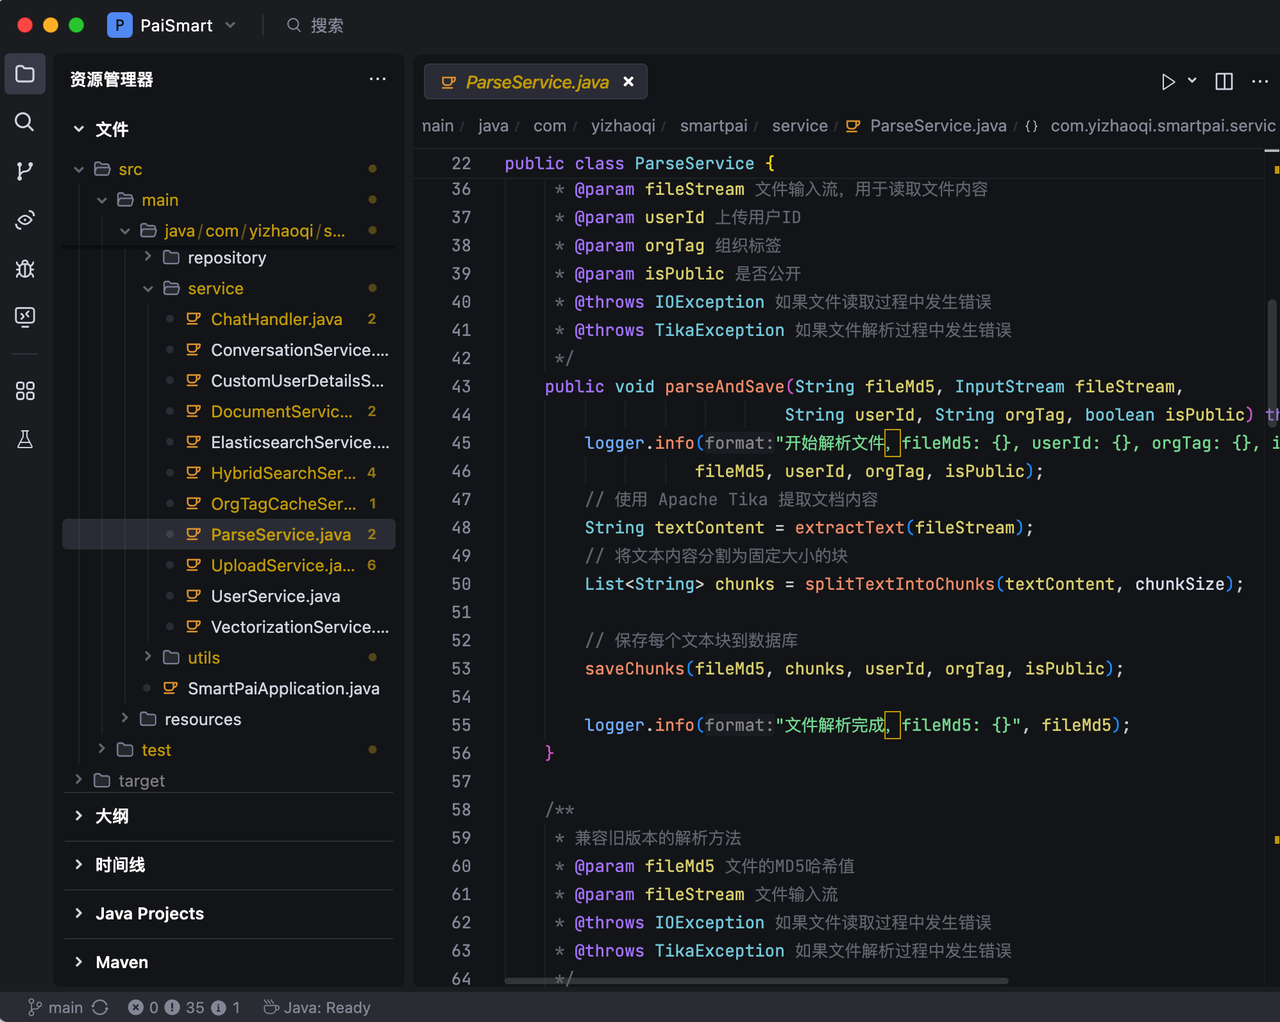
具体来说,系统会使用 Apache Tika 从文档中提取出纯文本信息,然后将长文档智能切分成多个语义完整的文本块。
接下来调用豆包的 Embedding 模型,将文本块转换成 2048 维的向量表示,这些向量能够捕捉文本的深层语义信息。然后,会将所有的向量数据和原始文本存入到 Elasticsearch 中,形成一个强大的知识库索引。
当用户提出问题后,RAG-Agent会通过 ElasticSearch 进行混合检索:先进行语义的向量搜索,再进行关键词的精排。同时,会根据用户的组织权限,自动过滤出用户有权访问的文档内容。
之后,系统会将这些信息作为上下文,连同用户的问题一起发送给 DeepSeek。DeepSeek 会基于我们封装好的 Prompt,生成准确、相关的回答。整个对话过程采用流式输出,用户可以实时看到 AI 的回答过程,体验很流畅。
四、如何给面试官介绍RAG-Agent?
答:
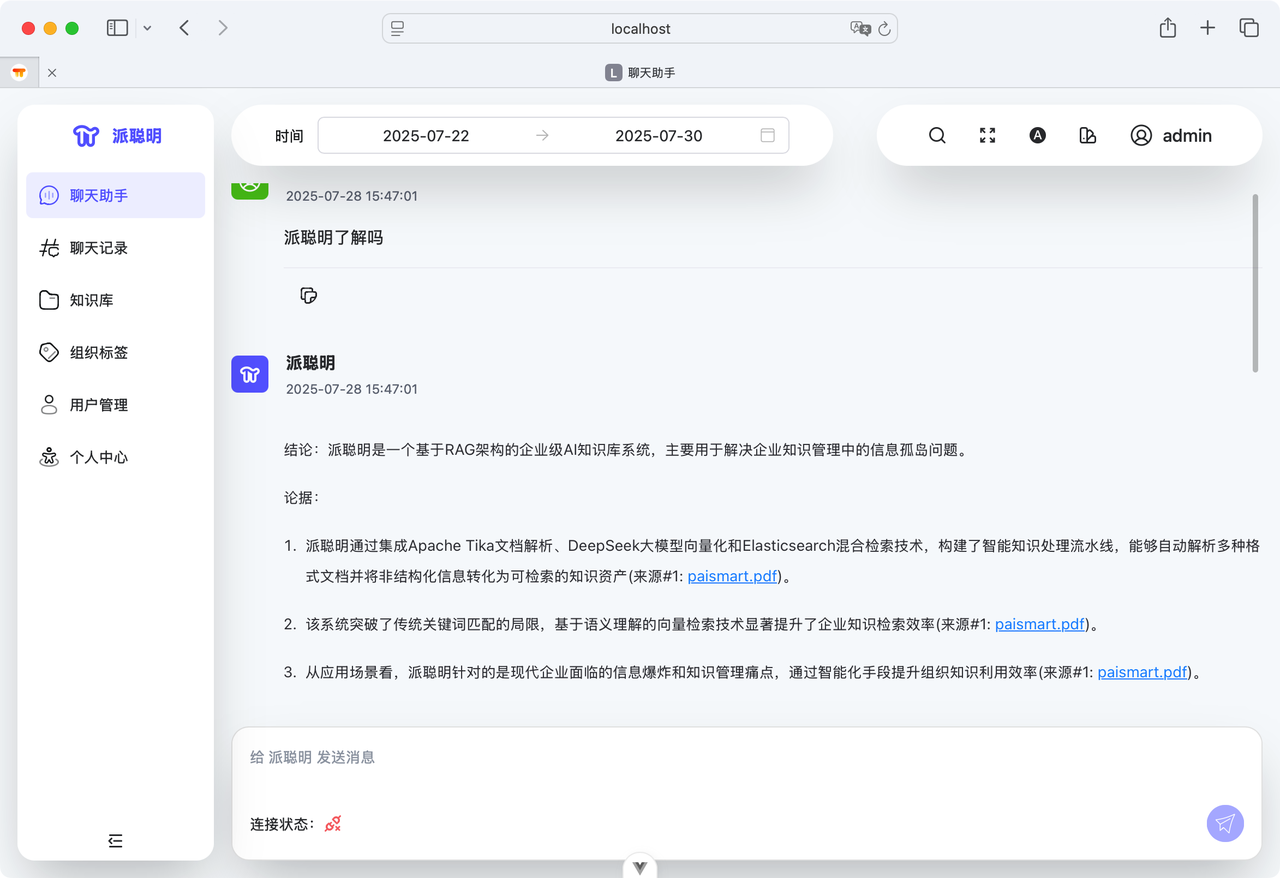
RAG-Agent作为一个基于 RAG 架构的企业级 AI 知识库系统,其核心意义在于解决现代企业知识管理的痛点,推动组织智能化转型。在信息爆炸的时代,企业积累了大量文档资料,但传统的文件管理方式导致知识孤岛现象严重,员工难以快速获取所需信息,严重影响工作效率。
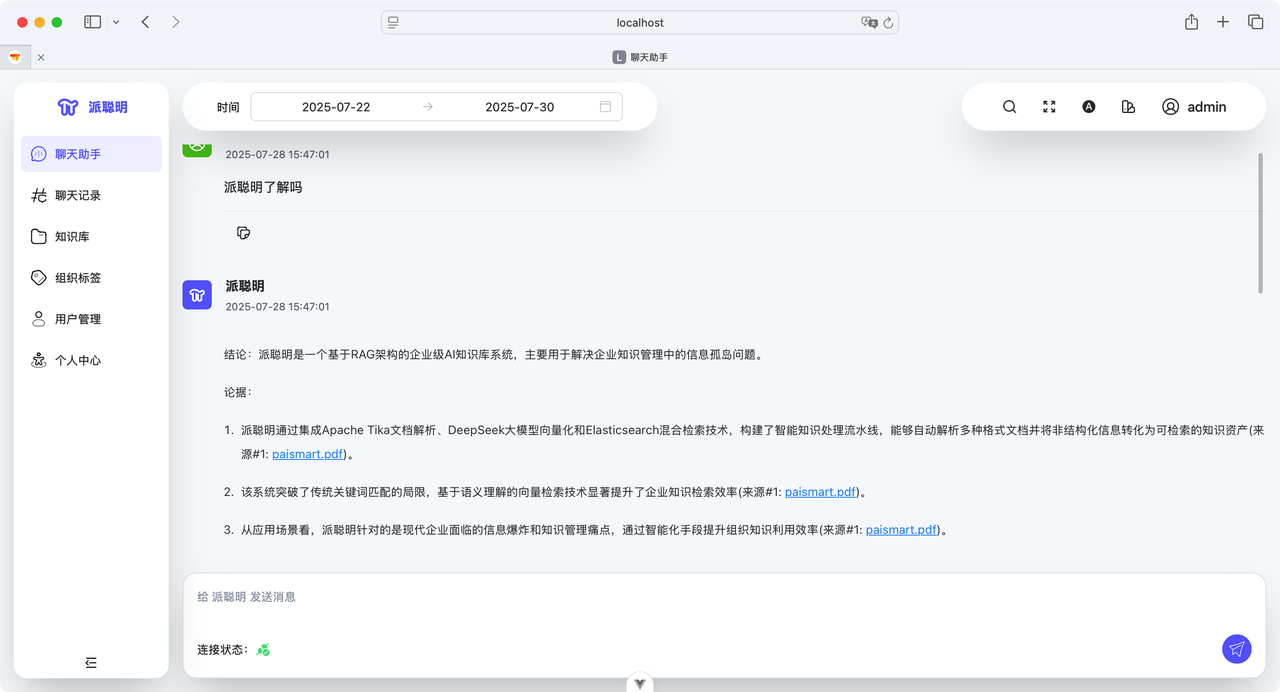
RAG-Agent通过集成 Apache Tika 文档解析、豆包 Embedding 向量模型、Elasticsearch 混合检索技术和 DeepSeek API,构建了一套完整的智能知识处理流水线。
系统能够自动解析 Word、PDF、TXT 等文档,将非结构化信息转化为可检索的知识资产。更重要的是,基于语义理解的向量检索技术突破了传统关键词匹配的局限,用户通过自然语言描述就能够获得要检索的相关内容。
与依赖预训练的模型不同,RAG 能够实时检索最新的企业内部知识,避免模型幻觉,保持回答的准确性。除此之外,RAG-Agent还实现了细粒度的多租户权限控制,确保不同部门和层级的用户只能访问授权范围内的知识。流式的 AI 聊天功也能让知识获取更加自然和高效。
那假如面试官继续追问:你对 RAG 技术了解多少?你可以这样作答。
RAG,也就是检索增强生成,是当前 AI 领域的一项重要技术,它巧妙地结合了信息检索和文本生成两大能力。简单来说,RAG 就是让 AI 在回答问题时,先去”查资料”,然后基于查到的相关信息来生成回答,而不是仅凭训练时的记忆来”凭空想象”。这种方式能有效解决大语言模型的幻觉问题。
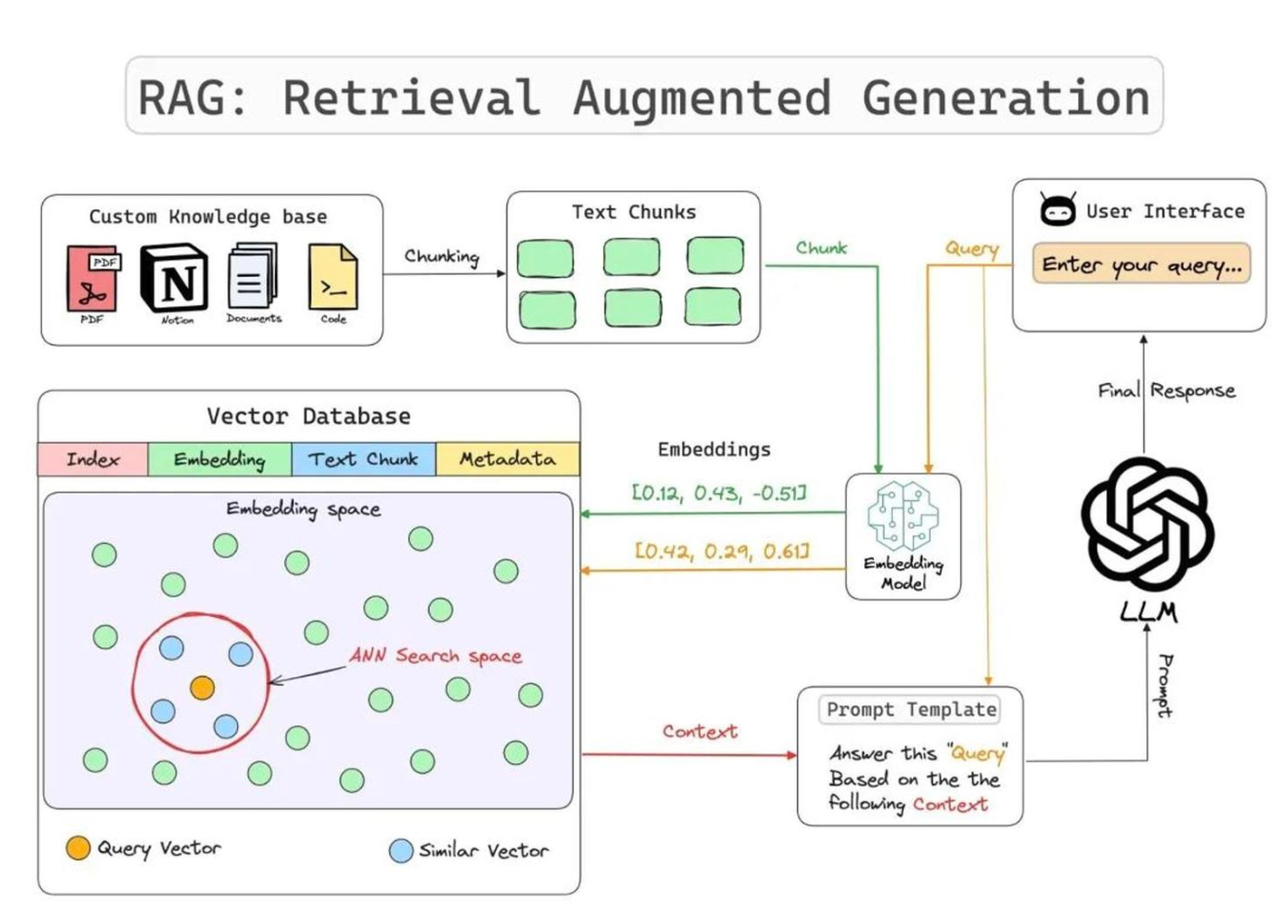
在我参与的RAG-Agent项目中,我们深度实践了 RAG 的技术架构。具体来说,我们的系统分为三个核心环节:
-
首先是知识入库阶段,我们使用 Apache Tika 解析各种格式的企业文档,然后调用豆包的 Embedding 模型将文本转换为向量表示,并存储到 Elasticsearch。
-
其次是检索阶段,当用户提问时,我们同样将问题向量化,然后在 Elasticsearch 中进行混合检索,既包括传统的关键词匹配,也包括基于向量相似度的语义搜索,确保能找到最相关的知识片段。
-
最后是生成阶段,我们将检索到的相关文档作为上下文,连同用户问题一起发送给 DeepSeek,让 AI 基于真实的企业知识来生成准确的回答。
通过RAG-Agent项目的实践,我深刻体会到 RAG 技术的价值所在。它不仅解决了大模型知识更新滞后的问题,更重要的是为企业级 AI 应用提供了可靠的技术路径。这种”有据可查”的 AI 问答方式,让企业用户能够放心地将 RAG 系统应用到实际业务场景中,真正实现 AI 技术的落地。
五、RAG-Agent提供了哪些大模型开发经验?
01、RAG
RAG-Agent最核心的能力就是 RAG,后面还打算增加 MCP 和 Agent 能力,可以说覆盖了整个大模型应用开发的落地经验,并且我们会围绕 RAG 把 AI 相关的一些高频面试题全部讲透。
02、文档上传和解析
如何上传文档?包括断点续传和分片上传。
如何将用户上传的文档转化为可检索的语义向量?
如何通过 ElasticSearch 实现混合检索,包括关键词搜索与语义搜索?
都是 RAG 非常核心的内容模块。
// 文档处理流程:解析 → 分块 → 向量化 → 存储
public void vectorizeFile(MultipartFile file, String userId, String orgTag, boolean isPublic) {
// 1. 文档解析和分块
List<String> chunks = fileParsingService.parseAndChunk(file);
// 2. 批量向量化
List<float[]> vectors = embeddingClient.batchEmbedding(chunks);
// 3. 构建文档对象
List<EsDocument> documents = buildDocuments(chunks, vectors, metadata);
// 4. 批量存储
elasticsearchService.bulkIndex(documents);
}
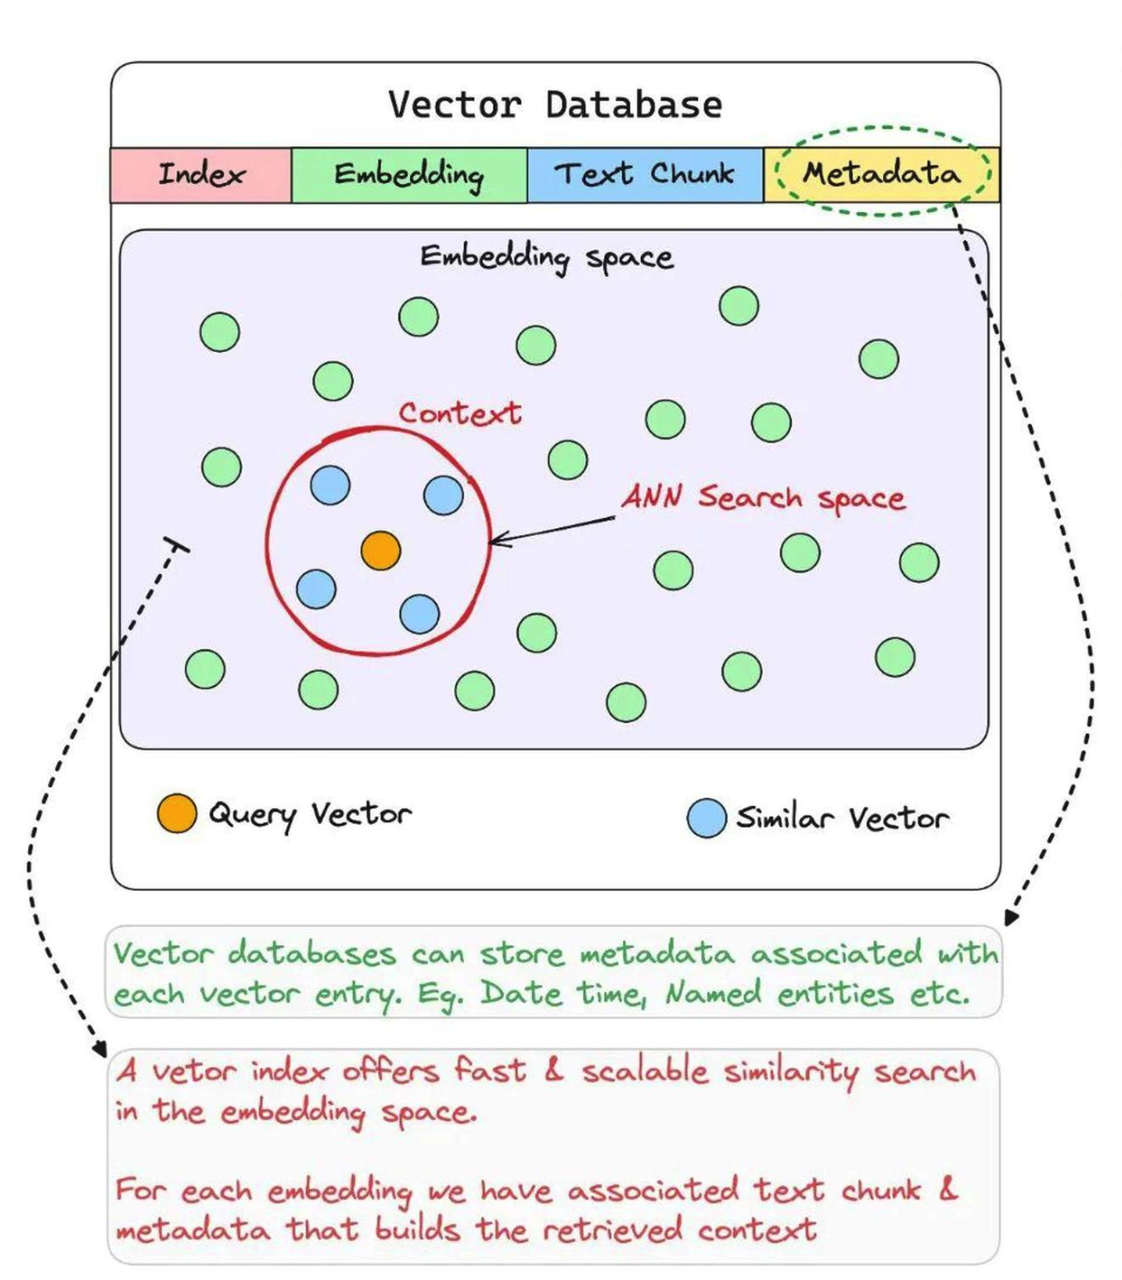
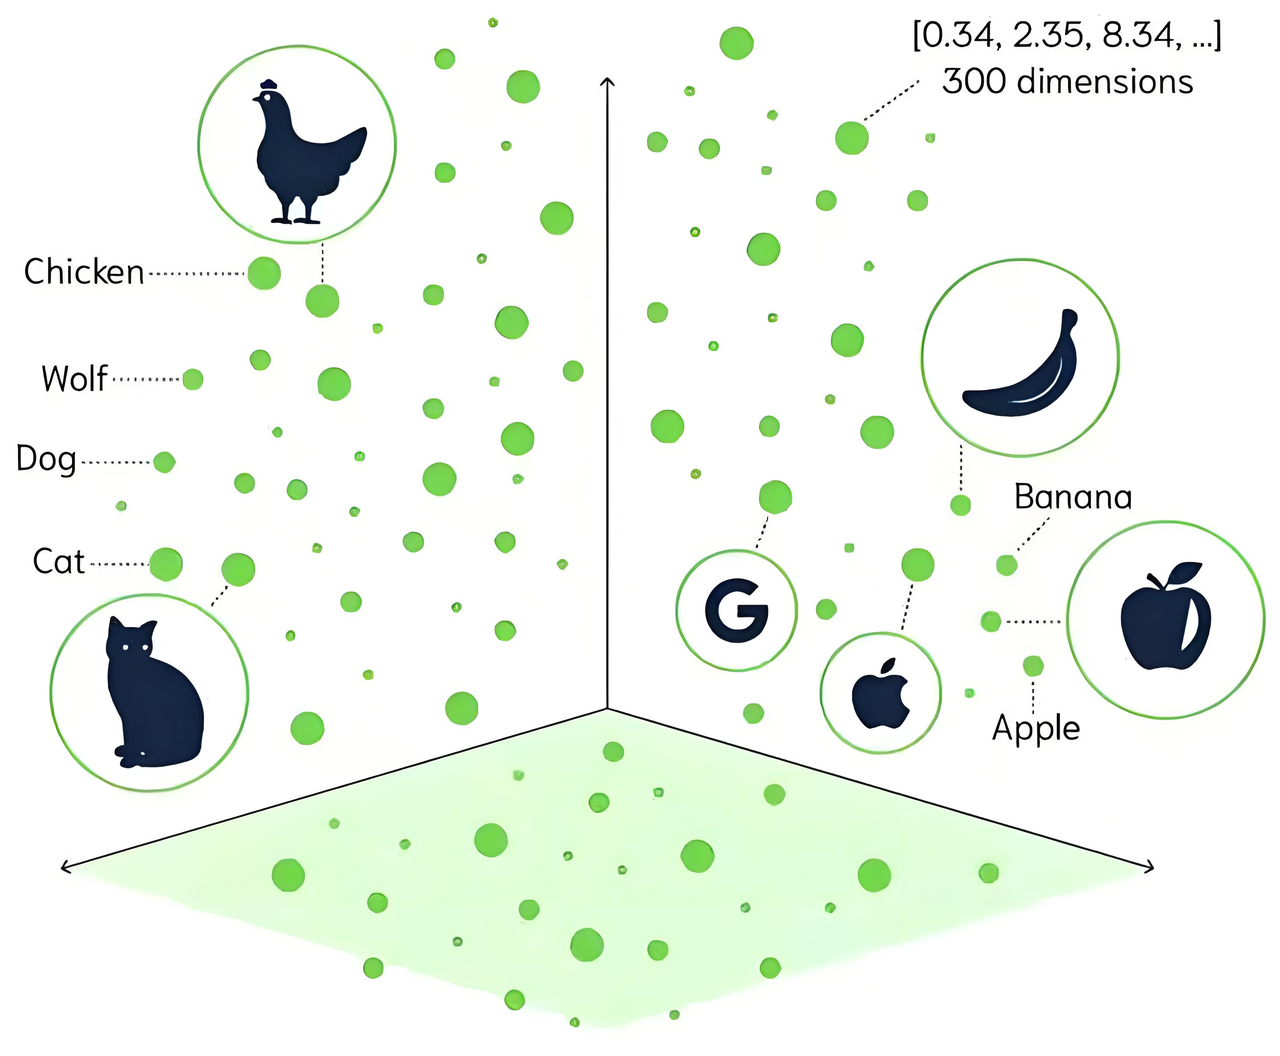
传统的数据库内容查询主要依赖”关键字匹配”,比如说 MySQL 经常用到的 like xxx% ,这种对查询的精确度要求很高,假如我们查询的是”如何提供编程技术”,那么数据库只有”Java、Python 等编程语言的教程”,那么就无法搜索到任何内容。
但向量数据库就可以有效解决这个问题,它会把各种知识都转成一组组数据(vector),这些 vector 可以代表知识的内容和特点,当我们在 RAG 知识库中输入要查找的信息时,系统能将输入信息也转成一组组数据,然后找出最相关的知识,从而实现”语义检索”。
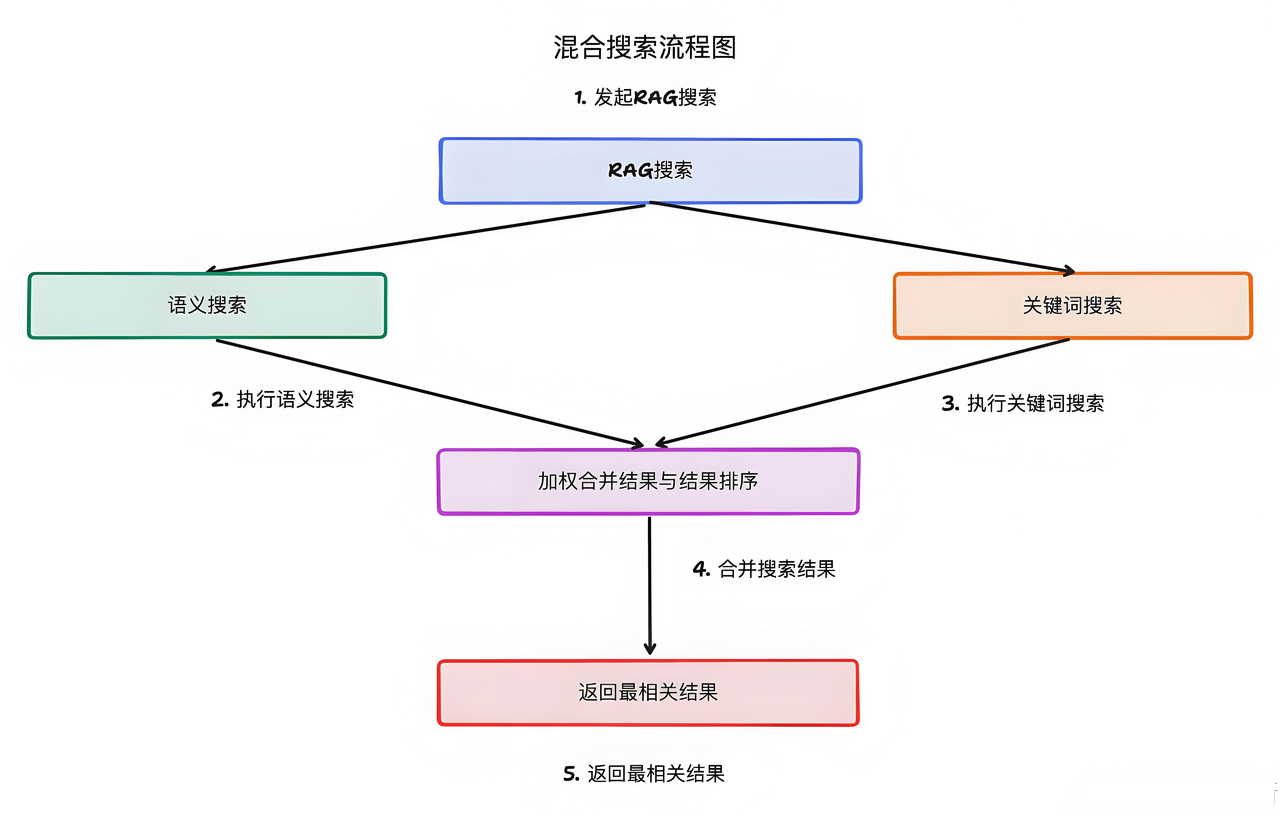
那基于向量知识库的语义检索,虽然解决了传统关键词匹配的局限性,但显然关键词搜索这种场景还是需要的,所以RAG-Agent兼具了关键词检索和语义检索两种能力。
03、集成 DeepSeek 和豆包 Embedding
集成大模型 API 的工程实践,比如说如何集成 DeepSeek,实现流式响应与多轮对话?
如何集成豆包 Embedding 进行文档分块的语义转化?
再比如说如何通过 WebSocket 实现实时通信,逐步推送生成内容?
如何通过 Redis 实现的多轮的对话记忆?
都是 AI 时代非常关键的技术能力。那除了调用 DeepSeek API,我们还支持本地私有的 DeepSeek R1 模型部署。
六、RAG-Agent提供了哪些企业级技术栈?
01、Spring Boot 3.4.2+JDK17
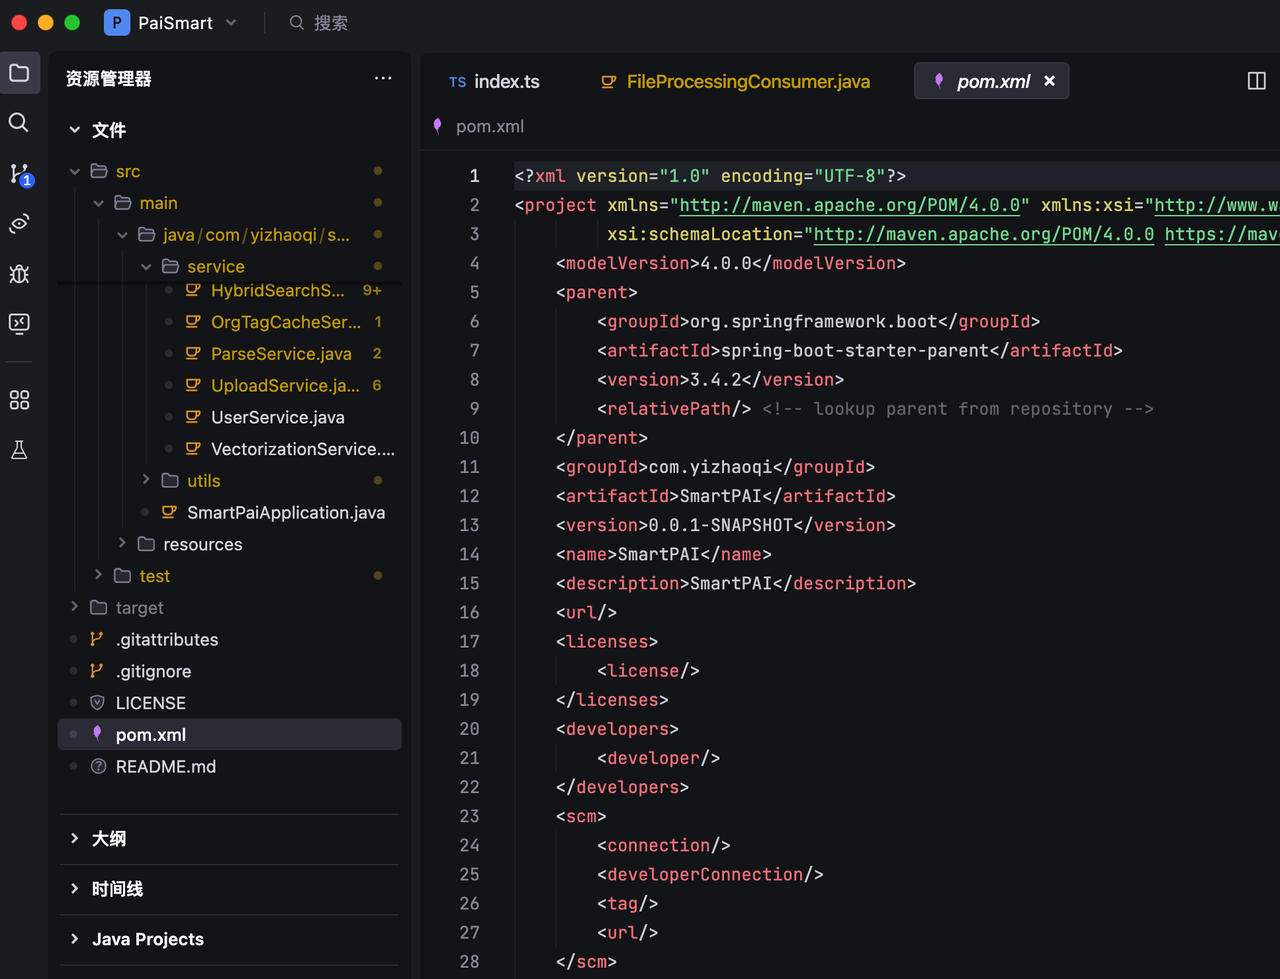
RAG-Agent基于 Spring Boot 3.4.2 版本,使用 Java 17 作为开发语言。
02、Kafka+Redis+MinIO
RAG-Agent通过 Kafka 实现异步任务调度,使用 Redis 缓存优化对话上下文管理,基于 MinIO 实现大文件分片上传与断点续传。
03、ElasticSearch
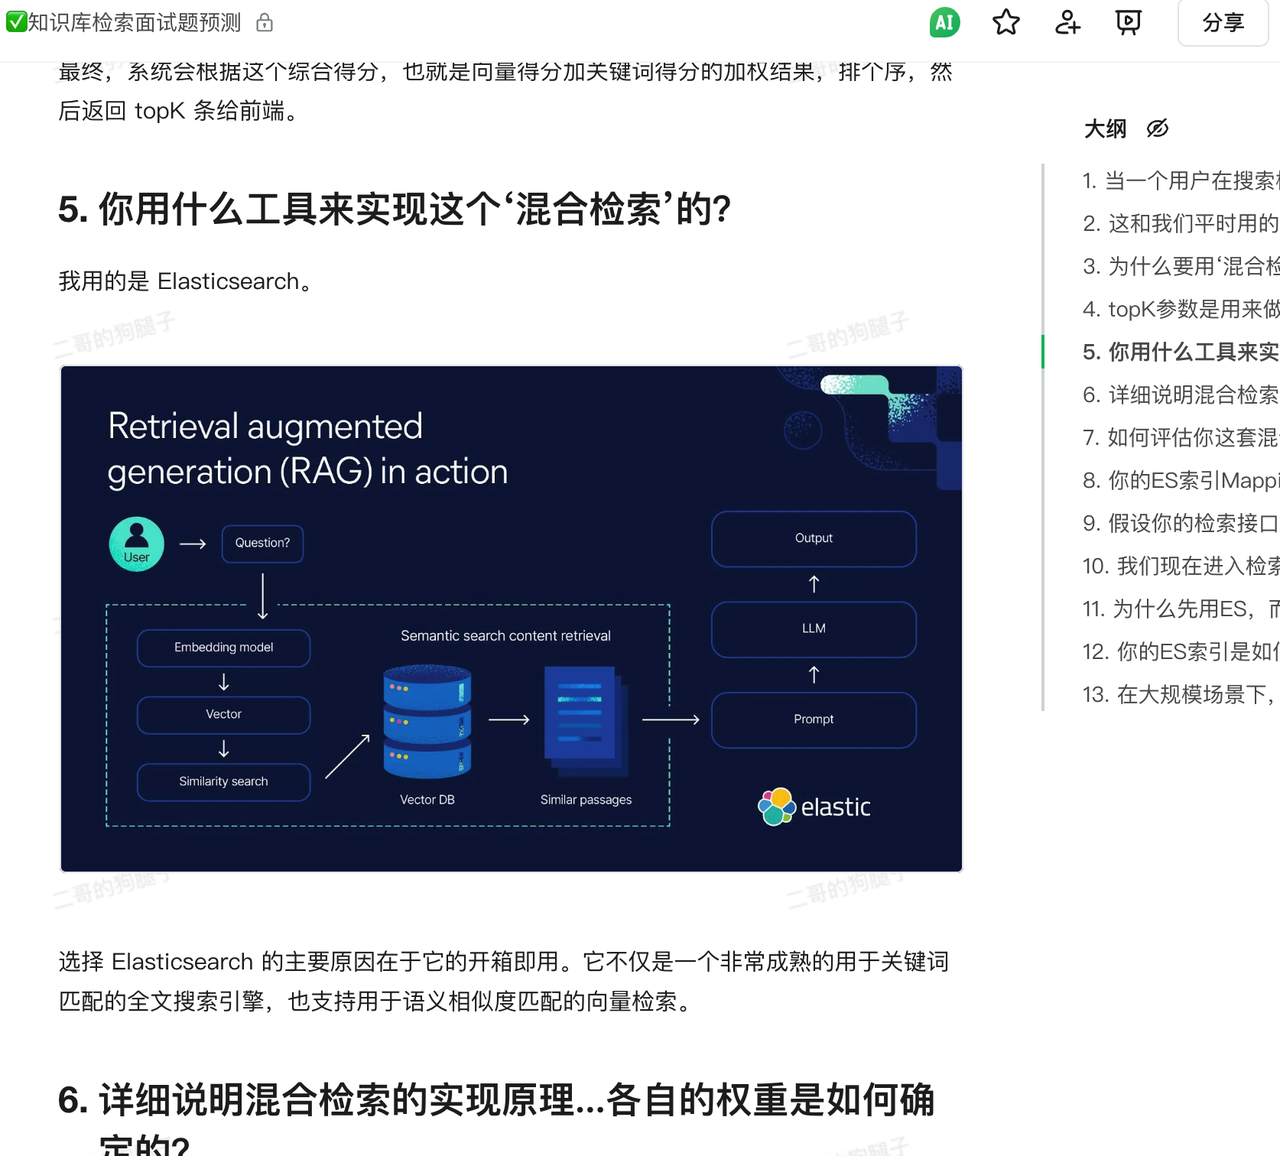
集成 Elasticsearch,实现「关键词+语义」的双引擎搜索。目前已经通过 ES 的 bool should 查询实现了关键词+语义的搜索方式。
04、Vue 3+TypeScript+Vite
RAG-Agent全面采用了 Vue 3 的 Composition API。
状态管理采用了 Pinia 这一 Vue 3 官方推荐的状态管理库,相比 Vuex 具有更好的 TypeScript 支持和更简洁的 API 设计。状态管理的模块包含主题管理(theme)、路由管理(route)、标签页管理(tab)、认证管理(auth)、应用状态(app)等。
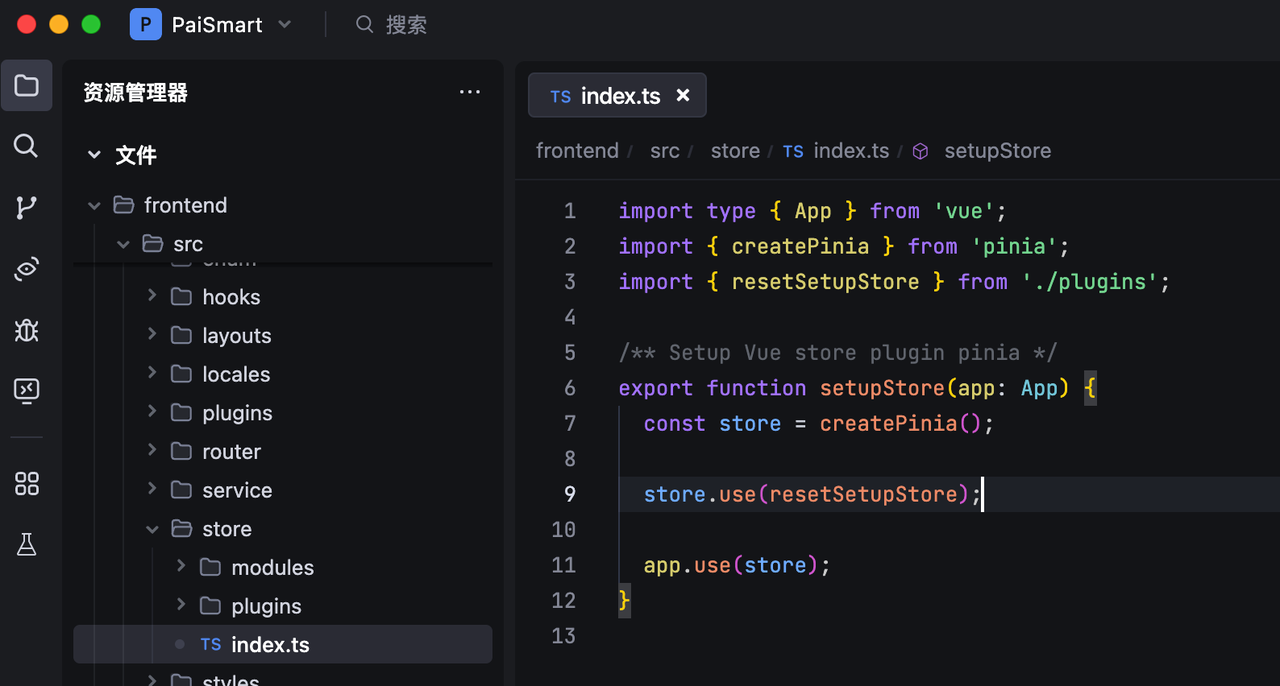
在 vite.config.ts 中,RAG-Agent配置了完整的开发和生产环境构建策略。Vite 的配置支持环境变量加载( loadEnv ),实现了不同环境下的差异化配置,如开发环境的代理设置、生产环境的优化策略等。
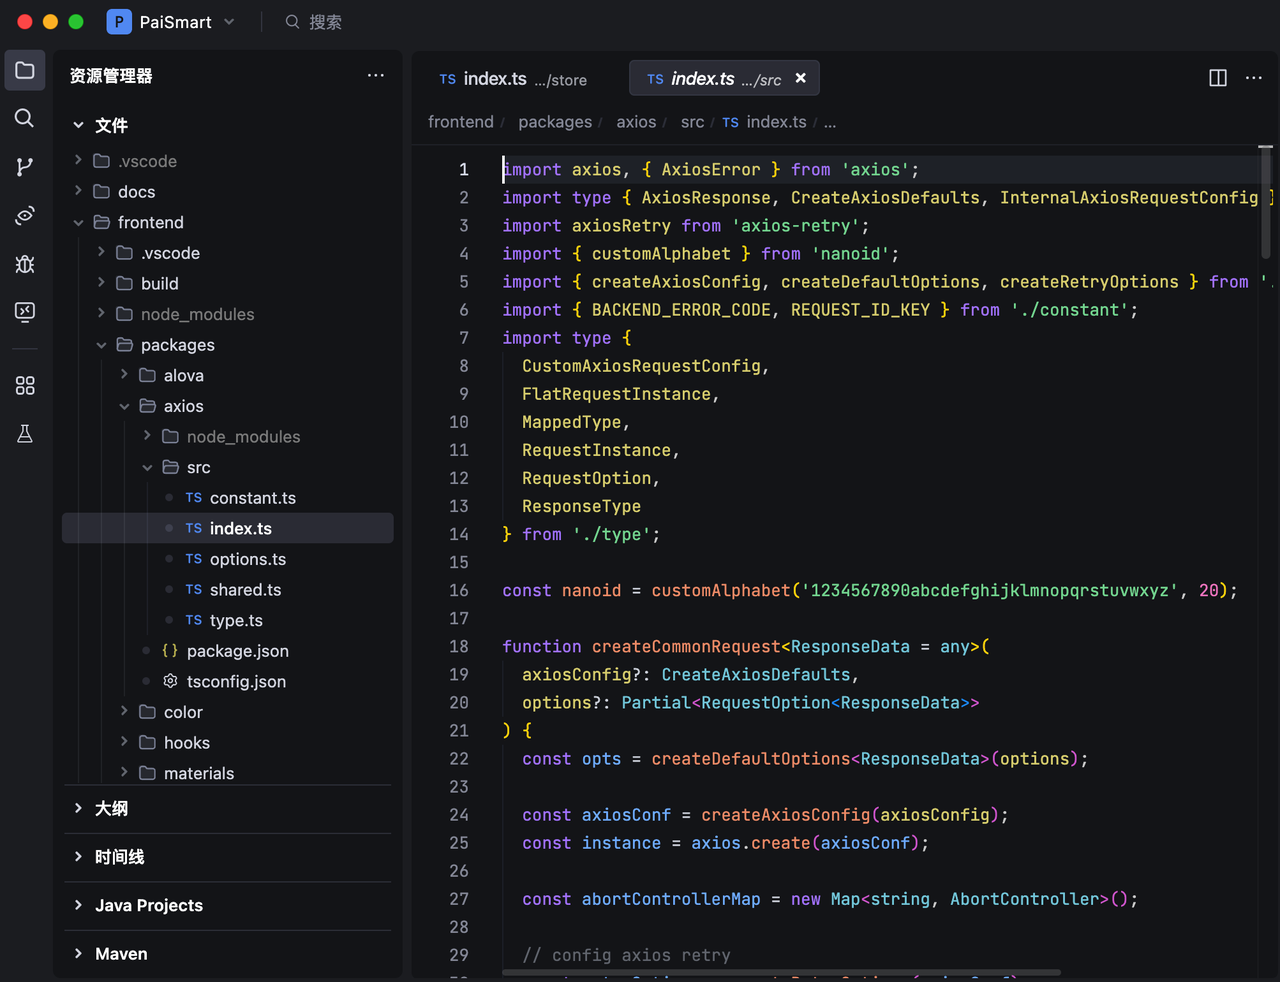
整个前端采用了 Monorepo 架构,在 frontend/packages 目录下组织了多个独立的功能包,包括 axios 封装、颜色工具、hooks 库、UI 组件、工具函数等。特别值得关注的是 index.ts 中的 HTTP 客户端封装,项目基于 axios 实现了企业级的请求库,支持请求/响应拦截、错误处理、请求取消、重试机制等高级功能。
05、JWT+Spring Security+RBAC
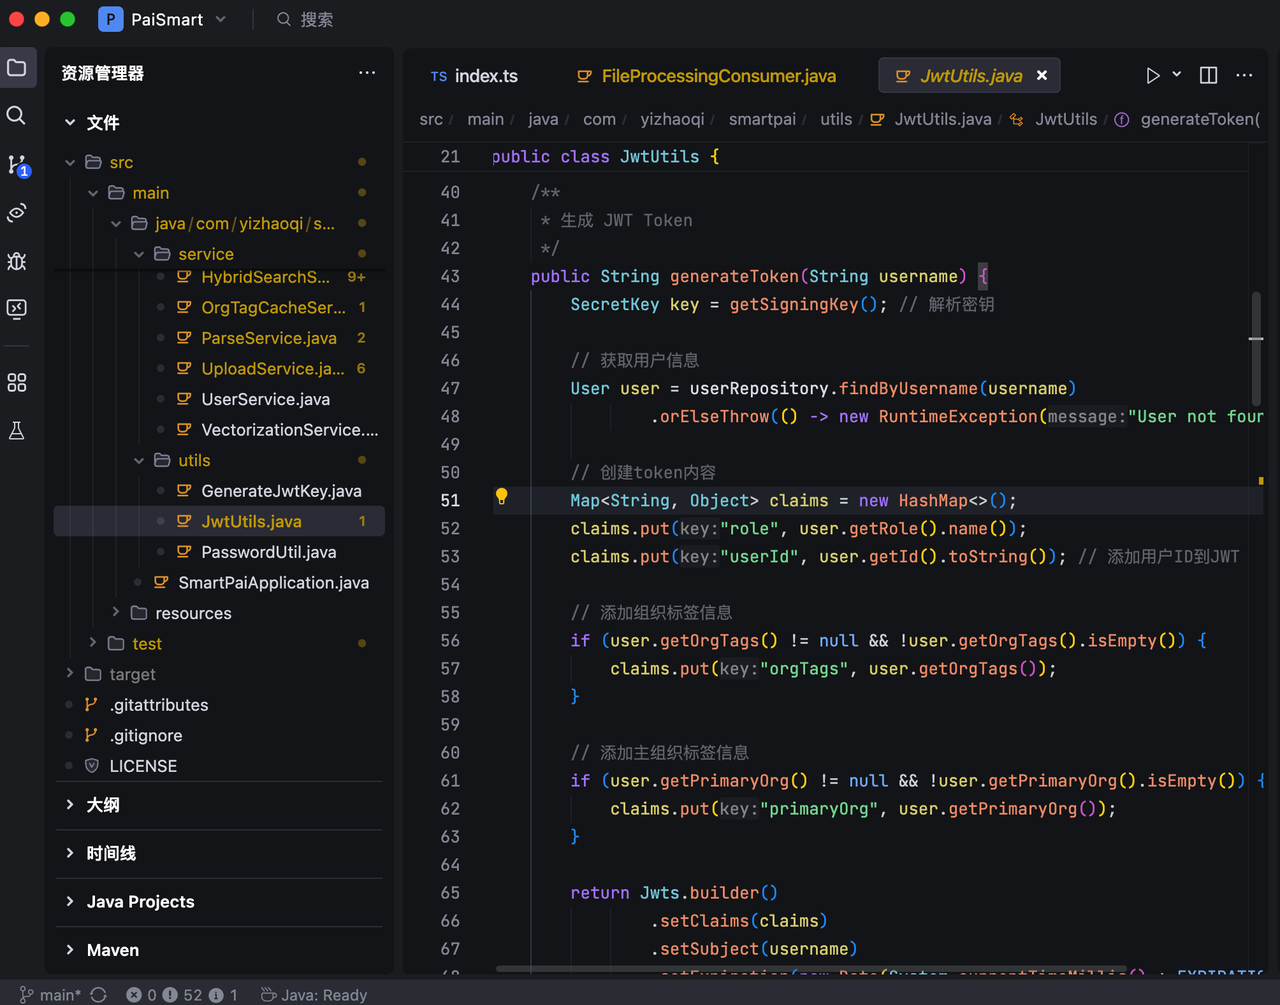
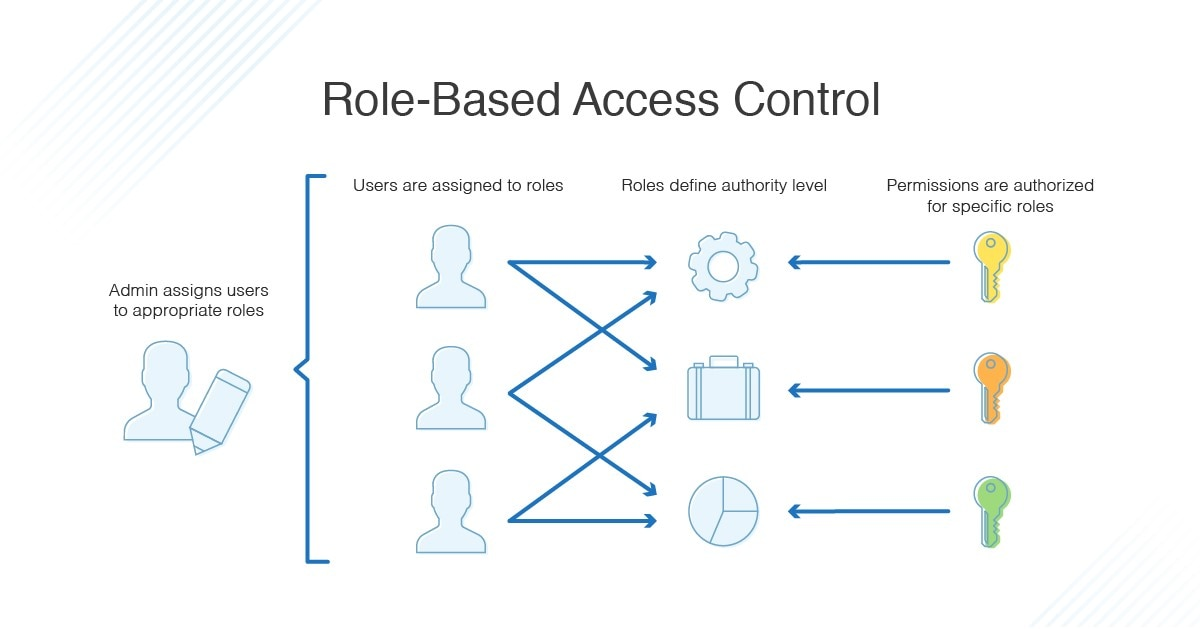
基于 JWT+Spring Security 实现的多租户认证授权体系。当用户登录时,系统会从数据库查询用户信息,然后将用户 ID、角色、组织标签(orgTags)和主组织标签(primaryOrg)等关键信息都打包到 Token 中。
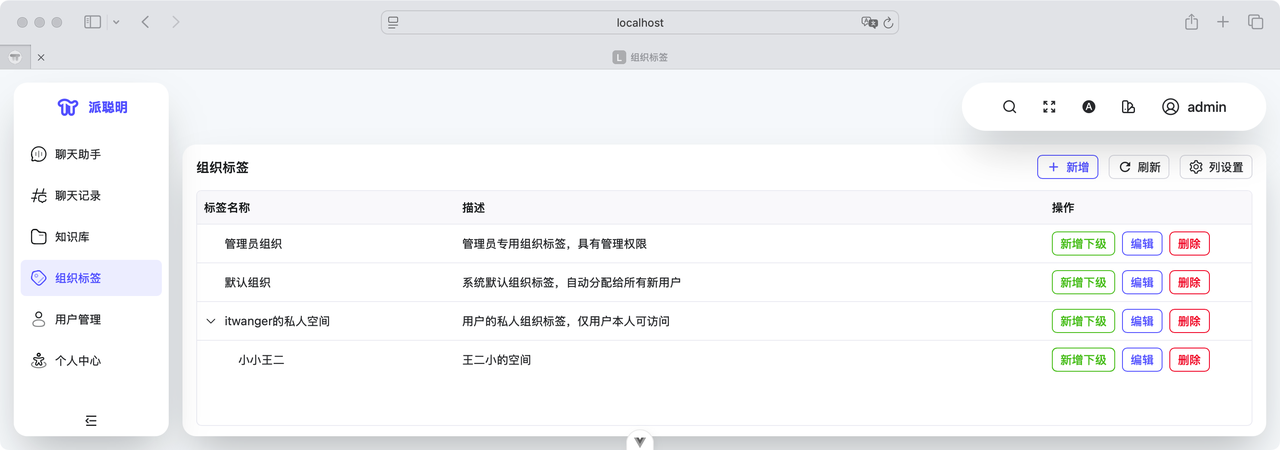
RAG-Agent的多租户权限控制设计了三个层级,非常贴合企业的实际需求。第一层是私人空间权限,以”PRIVATE_“前缀标识的组织标签,只有资源的创建者才能访问,保证用户个人数据的绝对安全。第二层是组织权限,同一个组织标签下的用户可以共享资源,满足团队协作的需求。第三层是公开权限,标记为公开的资源所有用户都能访问,适用于公司公告、共享文档等场景。
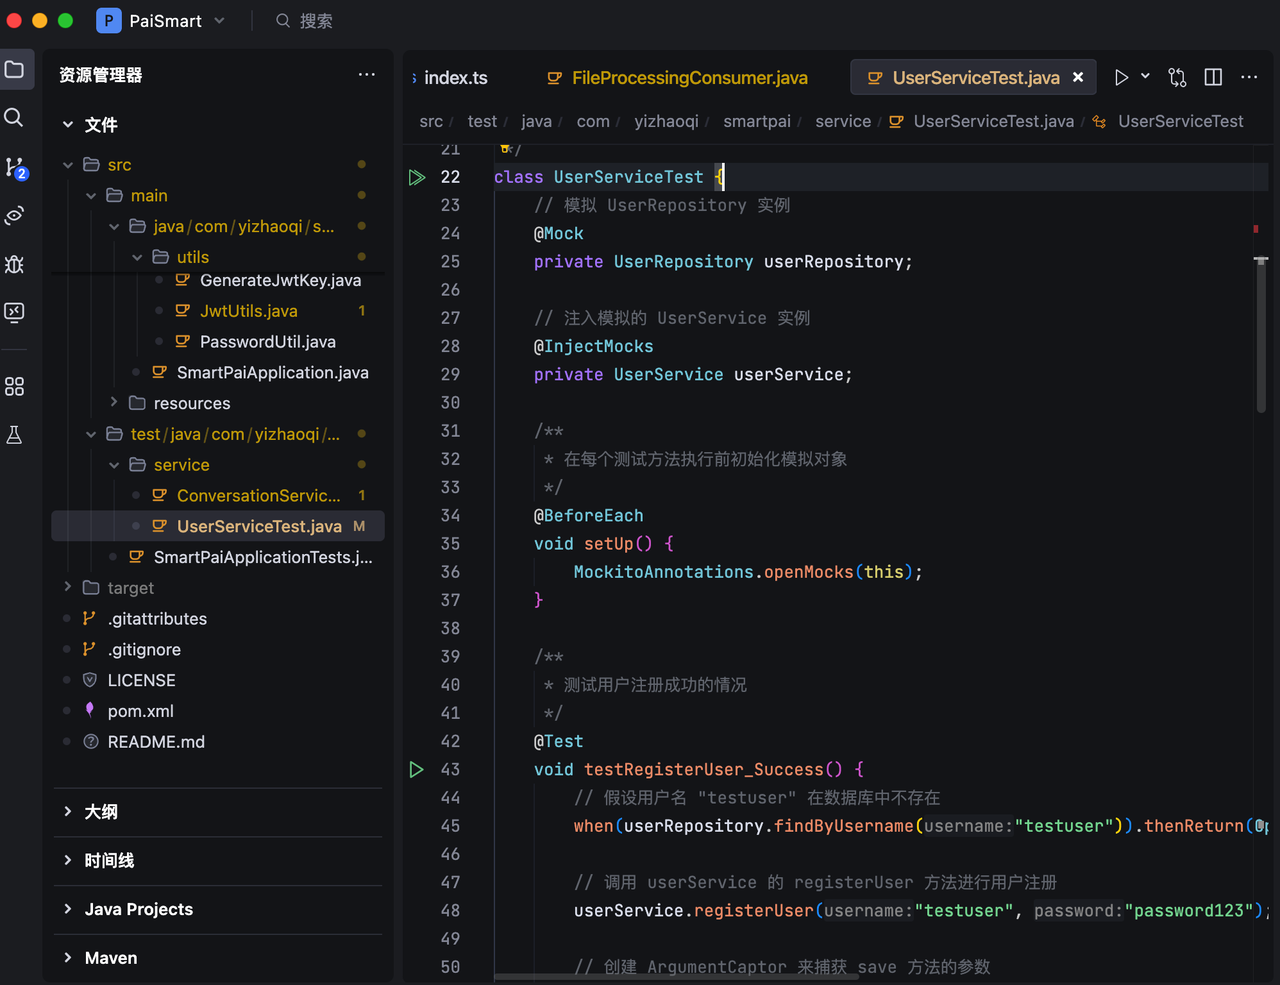
06、Mockito+TDD
项目采用了 Mockito 注解驱动的测试模式,践行测试驱动开发(TDD)的理念,每个业务功能都有对应的测试用例,包括正常流程和异常流程。通过 @Mock 注解创建模拟对象,比如 UserRepository,这样就不需要真实的数据库连接, @InjectMocks 注解则自动将模拟对象注入到被测试的服务类当中,这种依赖注入的方式让测试变得非常干净和独立。