知识库检索模块是 RAG-Agent 的核心功能。它基于 Elasticsearch 实现文档混合检索,将语义检索和关键词检索结果结合起来,为用户提供更高质量的搜索体验。
该模块依赖于文件上传与解析模块完成的向量化处理,直接使用存储在 Elasticsearch 中的向量数据进行检索。系统目前使用豆包 API 生成文本向量,并将向量存储在 Elasticsearch 中。
模块整体分为两大块:
①、知识库检索
-
混合检索:结合语义检索和关键词检索结果,按权重排序返回搜索结果
-
支持指定返回结果数量:通过 topK 参数控制结果数量
②、权限控制
-
基于组织标签的数据权限:确保用户只能访问有权限的文档
-
支持层级权限验证 :父标签权限自动包含所有子标签文档的访问权限
-
默认标签全局可访问:DEFAULT 标签资源对所有用户开放
用到的技术栈包括:
| 功能模块 | 技术选型 | 备注 |
|---|---|---|
| 全文检索 | Elasticsearch | 第一阶段,使用IK分词器 |
| 向量检索 | Elasticsearch | 第一阶段,使用dense_vector类型 |
| 向量检索 | FAISS | 第二阶段,提供更高性能的向量检索 |
| 缓存 | Redis | 缓存热点查询结果 |
| 数据库 | MySQL | 存储元数据 |
| 对象存储 | MinIO | 存储文档文件 |
整体流程如下:
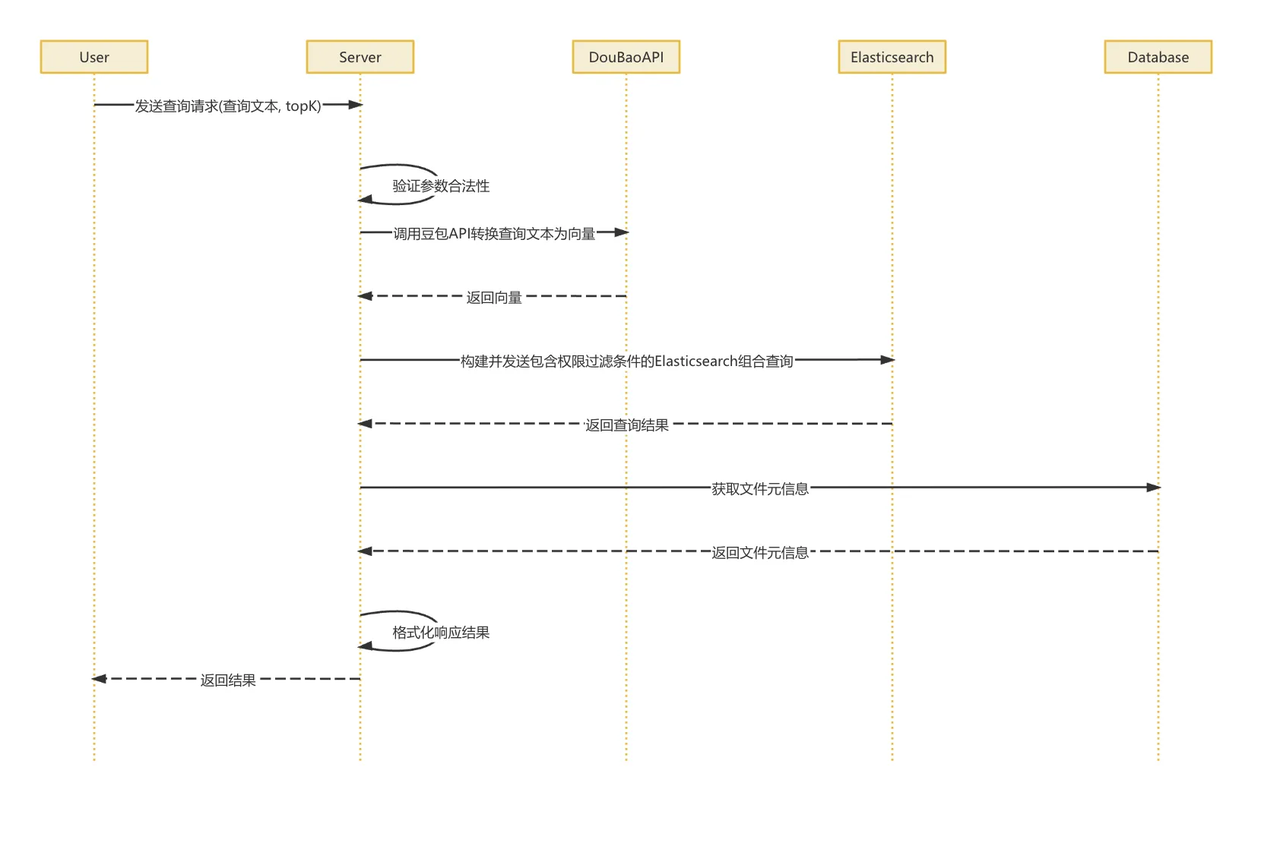
用户发起查询后,系统会接收查询文本、相关检索参数和需要返回的结果数量(topK),并先校验这些参数,确认格式正确、数据合理。
接着,系统会调用豆包提供的向量化 API,将查询文本转换为可用于向量检索的表示,为后续语义匹配打好基础。
获得查询向量后,系统会执行结合语义匹配和关键词匹配的混合检索。
在这一步,系统会构建一个 Elasticsearch 的查询语句,这个查询不仅包含了向量相似度的计算,还会结合全文搜索的匹配结果。同时,我们还会在查询中加入权限相关的过滤条件,确保用户只能看到自己“有权访问”的内容。
具体来说,权限控制主要分为三条规则:
1.        用户可以访问自己上传的文档;
2.        用户可以访问被标记为公开的文档;
3.        如果某些文档被打上了特定的权限标签(比如部门或层级权限),只要用户拥有这些标签,也可以访问这些文档。
带着这些权限条件,系统将完整的查询请求发送给 Elasticsearch,并基于设定好的策略对搜索结果进行打分,综合评估文本的相关性与权限匹配度。
最后,系统根据 topK 参数选出排名靠前的文档,再从数据库中获取标题、作者、上传时间等元数据。完成格式化后,系统会将这些内容打包成响应结果并返回给用户。
一、依赖的数据结构
01、MySQL表结构
document_vectors 表:
| 字段名 | 类型 | 描述 |
|---|---|---|
| vector_id | BIGINT AUTO_INCREMENT | 主键,自增ID |
| file_md5 | CHAR(32) | 文件指纹,用于关联file_upload表 |
| chunk_id | INT | 文本分块序号 |
| text_content | LONGTEXT | 原始文本内容 |
| model_version | VARCHAR(32) | 生成向量所使用的模型版本 |
建表语句:
-- 创建file_upload表
CREATE TABLE `file_upload` (
  `file_md5` CHAR(32) PRIMARY KEY COMMENT '文件指纹',
  `file_name` VARCHAR(255) NOT NULL COMMENT '文件名',
  `total_size` BIGINT UNSIGNED NOT NULL COMMENT '文件大小(字节数)',
  `status` TINYINT(1) NOT NULL COMMENT '文件状态',
  `user_id` VARCHAR(64) NOT NULL COMMENT '用户标识',
  `created_at` DATETIME DEFAULT CURRENT_TIMESTAMP COMMENT '文件创建时间',
  `merged_at` DATETIME COMMENT '文件合并完成时间',
  INDEX `idx_user_id` (`user_id`),
  INDEX `idx_status` (`status`),
  INDEX `idx_created_at` (`created_at`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci COMMENT='文件上传信息表';
file_upload 表:
| 字段名 | 类型 | 描述 |
|---|---|---|
| file_md5 | CHAR(32) PRIMARY KEY | 文件指纹 |
| file_name | VARCHAR(255) | 文件名 |
| total_size | BIGINT UNSIGNED | 文件大小(字节数) |
| status | TINYINT(1) | 文件状态 |
| status | TINYINT(1) | 文件状态 |
|---|---|---|
| user_id | VARCHAR(64) | 用户标识 |
| created_at | DATETIME DEFAULT CURRENT_TIMESTAMP | 文件创建时间 |
| merged_at | DATETIME | 文件合并完成时间 |
建表语句:
-- 创建document_vectors表
CREATE TABLE `document_vectors` (
  `vector_id` BIGINT NOT NULL AUTO_INCREMENT PRIMARY KEY COMMENT '主键,自增ID',
  `file_md5` CHAR(32) NOT NULL COMMENT '文件指纹,用于关联file_upload表',
  `chunk_id` INT NOT NULL COMMENT '文本分块序号',
  `text_content` LONGTEXT NOT NULL COMMENT '原始文本内容',
  `model_version` VARCHAR(32) NOT NULL COMMENT '生成向量所使用的模型版本',
  INDEX `idx_file_md5` (`file_md5`),
  INDEX `idx_file_chunk` (`file_md5`, `chunk_id`),
  INDEX `idx_model_version` (`model_version`),
  CONSTRAINT `fk_document_vectors_file` FOREIGN KEY (`file_md5`) REFERENCES `file_upload` (`file_md5`) ON DELETE CASCADE ON UPDATE CASCADE
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci COMMENT='文档向量存储表';
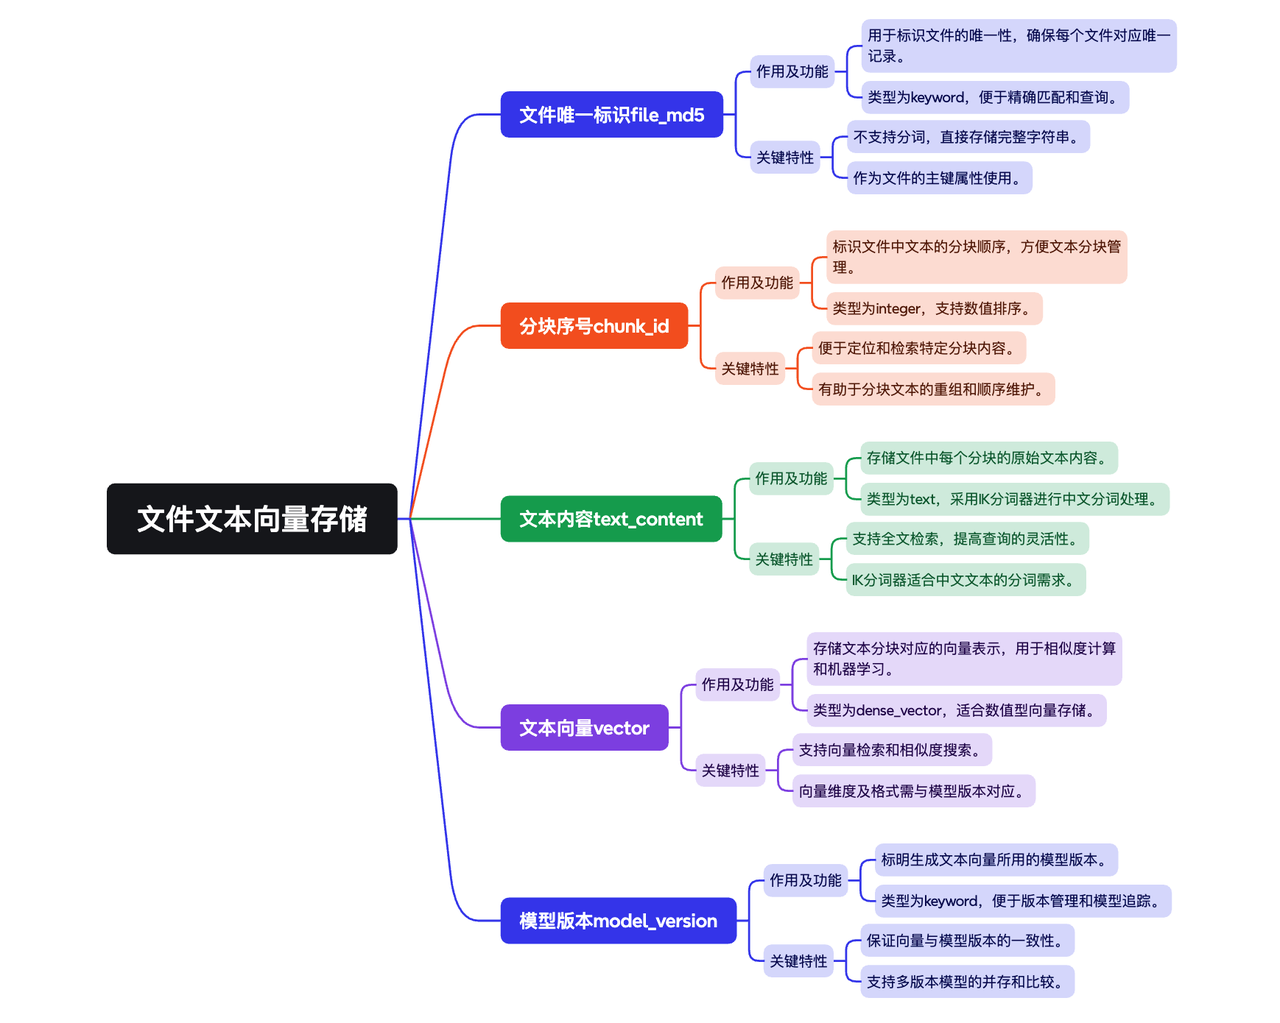
02、Elasticsearch索引结构
二、接口设计
01、 混合搜索接口
-
URL:
/api/search/hybrid -
Method: GET
-
Parameters:
-
query: 搜索查询字符串(必需)
-
topK: 返回结果数量(可选,默认10)
-
示例:/api/search/hybrid?query=沉默王二是沙雕&topK=10
- Response:
[
  {
    "file_md5": "abc123...",
    "chunk_id": 1,
    "text_content": "沉默王二确实是沙雕,你说的没错。",
    "score": 0.92,
    "file_name": "paismart.pdf"
  },
  // ...更多结果
]
02、文档删除接口
-
URL:
/api/documents/{file_md5} -
Method: DELETE
-
Path Parameters:
file_md5: 要删除的文件唯一标识(MD5值)
-
Headers:
Authorization: Bearer {token} (用于身份验证)
-
Response:
- 成功响应:
{
  "status": "success",
  "message": "文档删除成功"
}- 文档不存在:
{
  "status": "error",
  "message": "文档不存在"
}- 权限不足:
{
  "status": "error",
  "message": "没有权限删除此文档"
}- 服务器错误:
{
  "status": "error",
  "message": "删除文档失败: 详细错误信息"
}
三、RAG-Agent发展阶段
第一阶段:Elasticsearch支持全文检索和向量检索
在当前阶段,RAG-Agent系统基于 Elasticsearch 的强大功能,成功集成了两种主要的检索能力: 全文检索和 向量检索,并实现了它们的高效融合。
首先,在全文检索方面,我们借助 Elasticsearch 强大的文本索引能力,配合 IK 分词器,实现了对中文内容的高效支持。系统会对文档中的 text_content 字段进行索引和匹配,用户输入的关键词可以被准确地分词并检索到相关内容,实现了类百度式的文本搜索体验。
其次,在语义检索方面,我们利用了 Elasticsearch 7.x 及以上版本对 dense_vector 类型的支持。通过脚本打分机制,系统可以根据用户查询向量与文档中 vector 字段之间的相似度进行排序,从而实现更“懂你”的语义匹配能力。这种方式特别适合处理用户提出的自然语言查询,比如问题或句子。
更进一步的是,系统还实现了 混合检索,也就是说:在一次查询请求中,既能进行关键词匹配(全文检索),又能做语义相似度计算(向量检索)。通过设置内部权重,我们可以灵活地调节两种检索方式对最终结果的影响,实现更加精准和个性化的排序。同时,由于是单次请求发往 Elasticsearch,不仅减少了网络延迟,也降低了整体的系统复杂度。
这样的架构设计带来了不少优势:
-
使用 Elasticsearch 作为统一的底层引擎,架构非常简单;
-
运维成本低,不需要额外引入复杂的向量数据库;
-
混合检索实现路径清晰,开发迭代效率高。
不过我们也清楚地认识到这套方案的局限性:
-
向量检索的性能瓶颈明显,难以支撑大规模向量数据的快速检索;
-
尤其在并发访问量大时,内存和计算资源消耗较高;
-
随着数据规模的扩大,整体的检索响应时间也会变长,用户体验可能受到影响。
因此,这套基于 Elasticsearch 的混合检索方案,适合用在中小规模场景,或者对检索实时性要求不是特别高的业务。在后续系统演进中,我们也会评估是否引入更专业的向量检索引擎(如 Faiss)以进一步提升性能。
第二阶段:集成FAISS提升向量检索性能
为进一步提升系统在大规模语义检索场景下的性能和扩展能力,RAG-Agent系统计划在未来阶段引入专用的向量检索引擎 —— FAISS。该优化将以“职责分离 + 双引擎协同”的方式进行,目的是在保持当前功能不变的前提下,实现更专业、更高性能的向量计算能力。
在新架构中,我们将对检索功能进行明确分工:
-
Elasticsearch继续承担全文检索和文档元信息存储的职责,利用其成熟的文本索引和过滤能力;
-
FAISS专注处理高维向量相似度计算,发挥其在大规模向量数据处理中的优势,如快速 TopK 检索、向量压缩等。
通过这样的分工,可以充分发挥两个引擎的专长,避免性能瓶颈。为保障系统可维护性与扩展性,未来的检索架构将做如下优化:
-
双引擎协同处理:系统将建立 Elasticsearch 与 FAISS 之间的数据同步机制,实现向量和文本数据的实时协同;
-
抽象检索接口设计:通过统一的检索接口屏蔽底层实现,便于根据不同场景灵活切换检索引擎;
-
接口稳定性保障:对外暴露的 API 接口保持不变,确保上层业务系统无需感知底层技术变更,降低改动风险。
引入 FAISS 之后,系统整体性能将有显著提升,主要体现在以下几个方面:
-
检索速度更快:向量检索响应时间从原本的百毫秒级优化到毫秒级;
-
系统吞吐能力增强:支持更高并发访问,QPS 预计可提升 5~10 倍;
-
资源利用更优:FAISS 支持高效的内存结构和向量压缩算法,可显著降低内存和 CPU 占用,提升整体资源利用率。
为确保切换过程平滑、用户无感知,RAG-Agent计划采用以下渐进式部署策略:
-
阶段一: 数据双写,在保证 Elasticsearch 正常工作的基础上,同时将向量数据写入 FAISS,验证同步稳定性(~~这一条其实也可以写到简历上~~)。
-
阶段二: 灰度发布,逐步放量部分检索流量至 FAISS 路径,进行性能对比和业务验证,确保兼容性无问题。
-
阶段三: 全面切换,验证稳定后,正式将向量检索请求切换到 FAISS,完成最终替换。