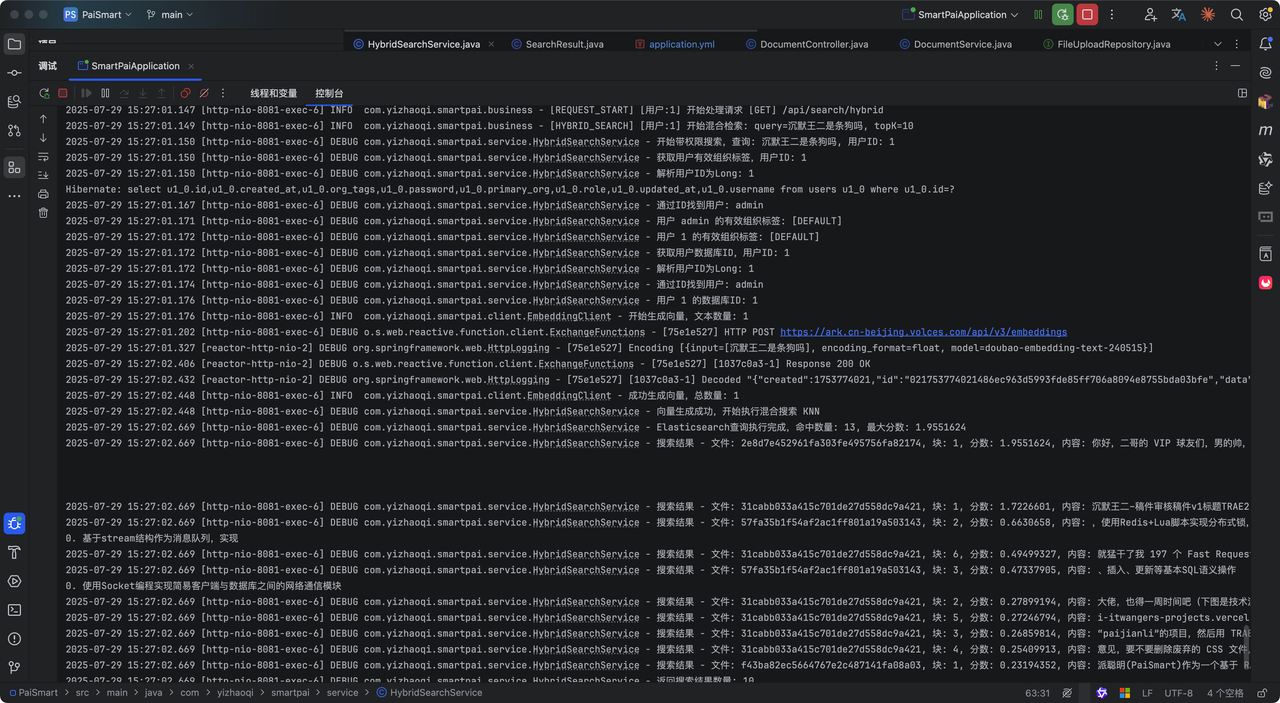
今天我们一起学习 RAG-Agent 的核心功能之一——混合检索。我会逐步讲解 RAG-Agent 如何结合“关键词搜索”和“语义搜索”,实现 RAG 中关键的 Retrieval。
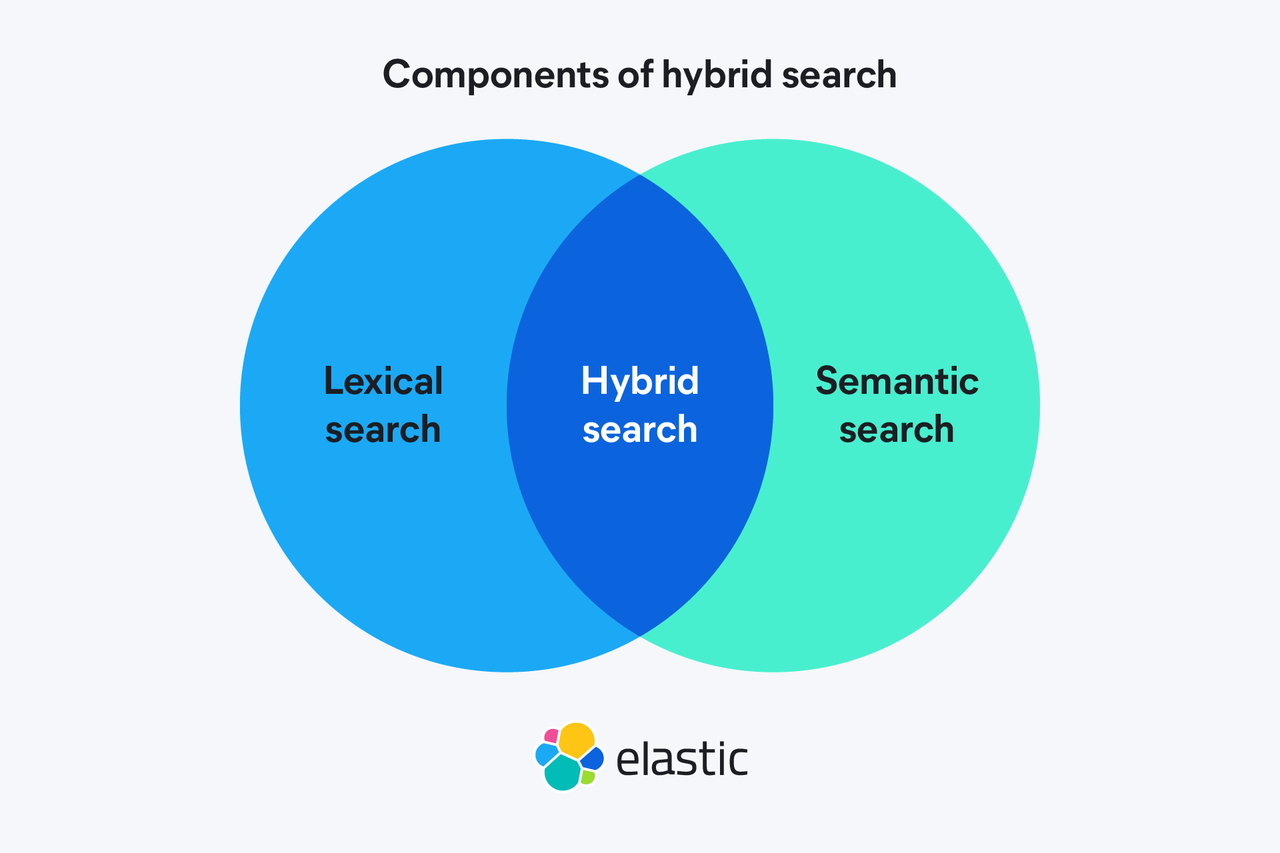
一、关键词搜索和语义搜索
先说明为什么需要组合搜索技术,以及关键词搜索和语义搜索分别是什么。
关键词搜索需要将文档和查询都拆解成一个个独立的词语,然后通过匹配这些词语来计算相关性。依赖于一种名为“倒排索引”的数据结构,可以瞬间找到包含特定关键词的所有文档。
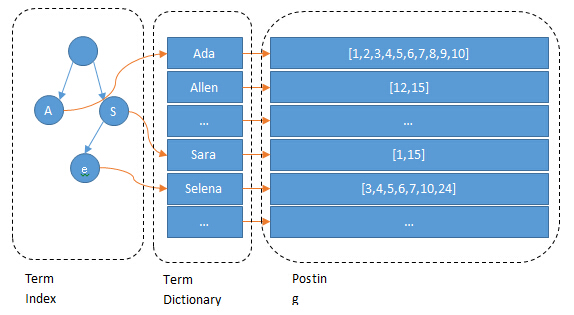
在没有搜索引擎时,搜索内容大致是这样:打开网址、获取网站内容,再输入关键词进行匹配:
document -> to -> words从文章中提取关键词,这就是所谓的“正向索引”,英文名为 forward index。
后来,我们希望输入一个关键词,找到含有这个关键词的有关文章:
word -> to -> documents我们把这种索引,称为 inverted index,直译过来叫反向索引,国内习惯翻译成“倒排索引”。
例如,技术派首页就用 ES 实现过倒排查询。
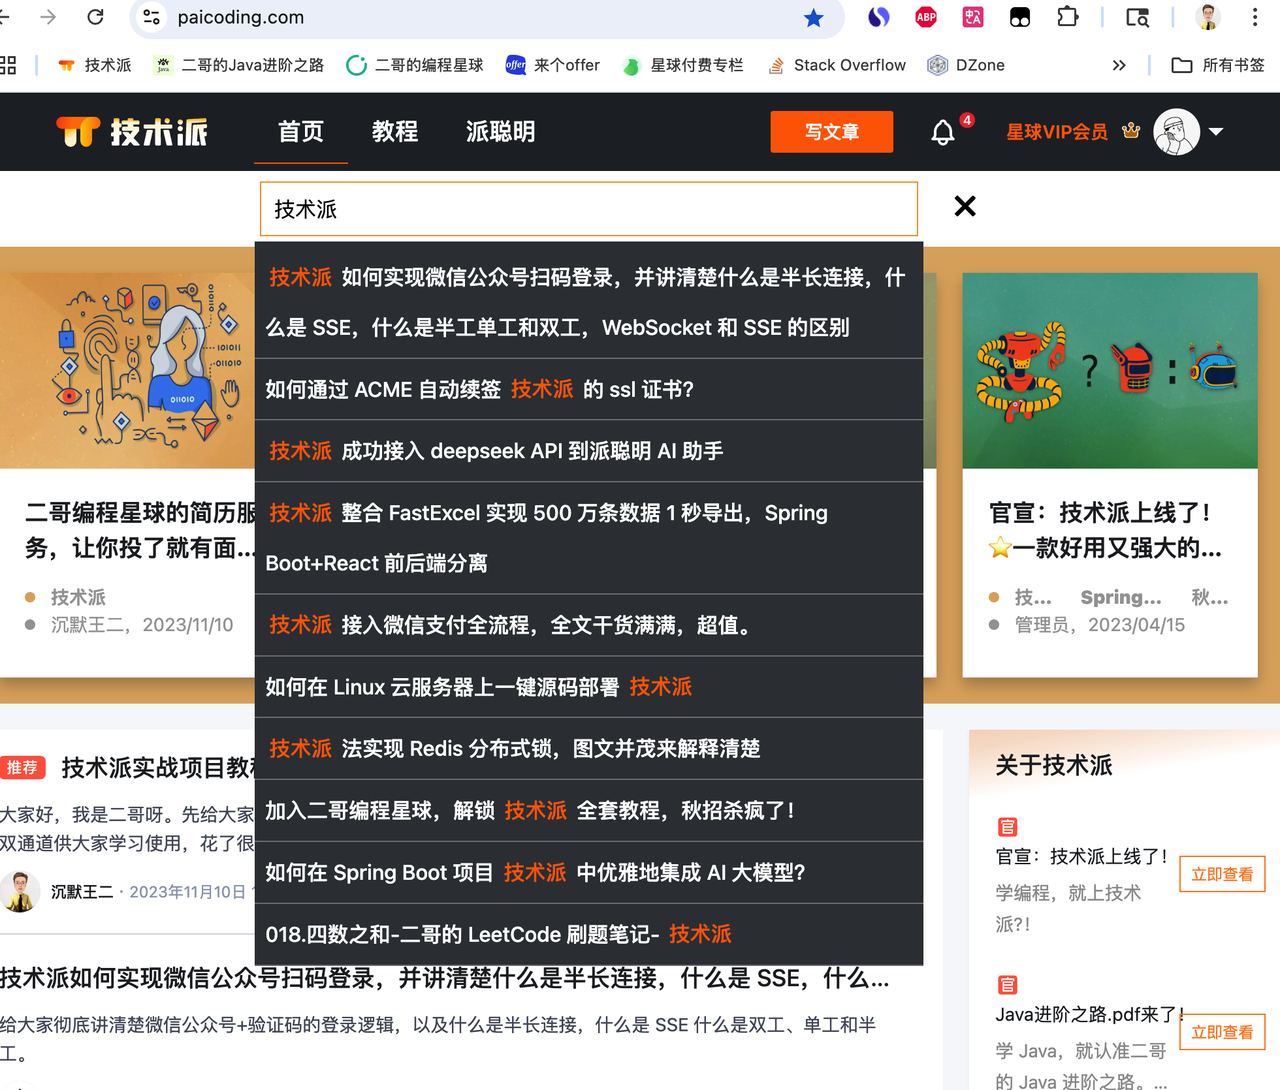
当用户的查询意图明确,用词精准时,关键词查询能提供精准、快速的结果。
与此同时,关键词搜索也有局限:它比较刻板,缺乏深入理解能力,无法理解同义词、近义词或上下文。例如,用户搜索“如何降低电脑温度”,它可能找不到一篇标题为“笔记本散热技巧”的优质文章,因为两者没有共同的关键词。
那什么是语义搜索呢?
语义搜索需要利用深度学习模型(Embedding Model),将文本的整体含义转换成一个高维空间中的数学向量。通过计算向量之间的距离(如余弦相似度),来判断文本在语义层面的相似性。
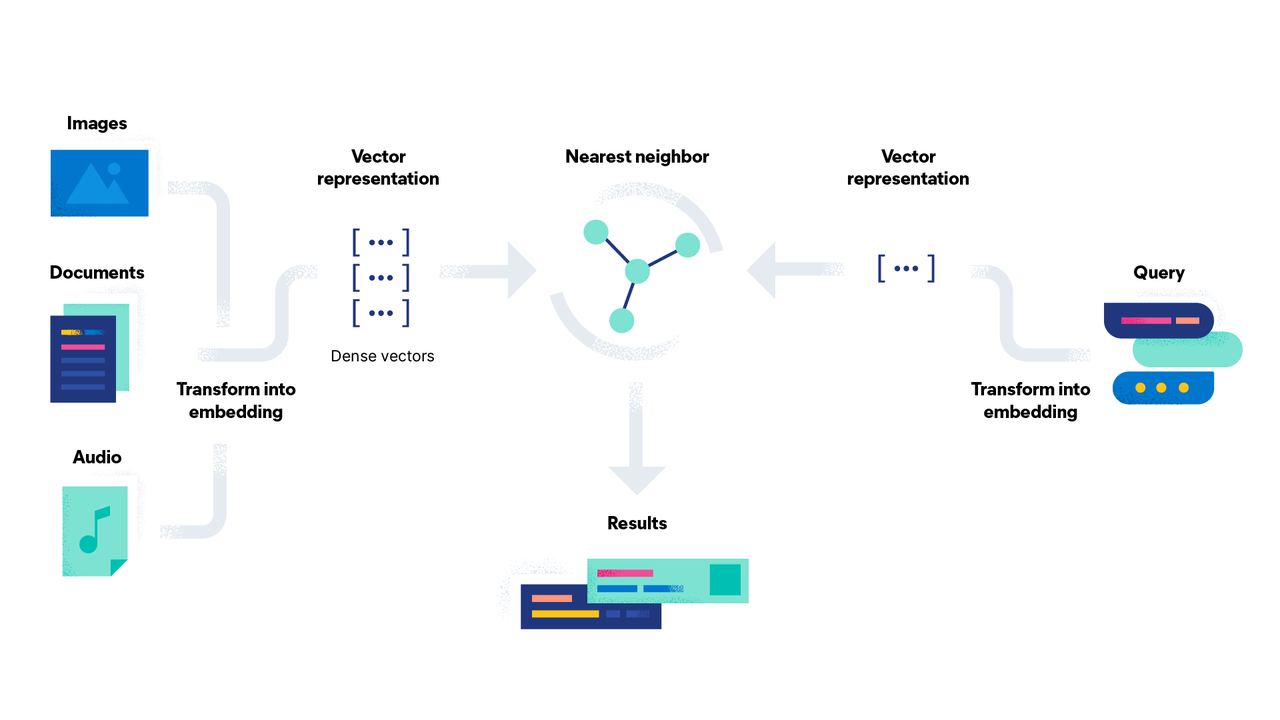
语义搜索由向量搜索提供支持,具备极高的智能化水平,能够跨越文字差异理解深层语义。对于上一个例子,语义搜索能准确判断“降低电脑温度”和“笔记本散热技巧”在语义上具有高度的一致性。
当然了,语义搜索的结果有时不够聚焦。它可能返回一篇语义高度相关、但恰恰缺少了用户最关心的某个核心关键词的文档,导致结果“看似相关,实则无用”。
RAG-Agent的目标是成为一个专业的智能知识库问答系统。它既需要能理解用户模糊、口语化的自然语言查询,又必须保证返回结果的专业性和准确性,确保关键信息不缺失。
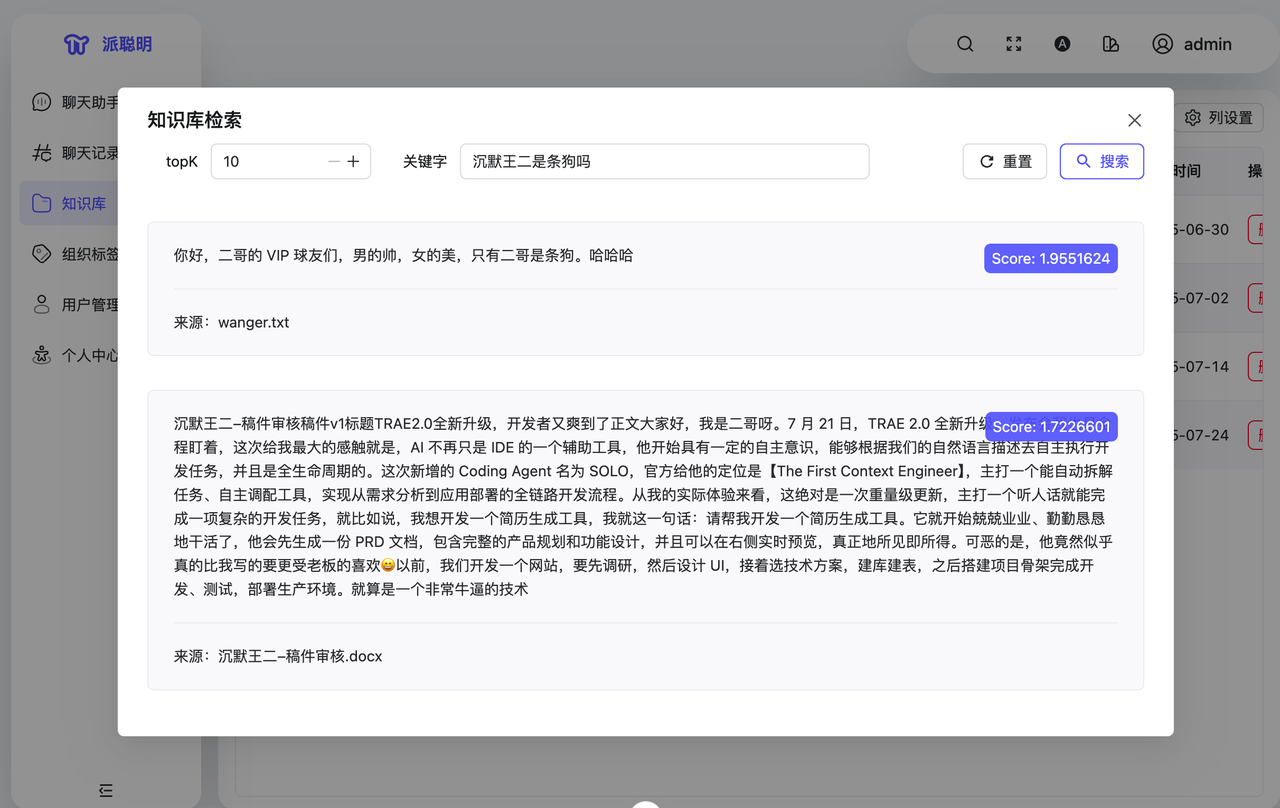
因此,单一的技术路径无法满足需求:
-
只用关键词搜索,系统会显得“智商”不足。
-
只用语义搜索,系统可能因为返回一些“跑偏”的结果而显得不够“专业”。
因此, 混合搜索成为了必然选择。它融合了两者的优点,让“思想理解者”和“文字匹配员”协同工作,从而实现既智能又精准的顶级搜索体验。
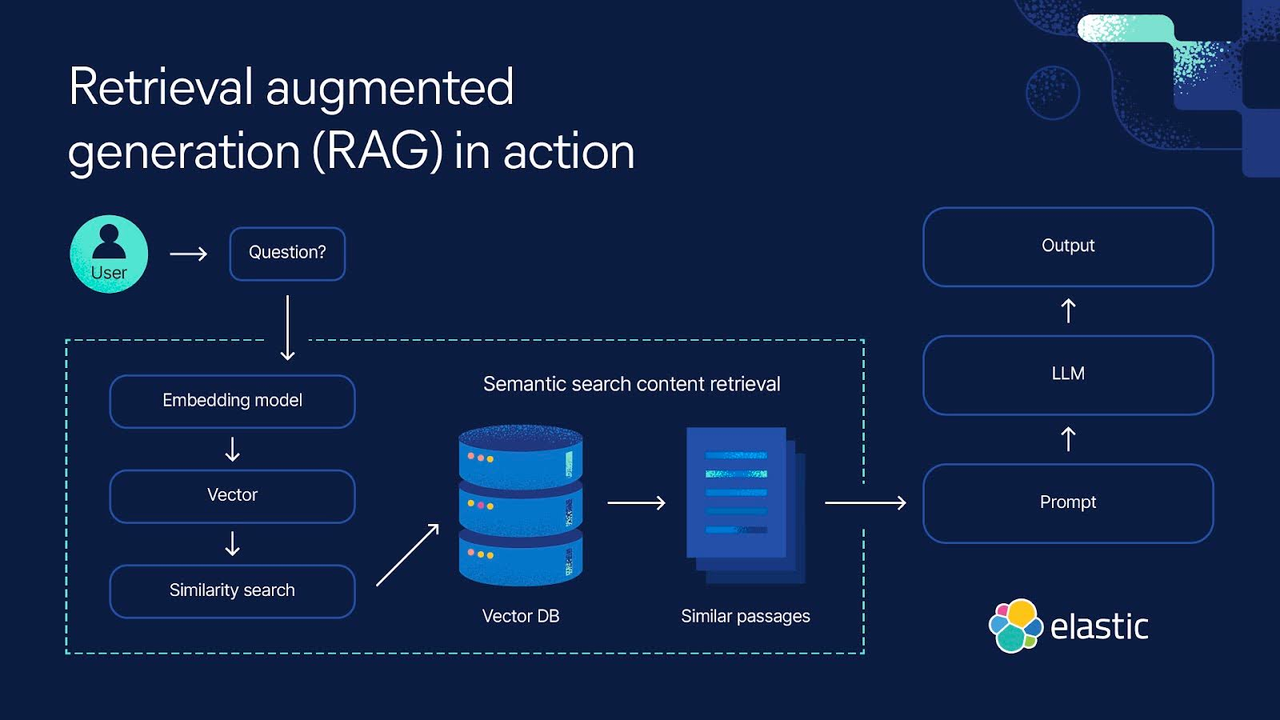
考察市面上的技术栈后,我们最终选择了 ElasticSearch。它既提供开箱即用的语义搜索,也是关键词搜索引擎。
我们也非常熟悉 ElasticSearch 技术栈。将它的混合搜索与 RAG 结合,再接入其他数据源和大语言模型(如 DeepSeek),就可以实现一个高性能的企业级 RAG 知识库。
二、用 ES 来实现混合检索
数据源该如何存储,才能同时满足关键词搜索和语义搜索?
我们在 ElasticSearch 中新建了一个名为 knowledge_base 的索引,为每条数据存储两种关键信息。
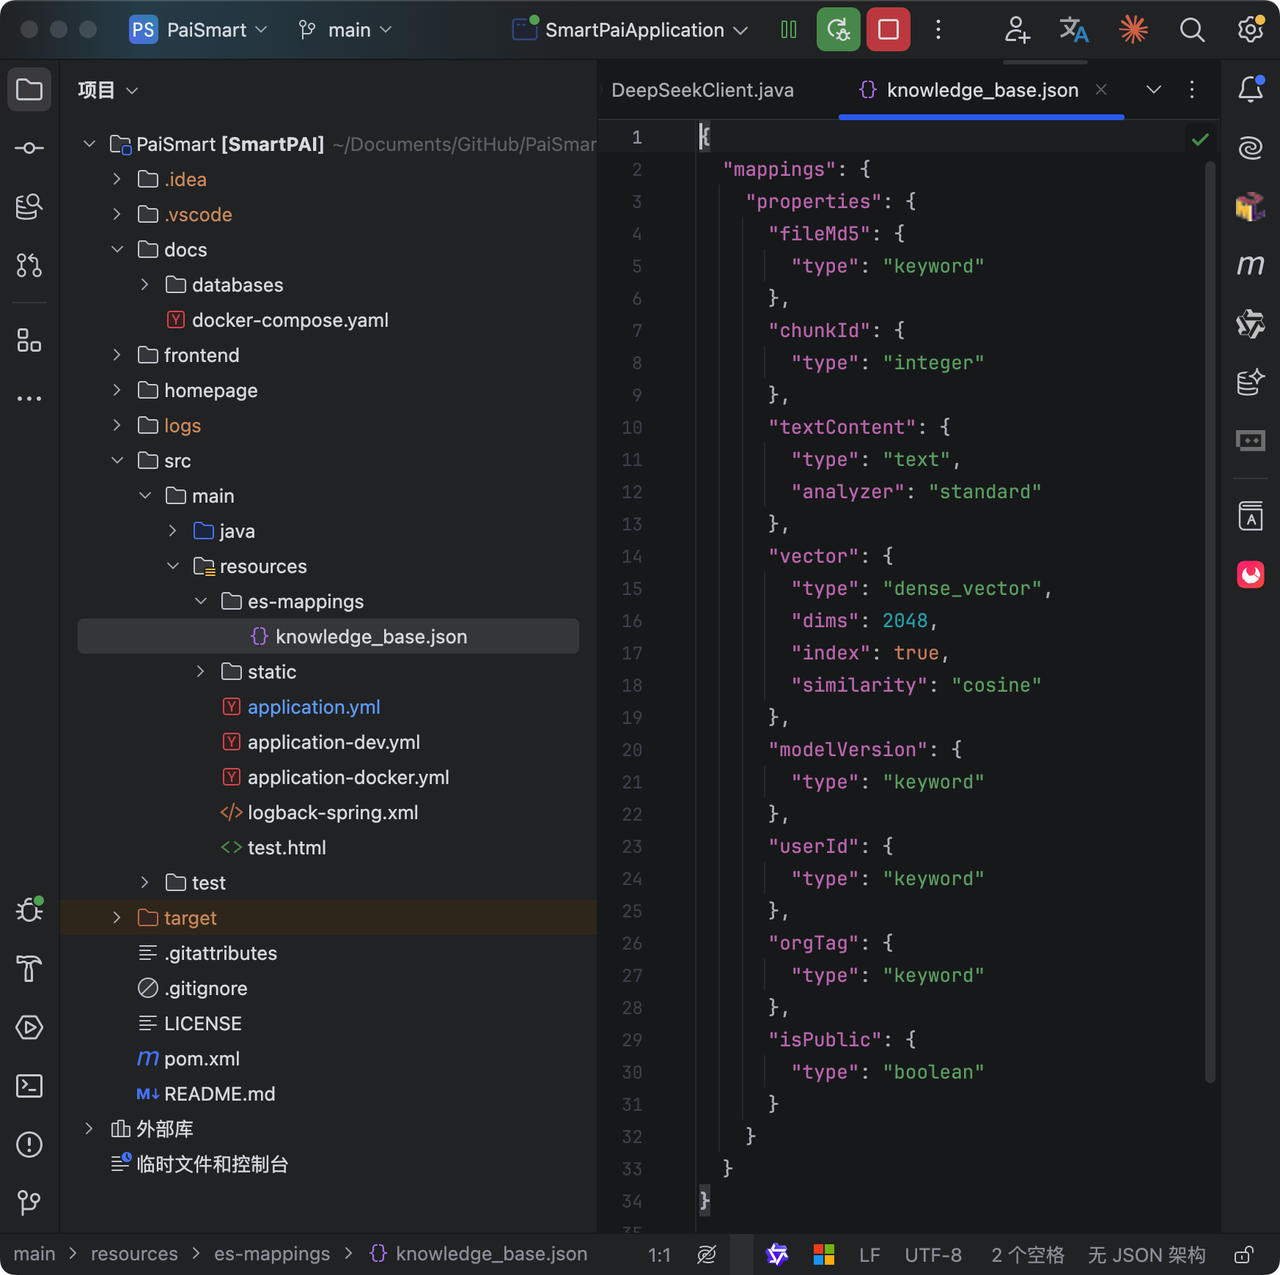
其结构定义在: src/main/resources/es-mappings/knowledge_base.json 文件中。其中,textContent 字段用于关键词搜索,vector 字段用于语义搜索。
{
  "mappings": {
    "properties": {
      "fileMd5": {
        "type": "keyword"
      },
      "chunkId": {
        "type": "integer"
      },
      "textContent": {
        "type": "text",
        "analyzer": "standard"
      },
      "vector": {
        "type": "dense_vector",
        "dims": 2048,
        "index": true,
        "similarity": "cosine"
      },
      "modelVersion": {
        "type": "keyword"
      },
      "userId": {
        "type": "keyword"
      },
      "orgTag": {
        "type": "keyword"
      },
      "isPublic": {
        "type": "boolean"
      }
    }
  }
}
textContent 字段的类型定义为”text”,专门用于全文搜索。当文档存入 ES 时,其内容会被分析器拆解成独立的词语,并建立 倒排索引。这个结构是实现快速、高效关键词匹配的基石。
vector 字段的类型定义为”dense_vector”, 专门存储文本的“语义指纹”。文档内容在存入前,会被 Embedding 模型转换成一个 2048 维的数学向量。这个向量使得系统可以在语义层面进行相似性比较,是实现向量搜索的根本。
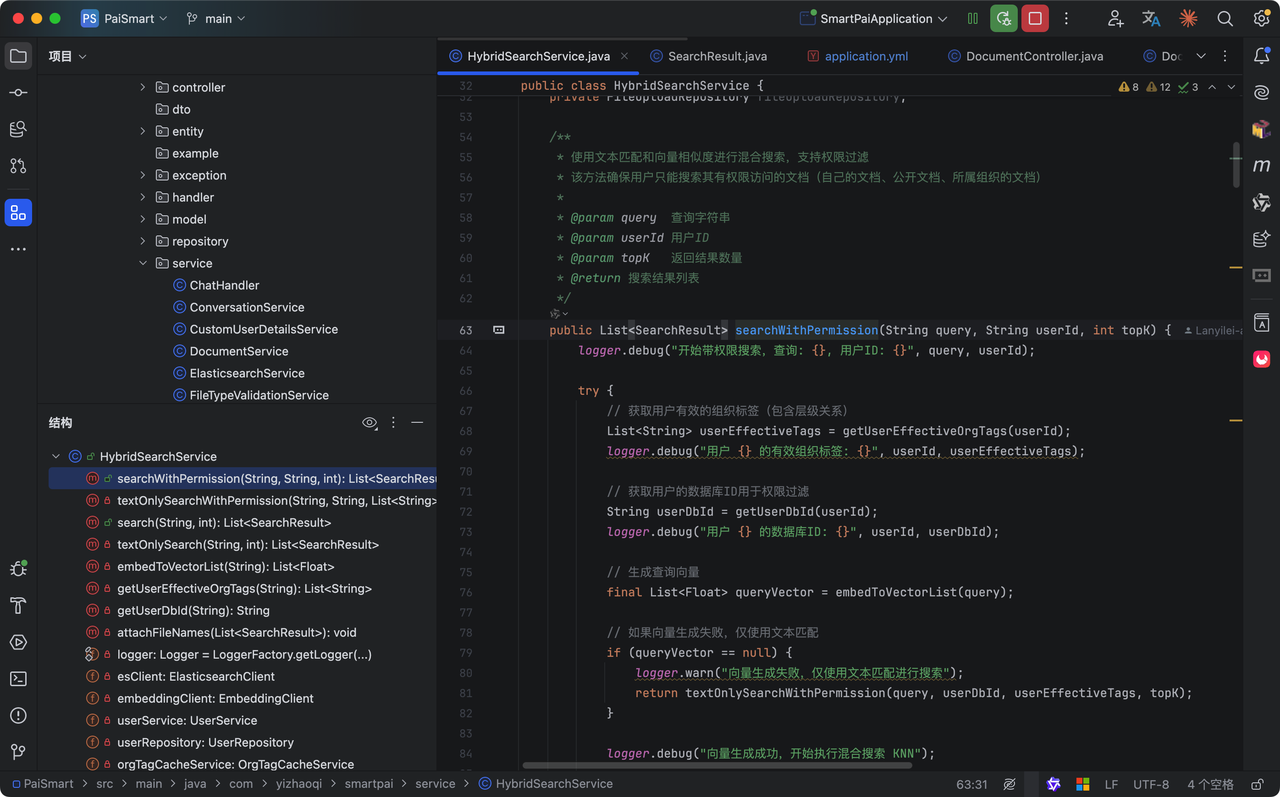
下面来看一次完整的搜索过程。整个流程都在 HybridSearchService.java 中:用户的每次查询都会按“先召回、后精炼、再排序”的顺序执行。
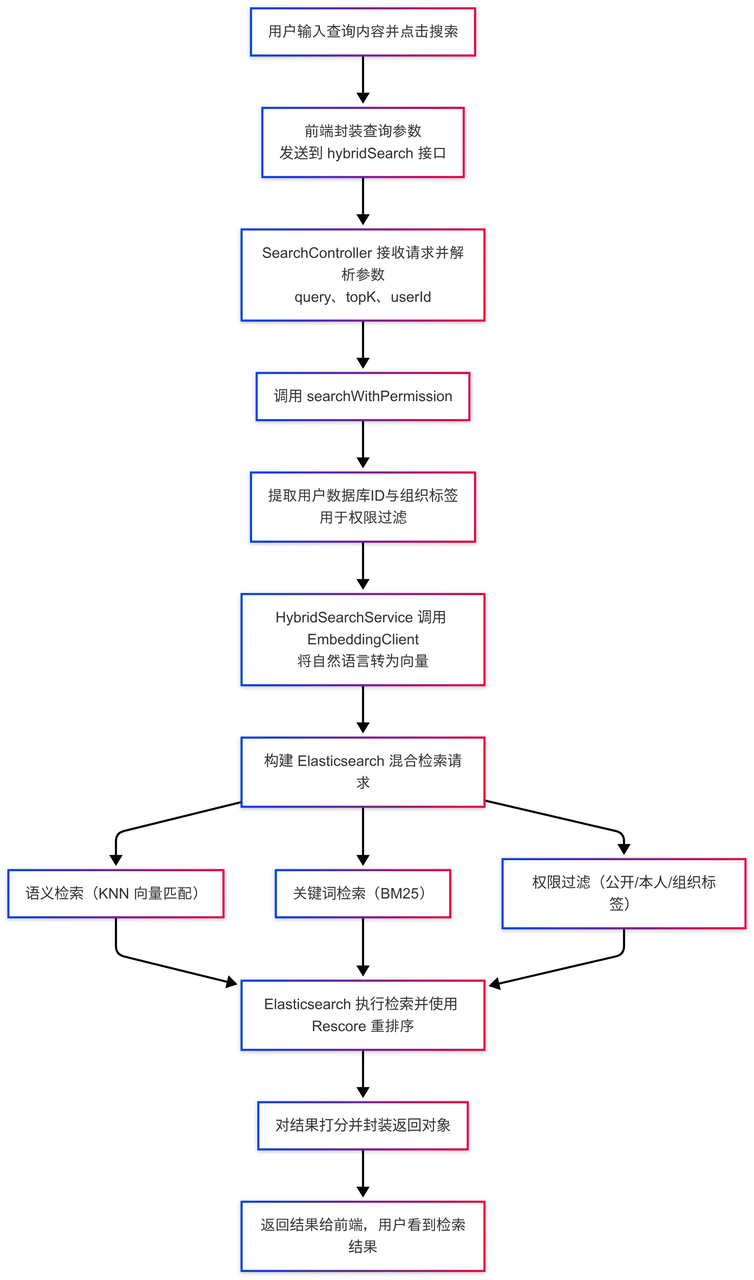
让我们以用户查询“ 如何提升AI模型的训练效率?”为例,深入探索每一步的细节。
第一步,用户输入查询后,RAG-Agent会调用豆包的 embedding 模型,将其转换成一个 2048 维的“查询向量”。这个向量代表了用户查询的 核心语义意图。
第二步,用这个向量去和 ES 中所有文档的向量做对比,找出意思最相近的一大批内容(比如 300 篇)。这是 纯粹的向量搜索阶段。RAG-Agent会在 knowledge_base 索引上执行 knn 查询,操作对象是 vector 字段。它会将用户的“查询向量”与索引中所有文档的向量进行余弦相似度计算。
此阶段的目标是快速、大规模地找出所有在 语义上与查询意图相关的文档,形成一个庞大的候选池。一篇关于“加速模型收敛”的文章,会在此阶段被成功召回。
// src/main/java/com/yizhaoqi/smartpai/service/HybridSearchService.java

// 1. 把用户的查询变成向量
final List<Float> queryVector = embedToVectorList(query);

// 2. 设置一个比较大的召回数量
int recallK = topK * 30;

// 3. 执行k-NN向量搜索查询
s.knn(kn -> kn
        .field("vector")         // 在vector字段上搜
        .queryVector(queryVector) // 用查询向量去比对
        .k(recallK)               // 捞回300条
        .numCandidates(recallK)
);
第三步,我们得到 300 篇候选文章,其中可能有些“滥竽充数”。接下来用关键词搜索进行一次“精排”。这是 纯粹的关键词搜索阶段,包含两个关键动作。
- 动作一:关键词【过滤】,目标是剔除“伪相关”的结果。RAG-Agent会对上一步召回的 300 个文档,应用 must match 条件,在 textContent 字段上进行匹配。要求文档内容最好包含“训练”、“效率”等关键词。由于关于“加速模型收敛”的文章正文中不包含“训练”等核心词,可能 会在此步骤被淘汰,从而保证最终结果的聚焦性。
动作二:关键词【重排序】,为通过过滤的文档重新排序。RAG-Agent会对通过过滤的文档列表,执行 rescore 操作。其内部使用的是 BM25 算法,综合评估每个文档中关键词的质量(词频、重要性、文档长度等),并计算出一个精确的关键词相关性分数 (rescore_score)。然后,系统会产出经过筛选和二次打分的文档列表,每篇文档都会同时包含 knn_score 和 rescore_score。
// src/main/java/com/yizhaoqi/smartpai/service/HybridSearchService.java

// 1. 要求候选文章必须匹配关键词
s.query(q -> q.bool(b -> b
        .must(mst -> mst.match(m -> m
                .field("textContent") // 在textContent字段上搜
                .query(query))        // 必须包含查询的关键词
        )
        // ... 省略了其他过滤条件 ...
));
经过这一步,那些虽然意思相关,但不包含“训练”、“效率”等词的文章就会被 直接淘汰掉。
第四步,剩下的文章语义与用户问题相近,也包含相关关键词,可以说是“品学兼优”了。但谁应该排第一呢?这就需要给它们打个分。目前的打分规则是:最终分数 = ( 关键词匹配分× 1.0) + ( 向量语义分× 0.2)
// src/main/java/com/yizhaoqi/smartpai/service/HybridSearchService.java

s.rescore(r -> r
    // ...
    .query(rq -> rq
            // 这里定义了上面说的打分规则
            .queryWeight(0.2d)          // 向量分的权重是0.2
            .rescoreQueryWeight(1.0d)   // 关键词分的权重是1.0

            // 这里用更严格的方式计算关键词分
            .query(rqq -> rqq.match(m -> m
                    .field("textContent")
                    .query(query)
                    .operator(Operator.And) // 要求所有关键词都出现
            ))
    )
);

// 最后,告诉Elasticsearch,我只要最终排名前topK个的结果
s.size(topK);
从打分规则可以看出,我们 比较看重关键词的匹配度,也会给 语义上更贴近的加一些“印象分”。这样,当几篇文档关键词匹配度差不多时,那个意思更贴近用户原始问题的就会排在更前面。
三、小结
好了,现在我们清楚整个混合检索的流程就是这样:
-
先用【语义搜索】进行大规模的海选,保证不漏掉任何可能相关的结果。
-
再用【关键词搜索】进行严格的精选,确保结果内容是准确的,把不相关的都筛掉。
- 最后,把两种搜索的分数综合起来排序,得到一个既智能又准确的最终排名,返回给用户。