Kubernetes Pod 入门:从容器协作到生命周期管理
把应用做成镜像之后,我们已经能用容器启动一个进程。但把它交给 Kubernetes 管理,还要回答几个问题:应用要运行在哪台节点上?日志收集容器怎样与业务容器配合?进程启动了,是否就能接收流量?更新版本时,旧实例怎样处理完手里的请求再退出?
这些问题都绕不开 Pod。它是 Kubernetes 创建和管理的最小可部署单元,也是调度、网络共享和应用生命周期管理的基础。理解了 Pod,再看 Deployment 的滚动更新、Service 的流量转发和容器重启,许多分散的配置才会连起来。
本文按应用运行的过程展开:先理解 Pod 与容器的关系,再读懂配置、启动和状态,随后讨论退出、发布和日常调试。
文中的独立 Pod 清单主要用于演示;持续运行的业务通常由 Deployment、StatefulSet 等工作负载管理,批处理任务则可以使用 Job。示例中的实验镜像、应用接口和网络条件需要自行准备;生产部署应选择经过验证的镜像版本。
为什么 Kubernetes 需要 Pod
一个运行单元,可以包含一个或多个容器
单容器 Pod 是常见的用法。需要多个副本时,通常增加 Pod 数量,而不是把多个相同的业务容器塞进一个 Pod。
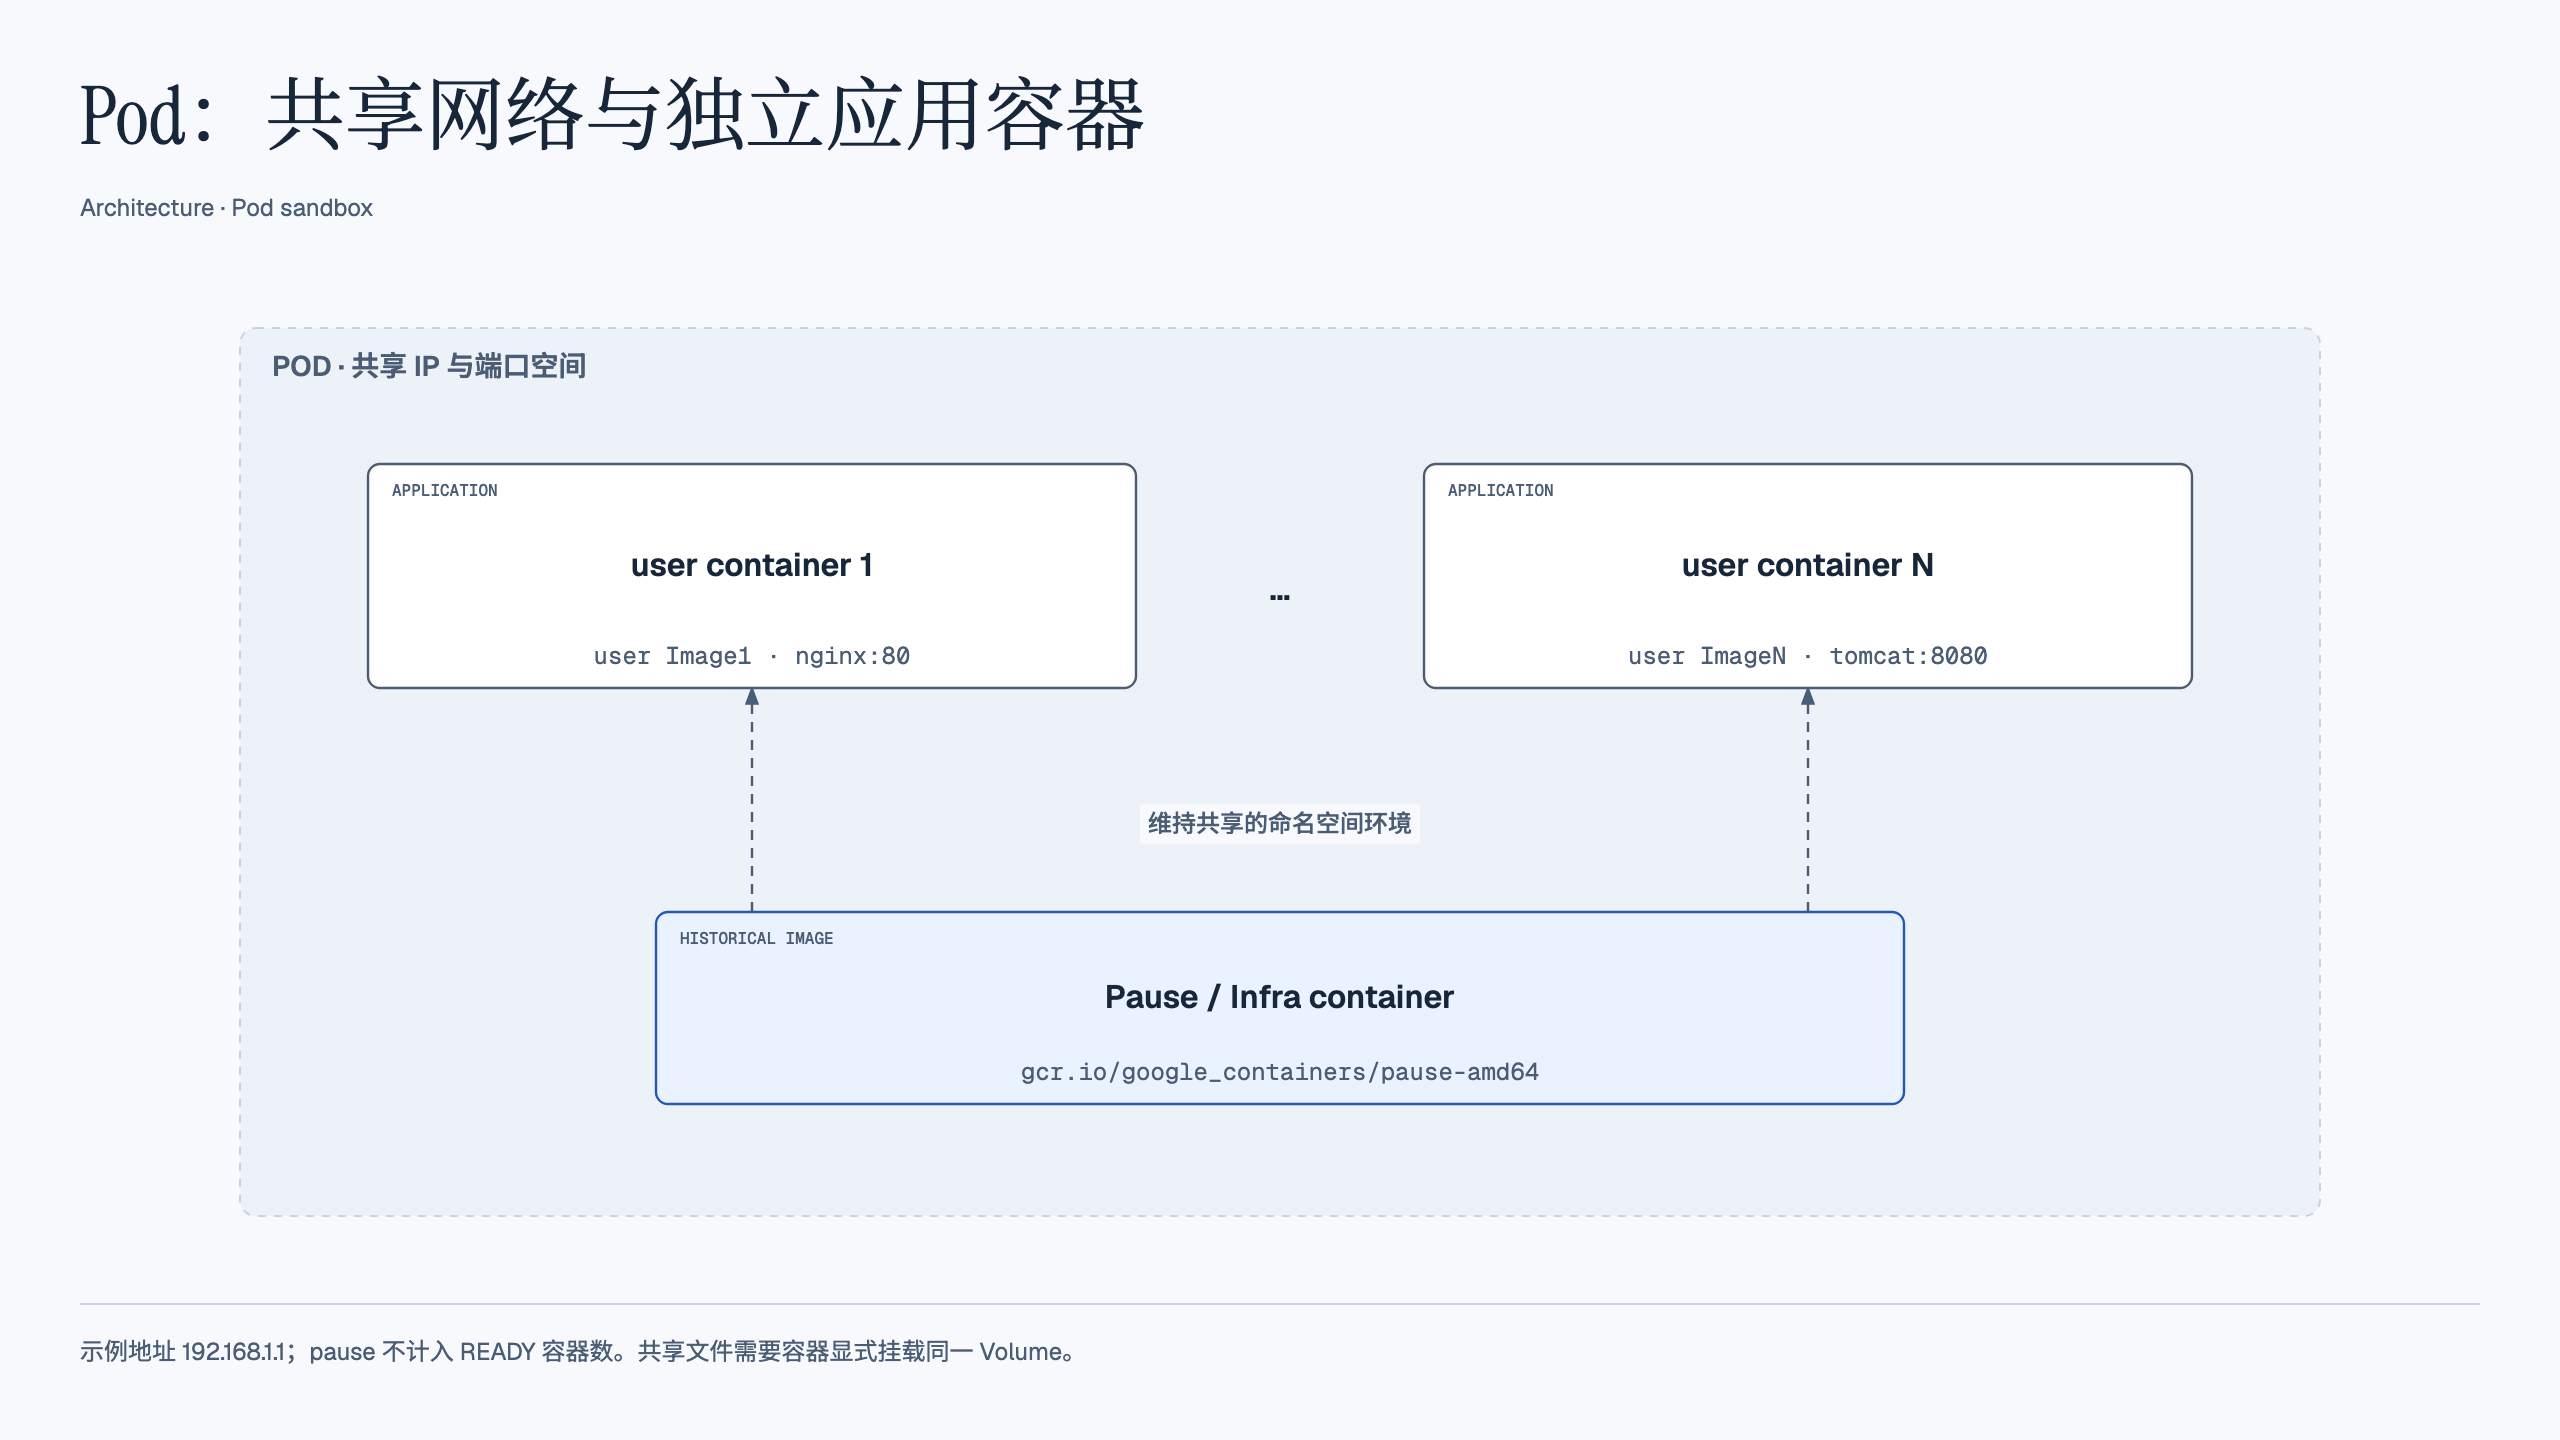
多容器 Pod 适合需要紧密协作的进程,例如业务容器与日志收集容器、Web 服务与文件同步容器,或应用与服务网格代理。这些容器作为一个单元调度到同一节点,共享 Pod 的部分运行环境,但不代表它们必须同时启动。
这种组织方式也给应用管理提供了统一的边界:Kubernetes 可以综合容器状态和就绪条件判断整个 Pod 能否提供服务。底层运行时则由 kubelet 通过 CRI 对接,例如 containerd;Pod 的使用并不以 Docker 为前提。
同一个 Pod 内,哪些资源可以共享
理解共享范围,比记住“Pod 里有多个容器”更有用:
- 网络:容器共享 Pod 的 IP 地址和端口空间,可以用
localhost:port互相访问。同一地址、同一传输协议下的监听端口不能冲突。 - 存储:Pod 可以声明多个 Volume,容器再通过各自的
volumeMounts选择挂载哪些卷、挂载到哪里。只有挂载同一个卷,才会看到相应的共享文件;容器的整个根文件系统不会自动共享。 - 进程与 IPC:常见 Linux Pod 可以通过共享的 IPC 环境通信,但 PID 命名空间默认不共享。需要跨容器查看进程时,可显式设置
spec.shareProcessNamespace: true。
Pod 中的容器可以独立退出和重启。容器重启时,Pod 对象通常仍是原来的对象;Pod 被删除或替换后,新 Pod 才拥有新的 UID。即使控制器创建的替代 Pod 沿用了相同名称,也不能把它当作原来的实例。
Pause 容器:为共享运行环境提供基础
在常见的 Linux 容器运行时实现中,创建 Pod sandbox 时会先创建一个基础设施容器,通常称为 pause 或 infra 容器。它维持共享的命名空间环境,应用容器随后加入其中。
kubectl get pods 中的 READY 1/1 通常表示该行统计的一个容器已经就绪,pause 容器不计入其中。pause 也不负责检测业务健康;健康探针由 kubelet 执行,存储共享则依赖 Volume 的声明和挂载。
用两个场景理解容器协作
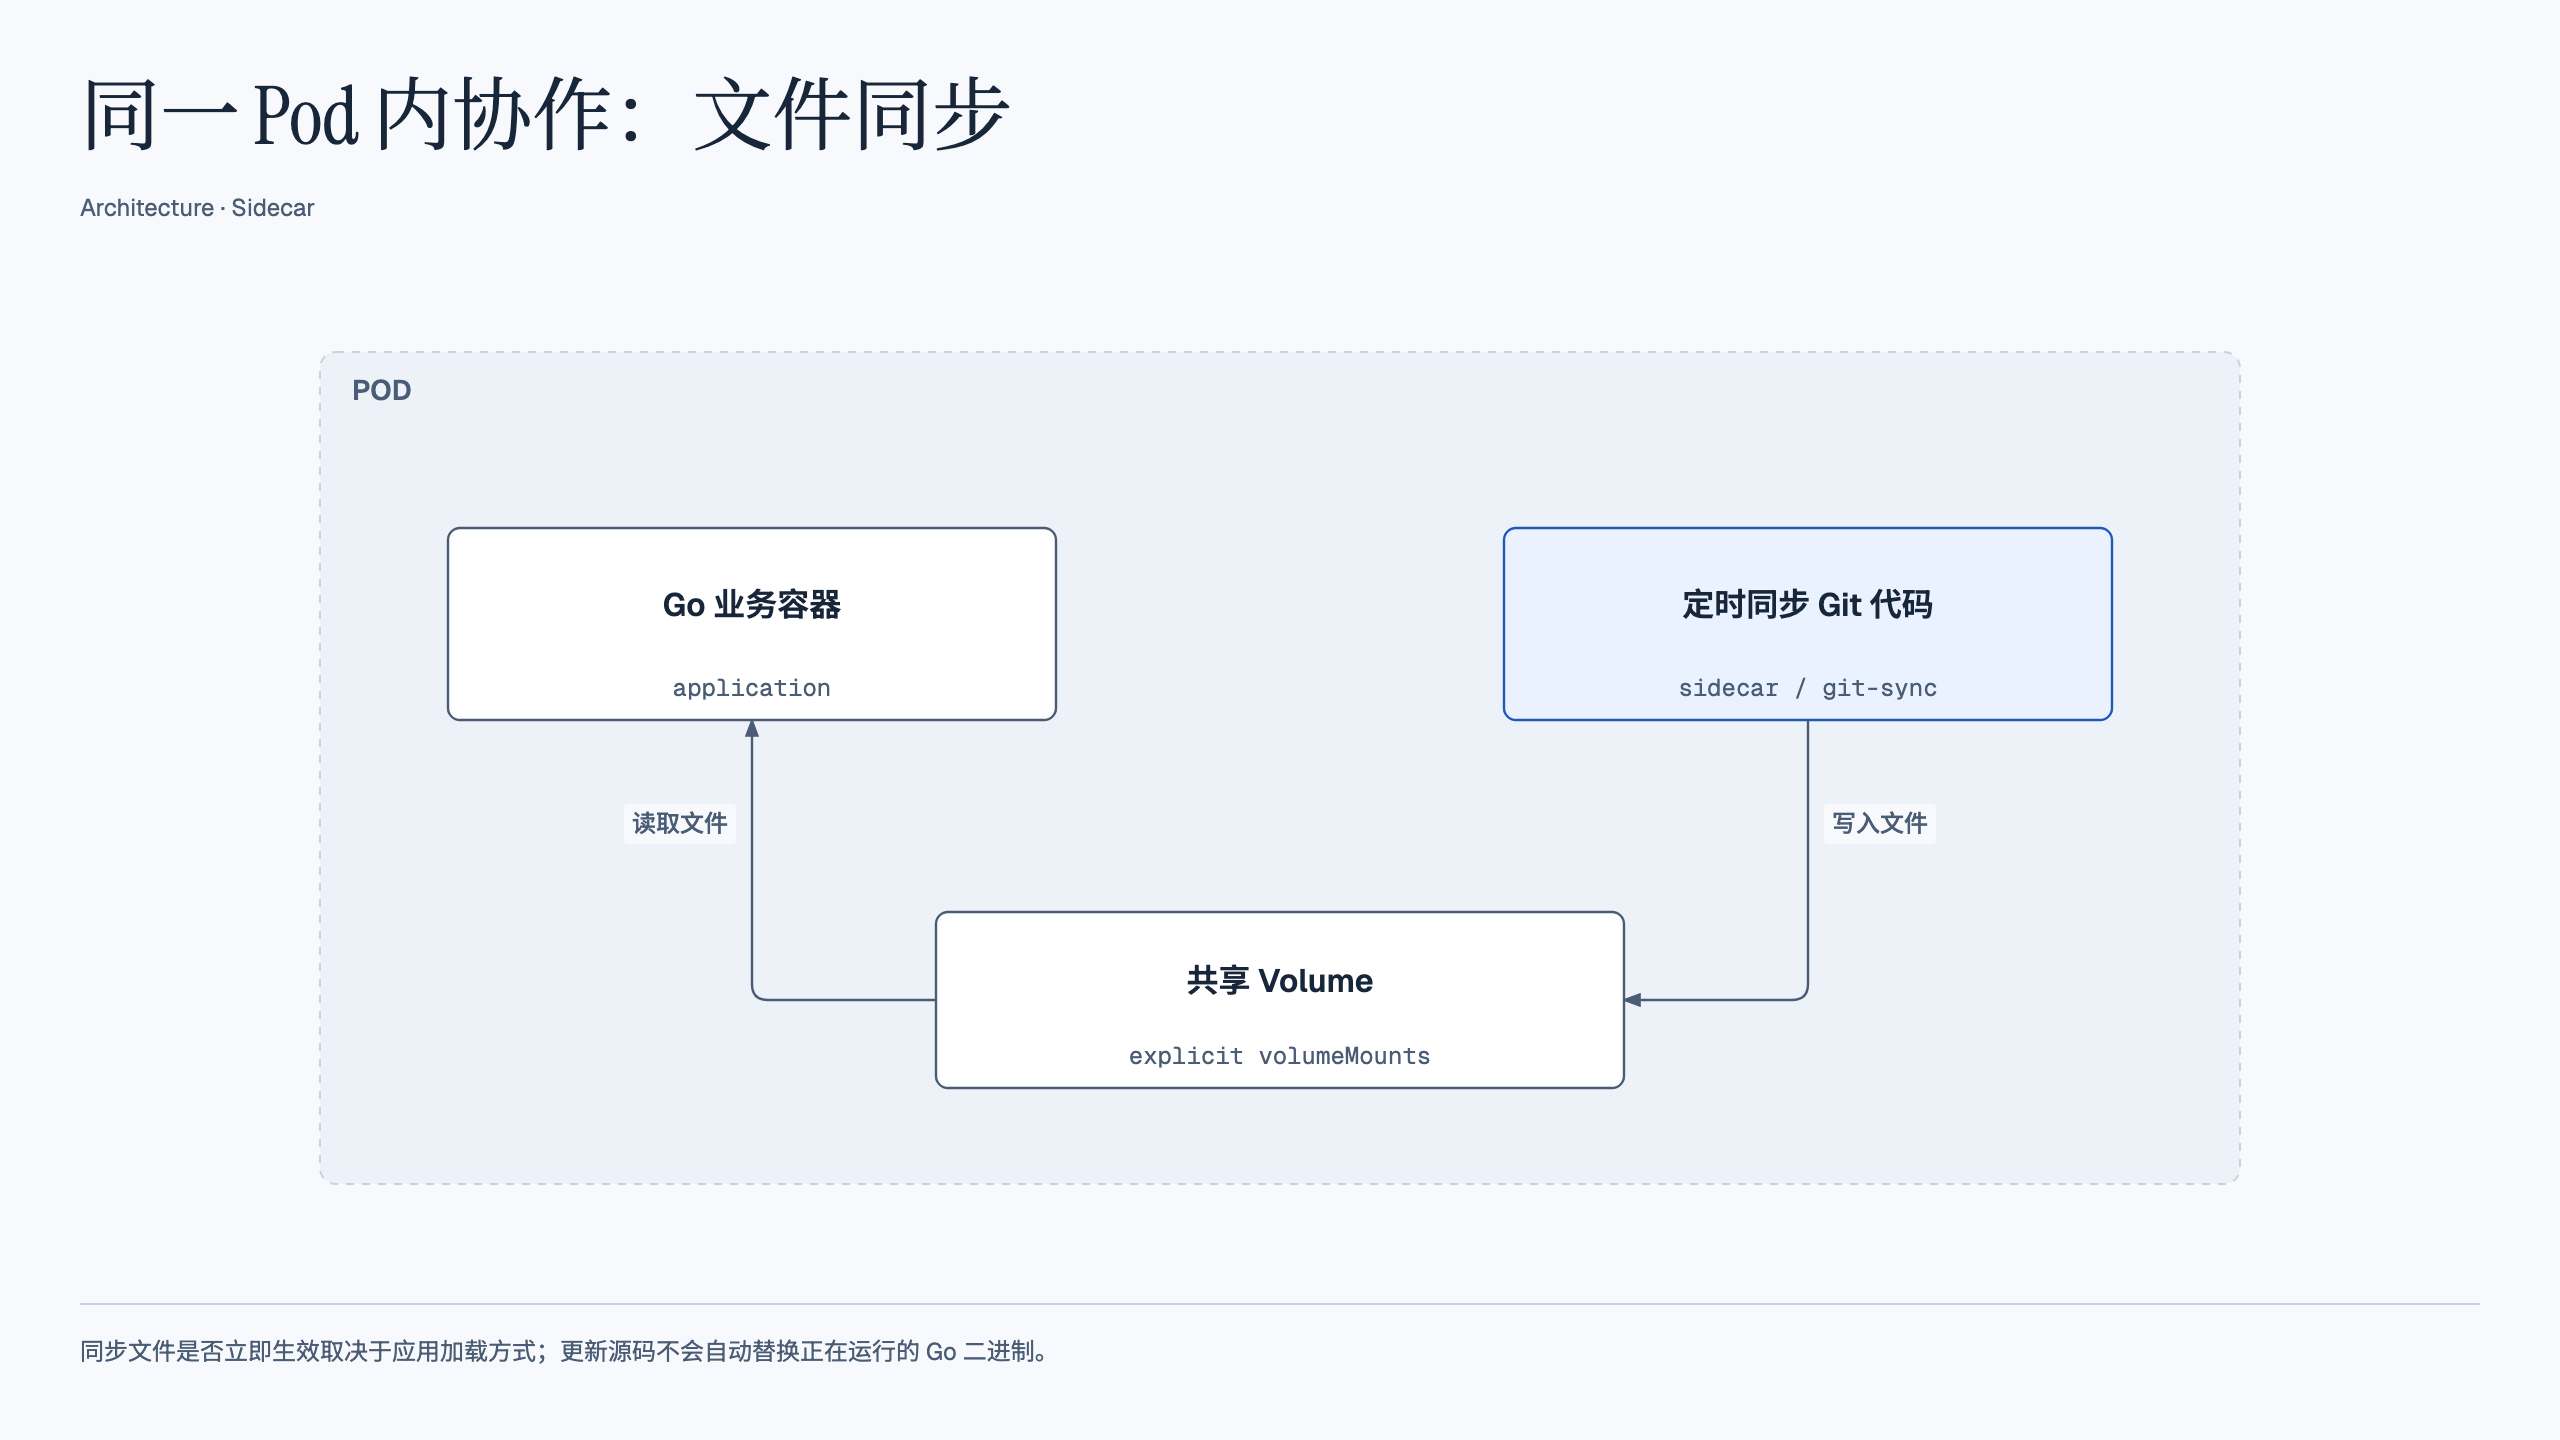
文件同步。 如果应用需要消费 Git 仓库中的文件,可以让一个 sidecar 定期同步仓库,业务容器读取共享卷中的内容。Kubernetes 社区的 git-sync 就提供了这类能力。
需要区分“文件已更新”和“程序已升级”:同步源码或配置,并不会自动让正在运行的 Go 二进制或 Java 进程加载新代码。是否能直接生效,要看应用的加载方式;应用版本发布仍需相应的构建、替换和重启机制。
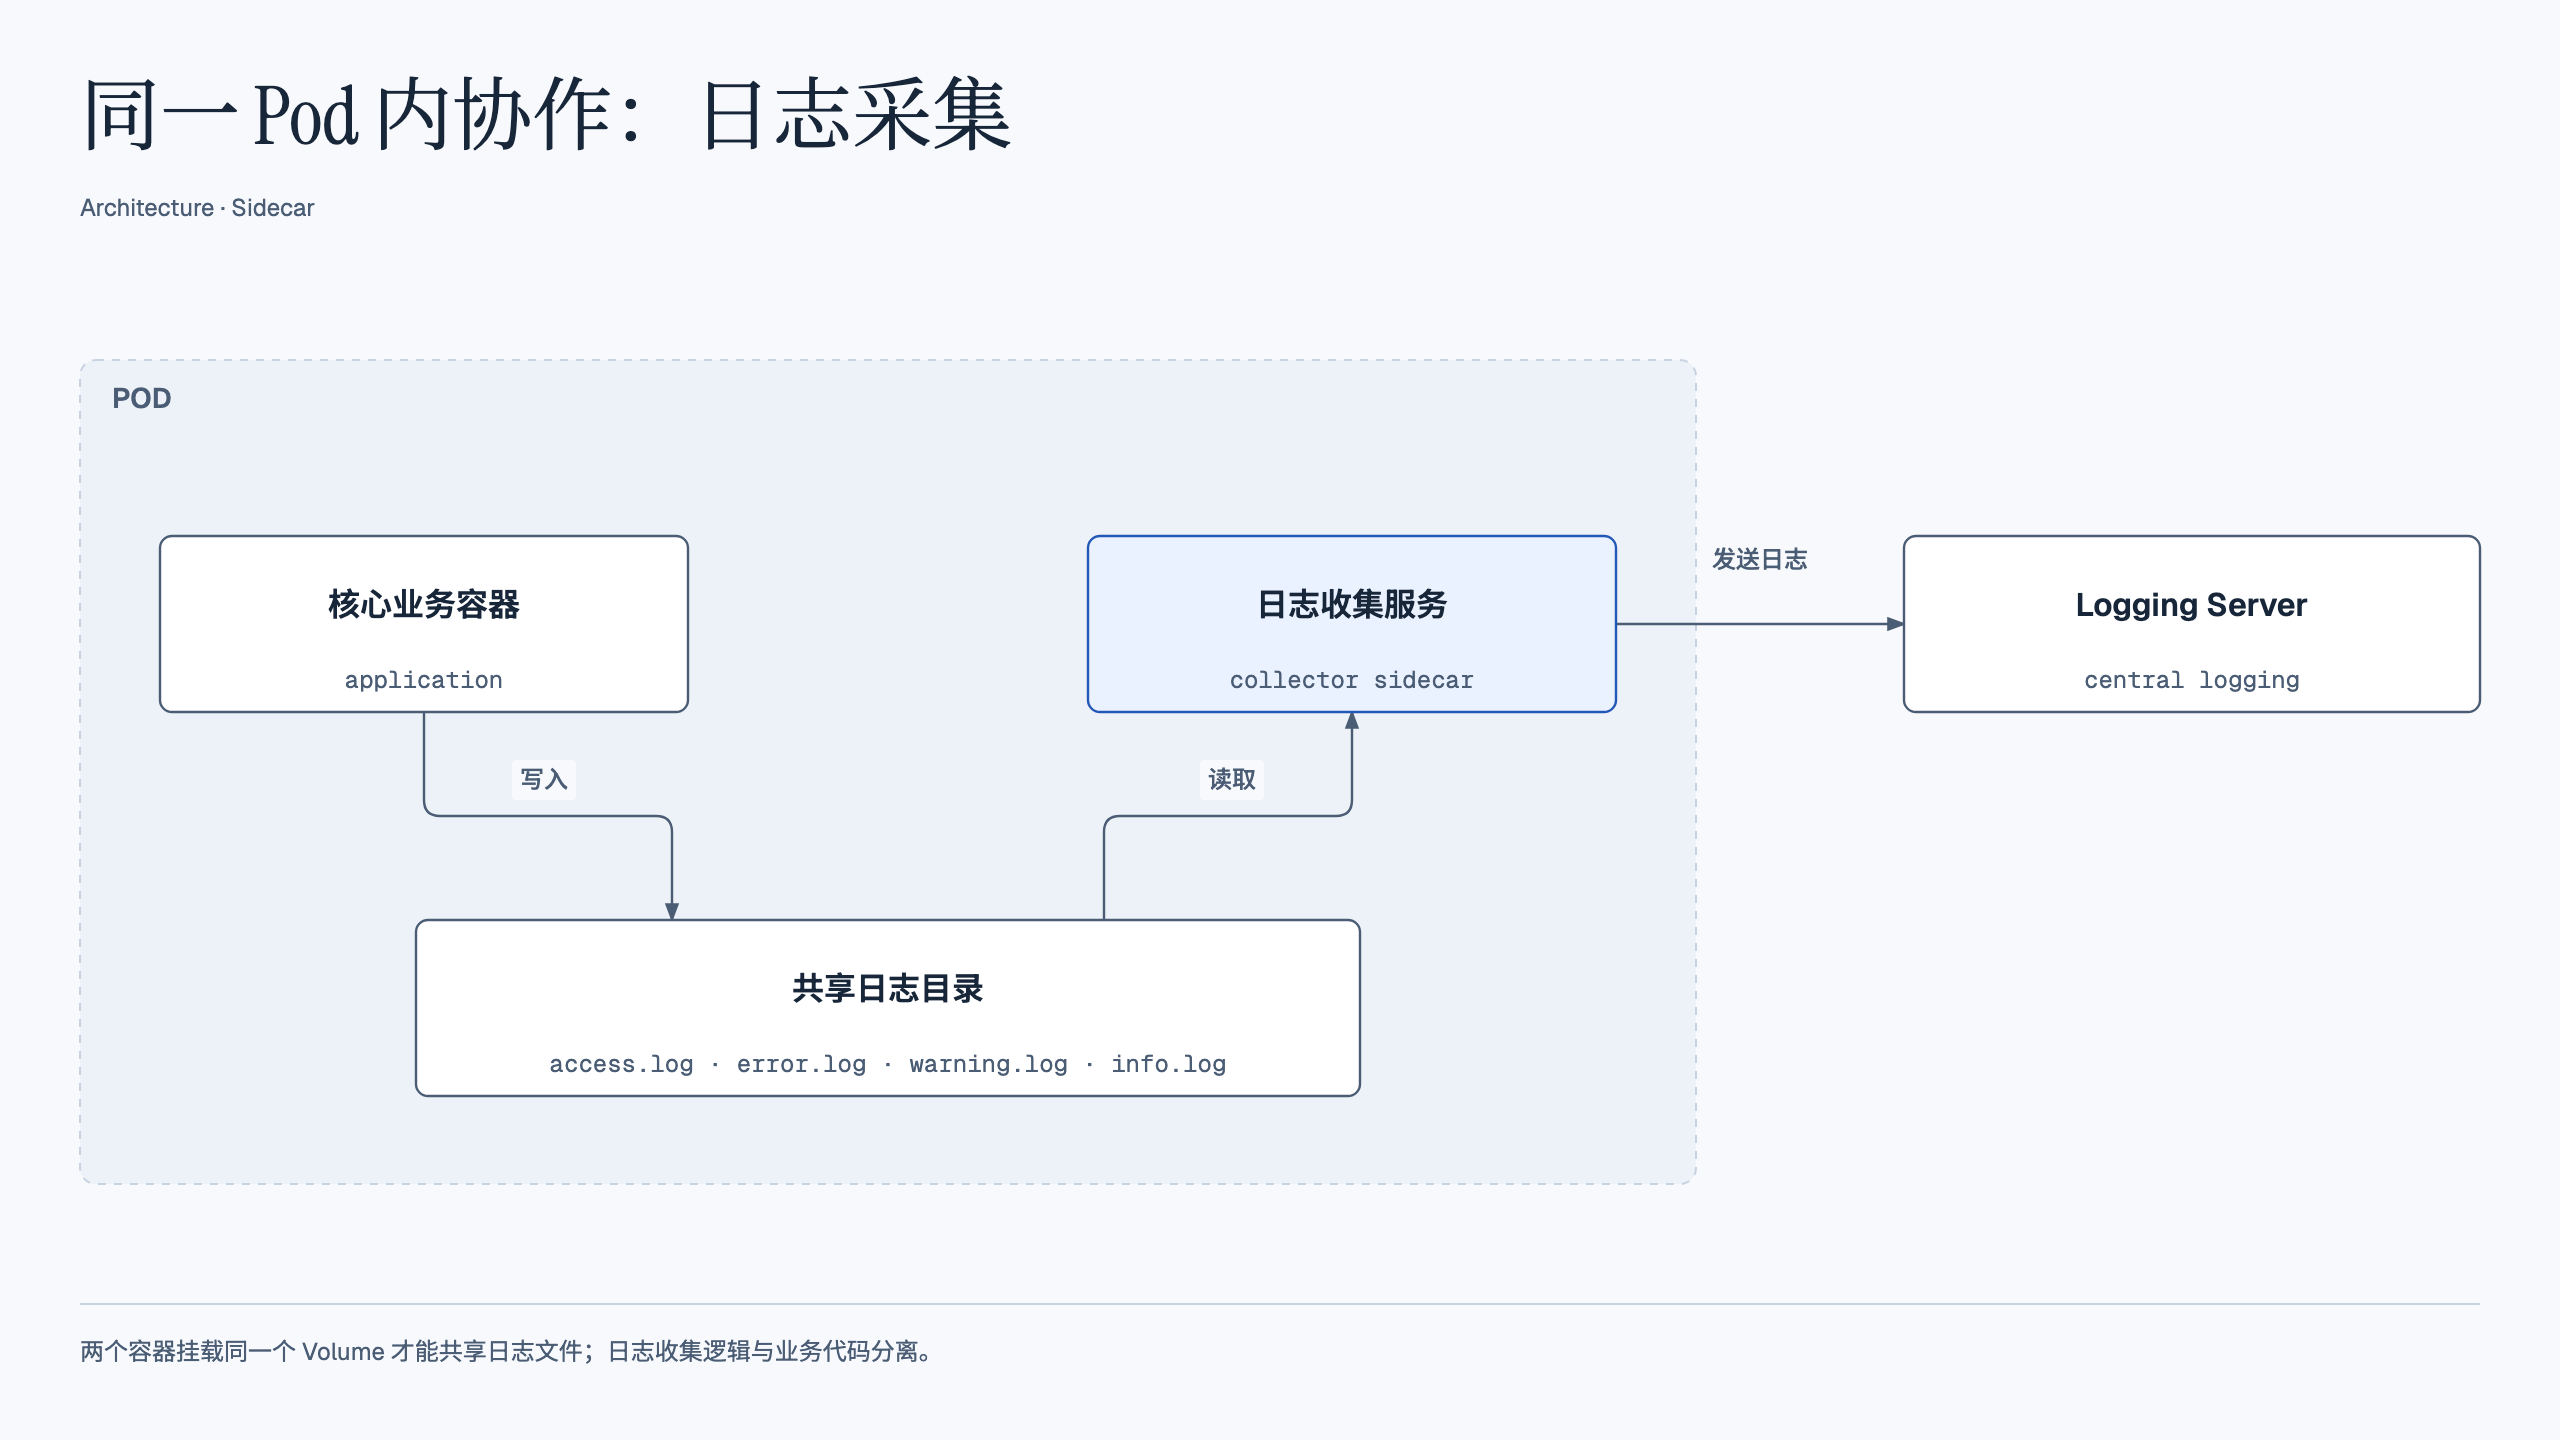
日志收集。 假设业务已经把日志写入某个目录,包含 error.log、access.log、warning.log、info.log。为了把它们发送到统一的日志服务,可以让业务容器和日志收集容器挂载同一个卷,由后者读取并发送文件。
这样可以把日志采集逻辑从业务代码中分离出来,也便于在遵循同一日志规范的服务之间复用采集配置。业务容器仍需把日志写入约定的共享目录;仅仅把两个容器放进同一个 Pod,并不会让它们自动看到对方的文件。
写一个 Pod:从最小清单理解常用字段
理解了运行边界,就可以把它写进配置。下面的清单描述一个运行 Nginx 的 Pod,可保存为 pod-demo.yaml:
apiVersion: v1
kind: Pod
metadata:
  name: pod-demo
  labels:
    run: pod-demo
spec:
  containers:
  - name: nginx
    image: nginx:latest
    ports:
    - containerPort: 80
apiVersion 和 kind 确定资源类型,metadata 描述名称和标签,spec 描述期望运行的容器。创建后,可以先观察列表,再查看详细状态与事件:
kubectl apply -f pod-demo.yaml
kubectl get pod pod-demo -o wide
kubectl describe pod pod-demo
下面几组字段决定了容器怎样启动,以及 Kubernetes 怎样管理它。
端口:声明不会替应用启动监听
spec.containers[].ports[].containerPort 描述容器使用的端口,也可通过端口名称供 Service 等配置引用。它不会让应用自动监听这个端口,也不等于把端口映射到了宿主机。实际监听哪个地址和端口,仍由容器中的程序决定。
例如,程序实际监听 80,把 containerPort 改成 81 不会改变程序行为。同一个 Pod 的两个容器如果都要监听同一地址的 TCP 80 端口,也不能靠在 YAML 中填写不同数字来避免冲突。
启动命令:区分 command 与 args
spec.containers[].command 对应镜像的 ENTRYPOINT,args 对应 CMD。未指定时使用镜像中的默认值;只设置 args 时,可以保留镜像入口并替换参数。它们不会自动经过 Shell,使用管道、重定向等语法时,需要显式调用 /bin/sh -c。
这一点也会影响后文的 Tini 示例:如果镜像入口已经用 Tini 包装主进程,在 Pod 中重新指定 command 就可能绕过它。
资源:requests 参与调度,limits 约束运行
requests 是调度器判断节点能否容纳 Pod 的重要依据,并不表示对应内存已经全部被程序占用。因此,节点上运行 free -m 看起来还有空闲内存,新 Pod 仍可能因为可分配资源已被其他 Pod 的 requests 占用而处于 Pending。
limits 约束容器运行时的资源使用:CPU 超限通常表现为节流,内存压力下则可能触发 OOM 终止。只填写某项资源的 limit、没有填写 request,且准入阶段没有设置默认 request 时,Kubernetes 会把该 limit 复制为 request。排查调度失败时,应检查最终生效的配置。
环境变量:把 Pod 自身的信息交给应用
普通环境变量用 value 指定;Pod 名称、IP、标签等信息可以通过 Downward API 的 valueFrom.fieldRef 注入。下面是放在容器配置下的片段:
env:
- name: path
  value: test
- name: POD_NAME
  valueFrom:
    fieldRef:
      fieldPath: metadata.name
- name: POD_IP
  valueFrom:
    fieldRef:
      fieldPath: status.podIP
- name: LABEL_APP
  valueFrom:
    fieldRef:
      fieldPath: metadata.labels['run']
其中 LABEL_APP 读取 run 标签。常见的 fieldRef 字段包括:
- 标识:
metadata.name、metadata.namespace、metadata.uid。 - 标签和注解:
metadata.labels['<KEY>']、metadata.annotations['<KEY>']。 - 调度与身份:
spec.nodeName、spec.serviceAccountName。 - 地址:
status.hostIP、status.hostIPs、status.podIP、status.podIPs。
这些字段可用作环境变量,但不代表所有字段都能通过 Downward API Volume 暴露,具体支持范围应查官方列表。
重启策略:决定容器退出之后怎么办
Pod 级别的 spec.restartPolicy 有三个常见取值:
| 取值 | 容器退出后的行为 |
|---|---|
Always | 无论退出码是否为 0,都重启;这是默认值。 |
OnFailure | 退出码非 0 时重启,正常退出时不重启。 |
Never | 不自动重启已退出的容器。 |
这里讨论的是常规应用容器的 Pod 级策略;原生 sidecar 和较新版本的容器级重启规则还存在单独的配置。Deployment 的 Pod 模板使用 Always,Job 则通常按任务需要选择 OnFailure 或 Never,不能把“始终保持 Always”当作所有工作负载的通用规则。
下面的实验让 BusyBox 等待 10 秒后以非零状态退出,便于观察容器重启次数:
apiVersion: v1
kind: Pod
metadata:
  name: bb-rp
  labels:
    app: busybox
spec:
  containers:
  - name: busybox
    image: busybox:latest
    command: ["/bin/sh"]
    args: ["-c", "sleep 10; exit 1"]
  restartPolicy: Always
Pod 如何启动:调度、初始化与状态
提交清单成功,只表示 Kubernetes 接收了资源定义。镜像是否拉取成功、初始化是否完成、应用能否提供服务,还要继续观察。
从 API 请求到节点上的容器
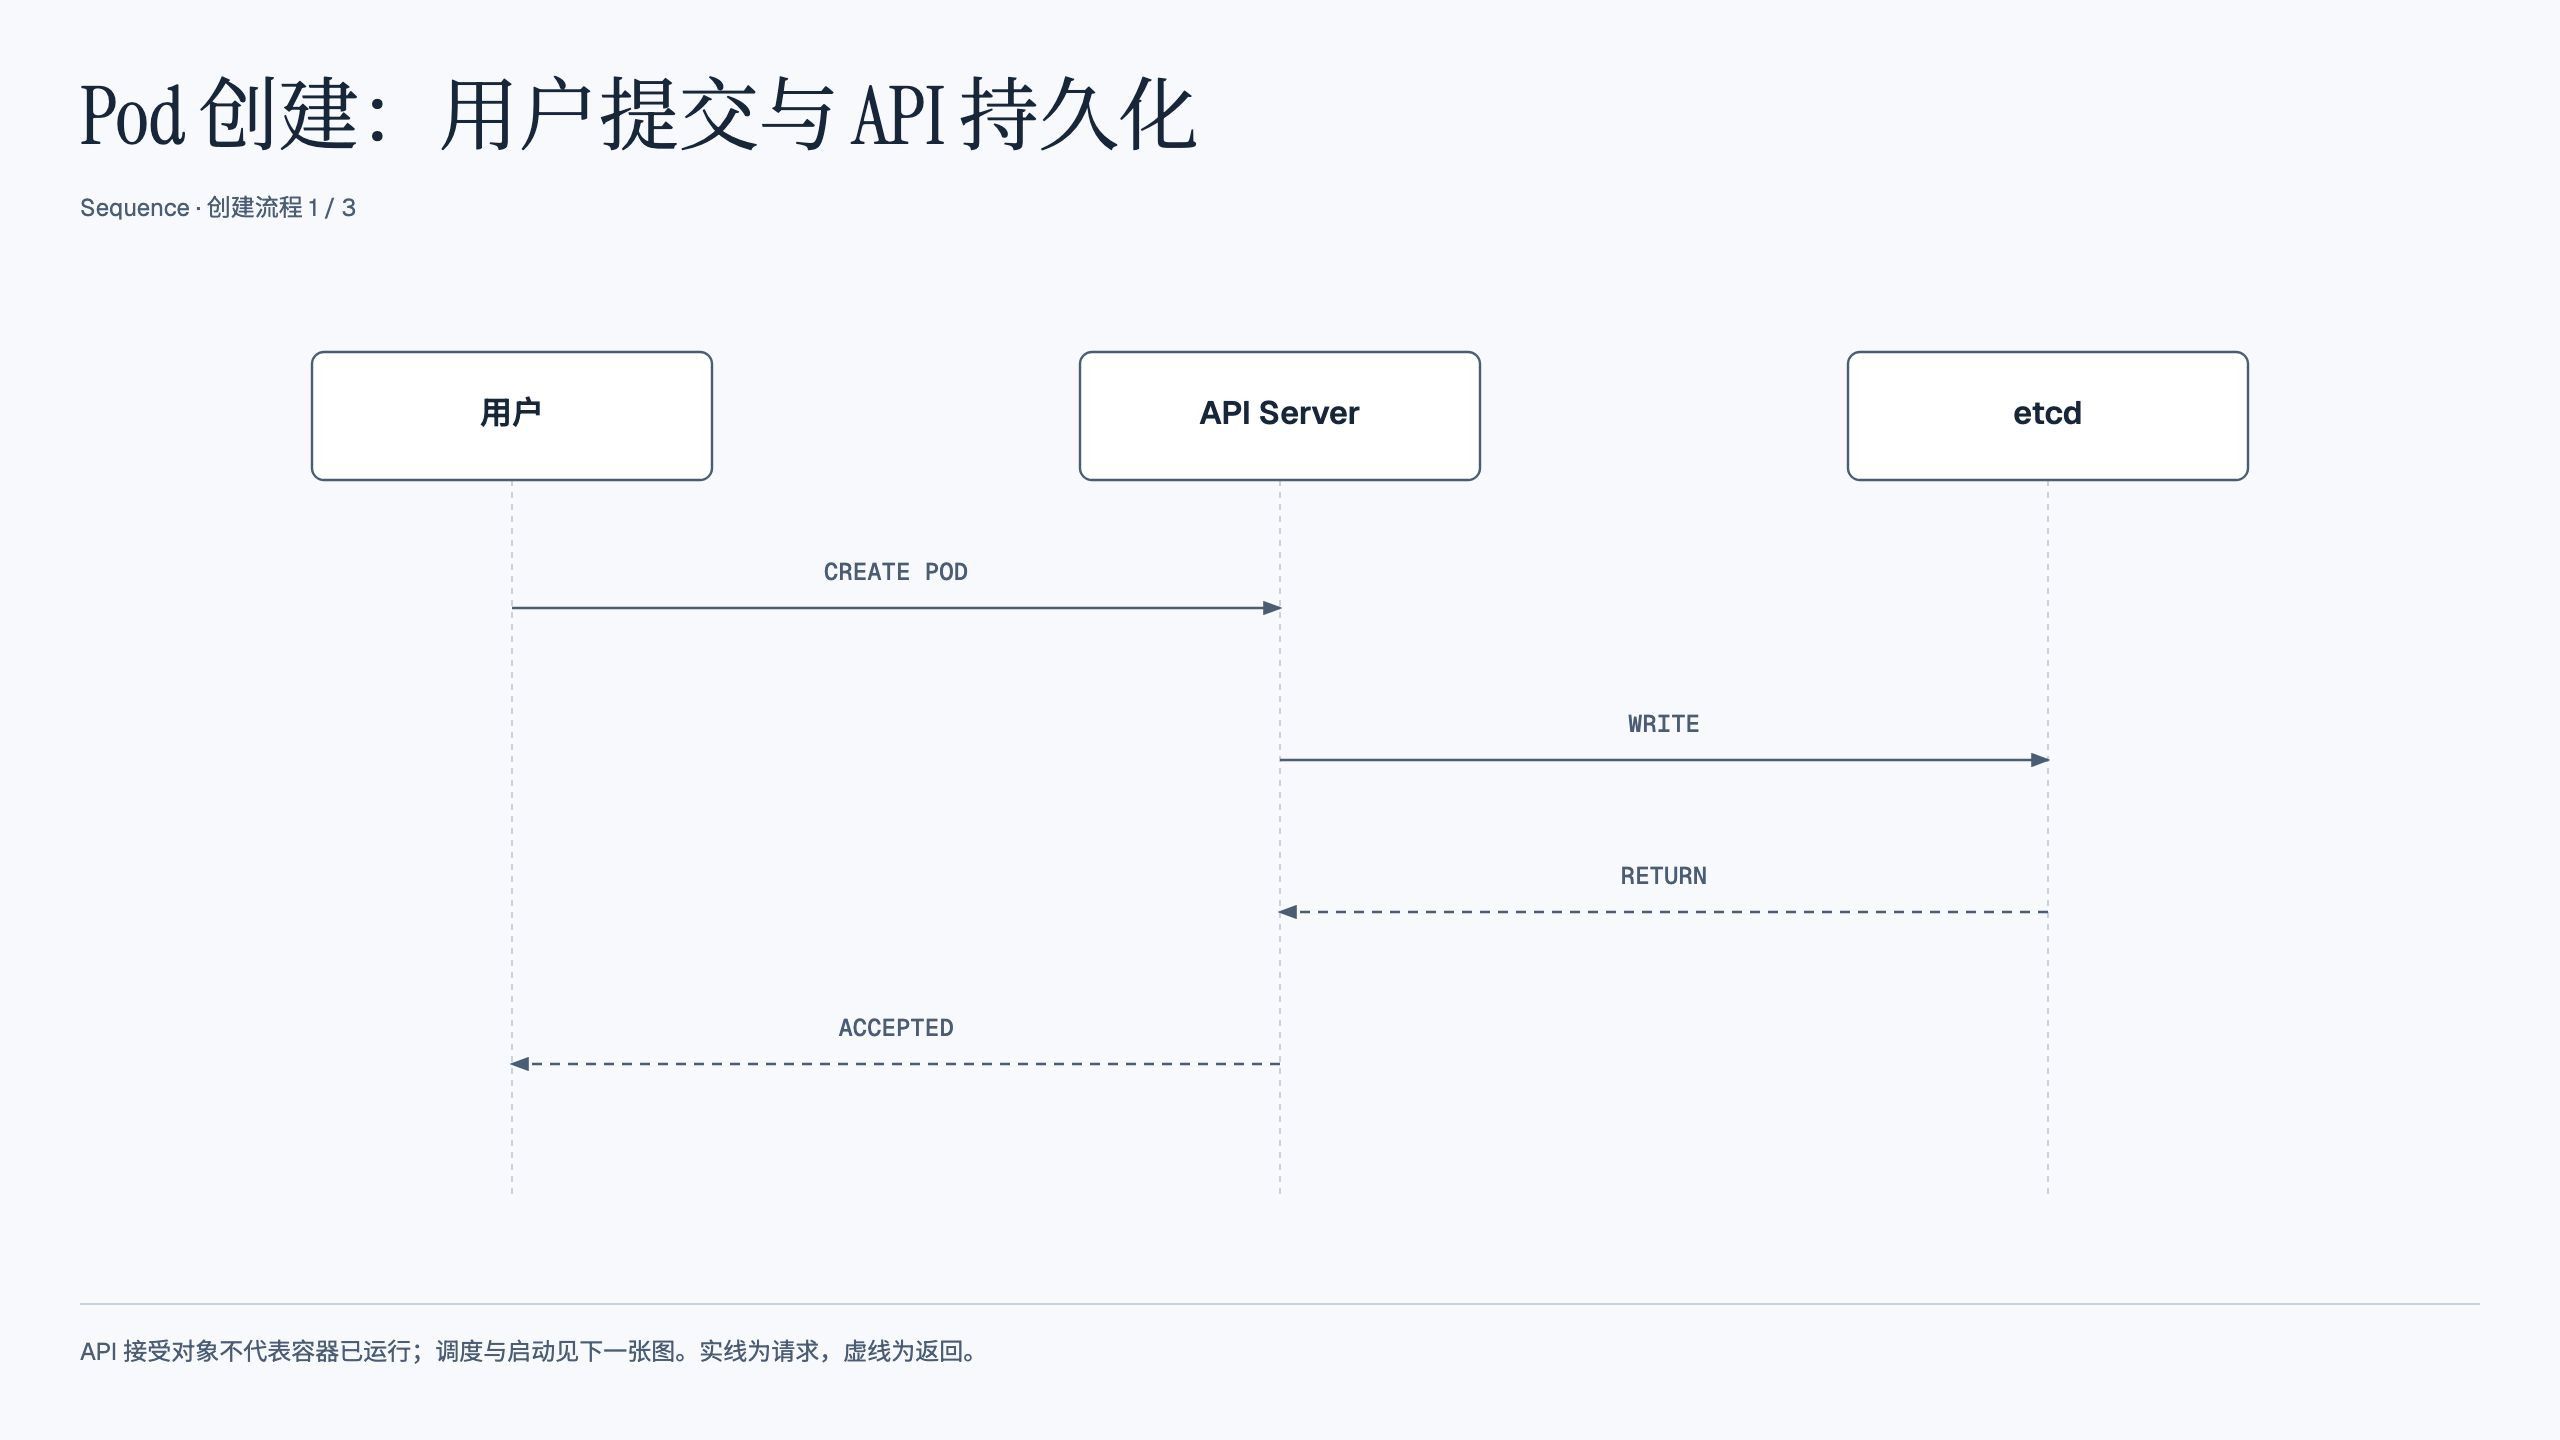
一个普通 Pod 的创建过程可以按下面的顺序理解:
- 用户通过
kubectl或其他 API 客户端向 API Server 提交 Pod 定义。 - API Server 完成校验、准入等处理,把对象持久化到 etcd,并返回请求结果。
- 调度器发现尚未分配节点的 Pod,结合资源与调度约束选择节点,把绑定结果写回 API Server。
- 目标节点上的 kubelet 发现分配给自己的 Pod,协调网络、存储和容器运行时准备运行环境并启动容器。
- kubelet 持续上报状态,API Server 保存更新后的对象信息。
组件通过 API Server 的 watch 等机制观察变化,而不是由 API Server 逐条向所有组件下发执行命令。
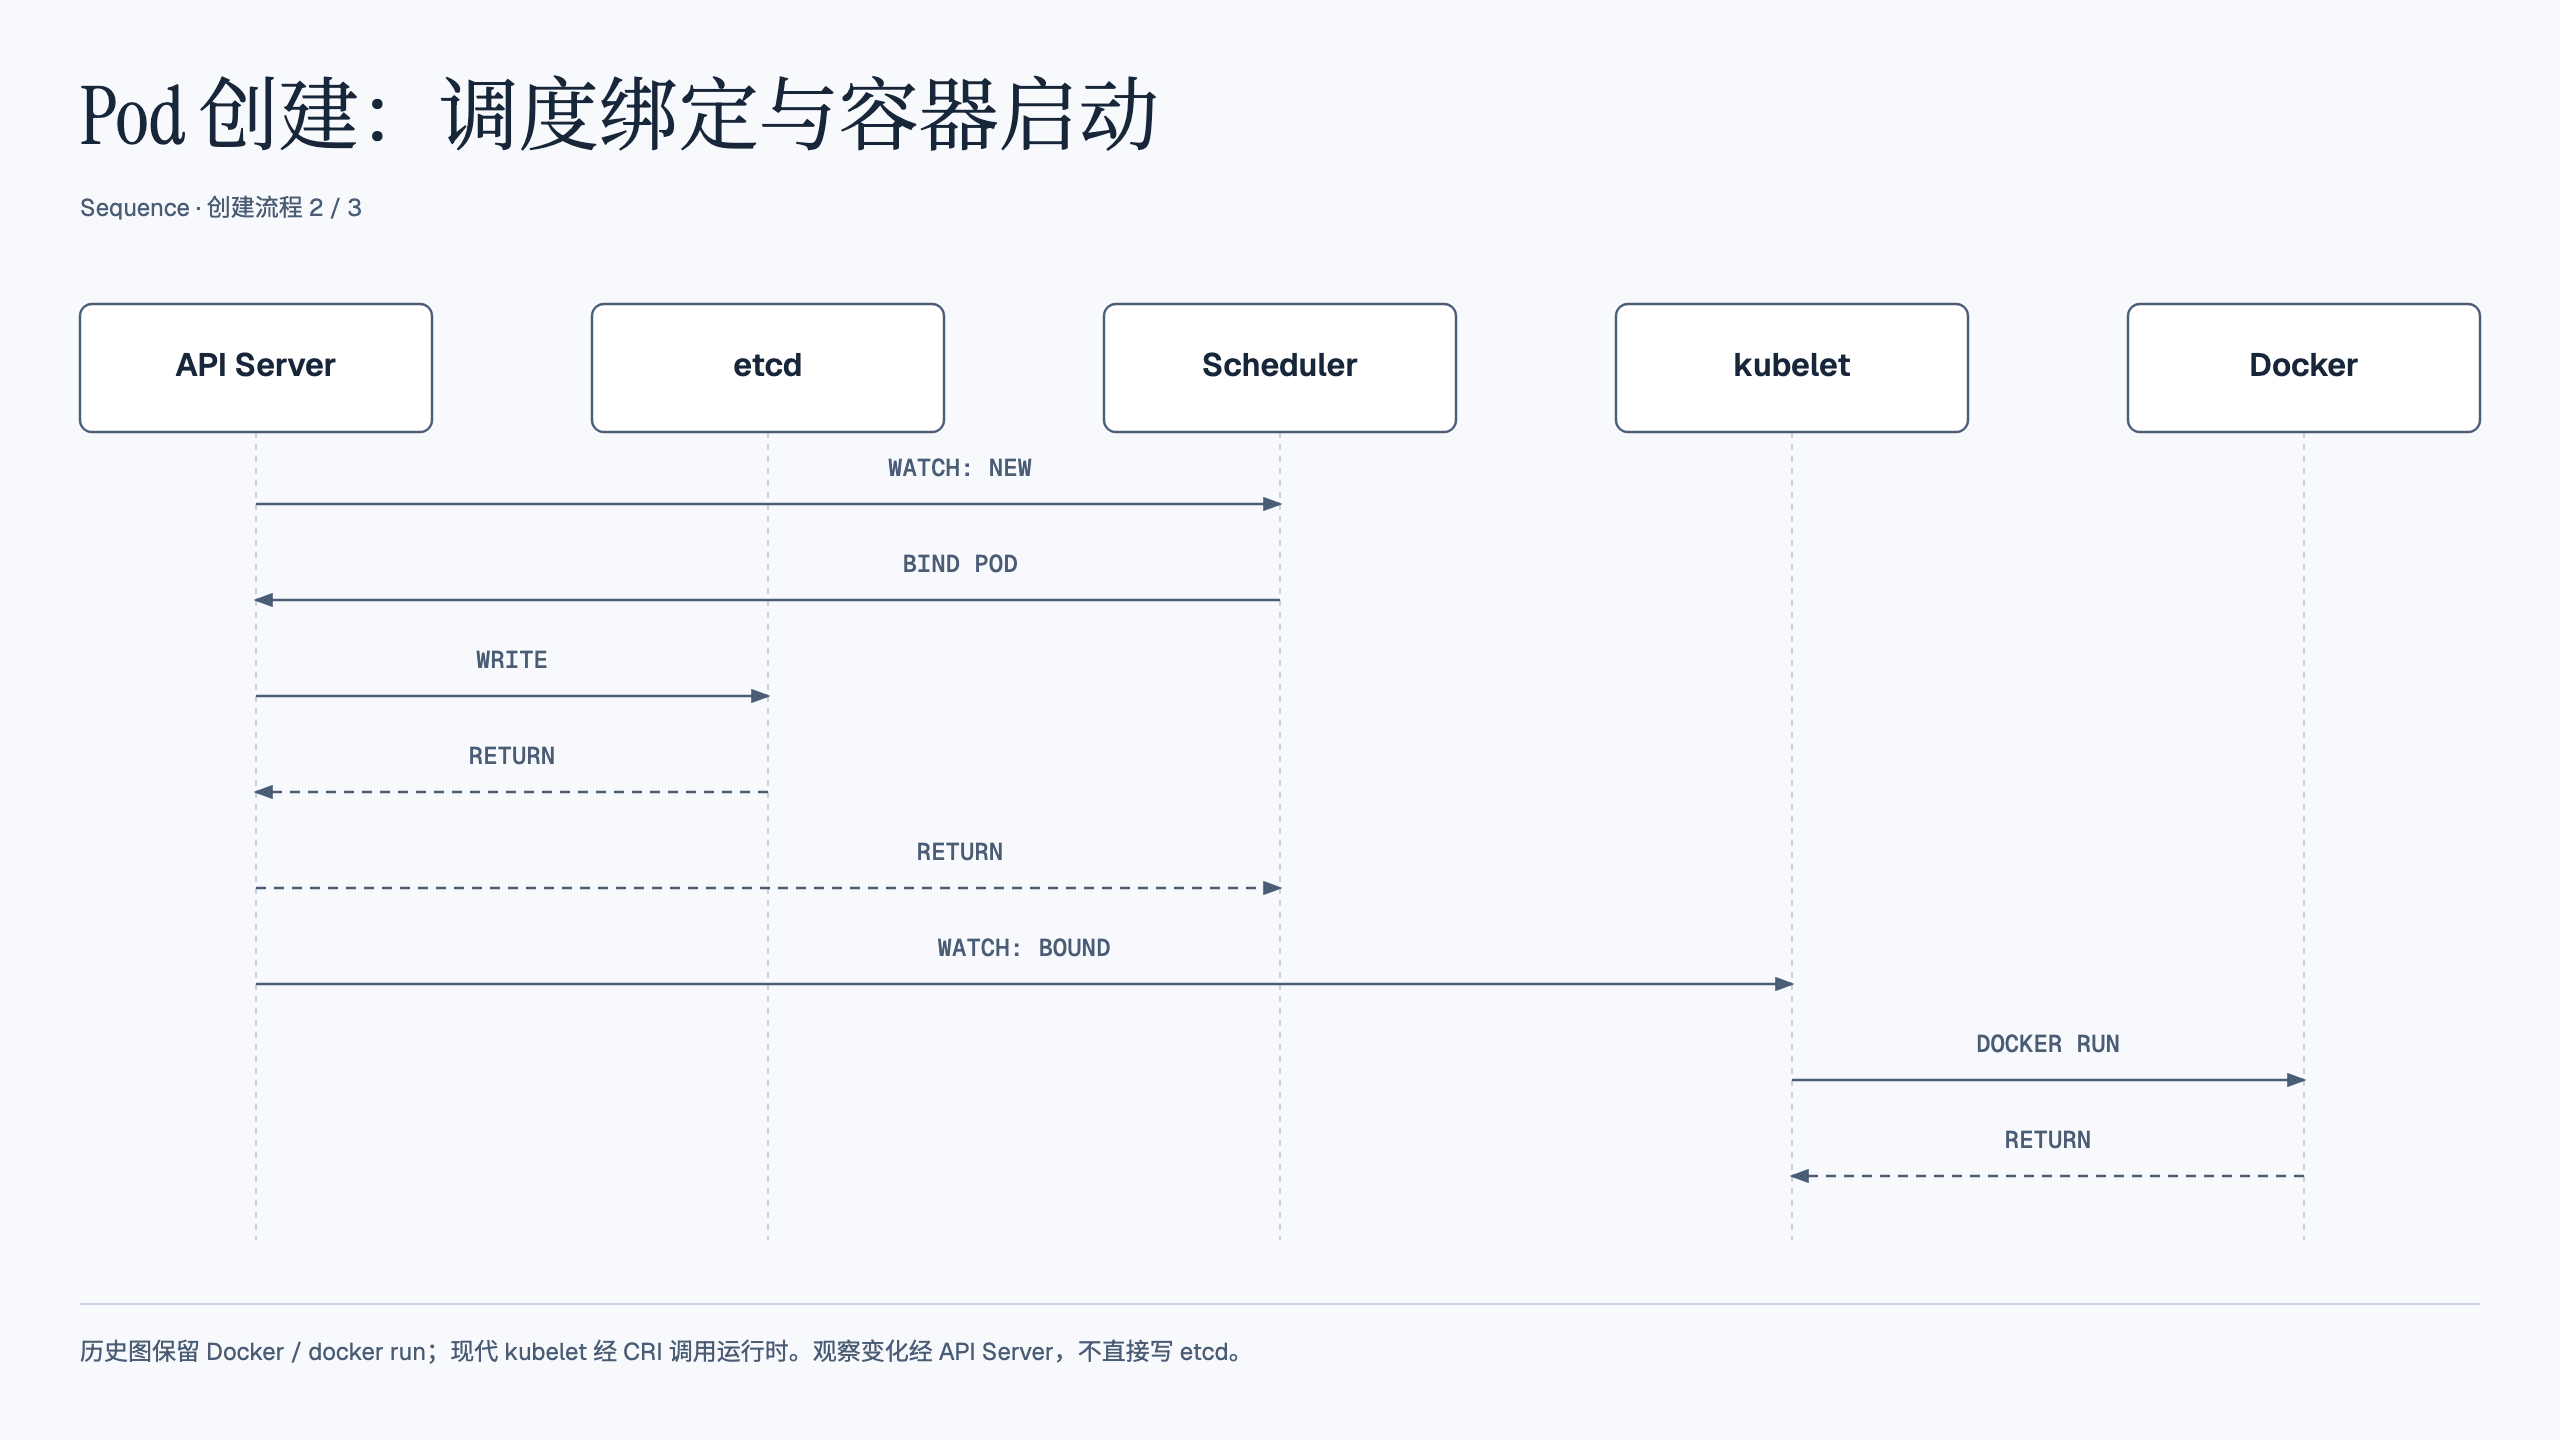
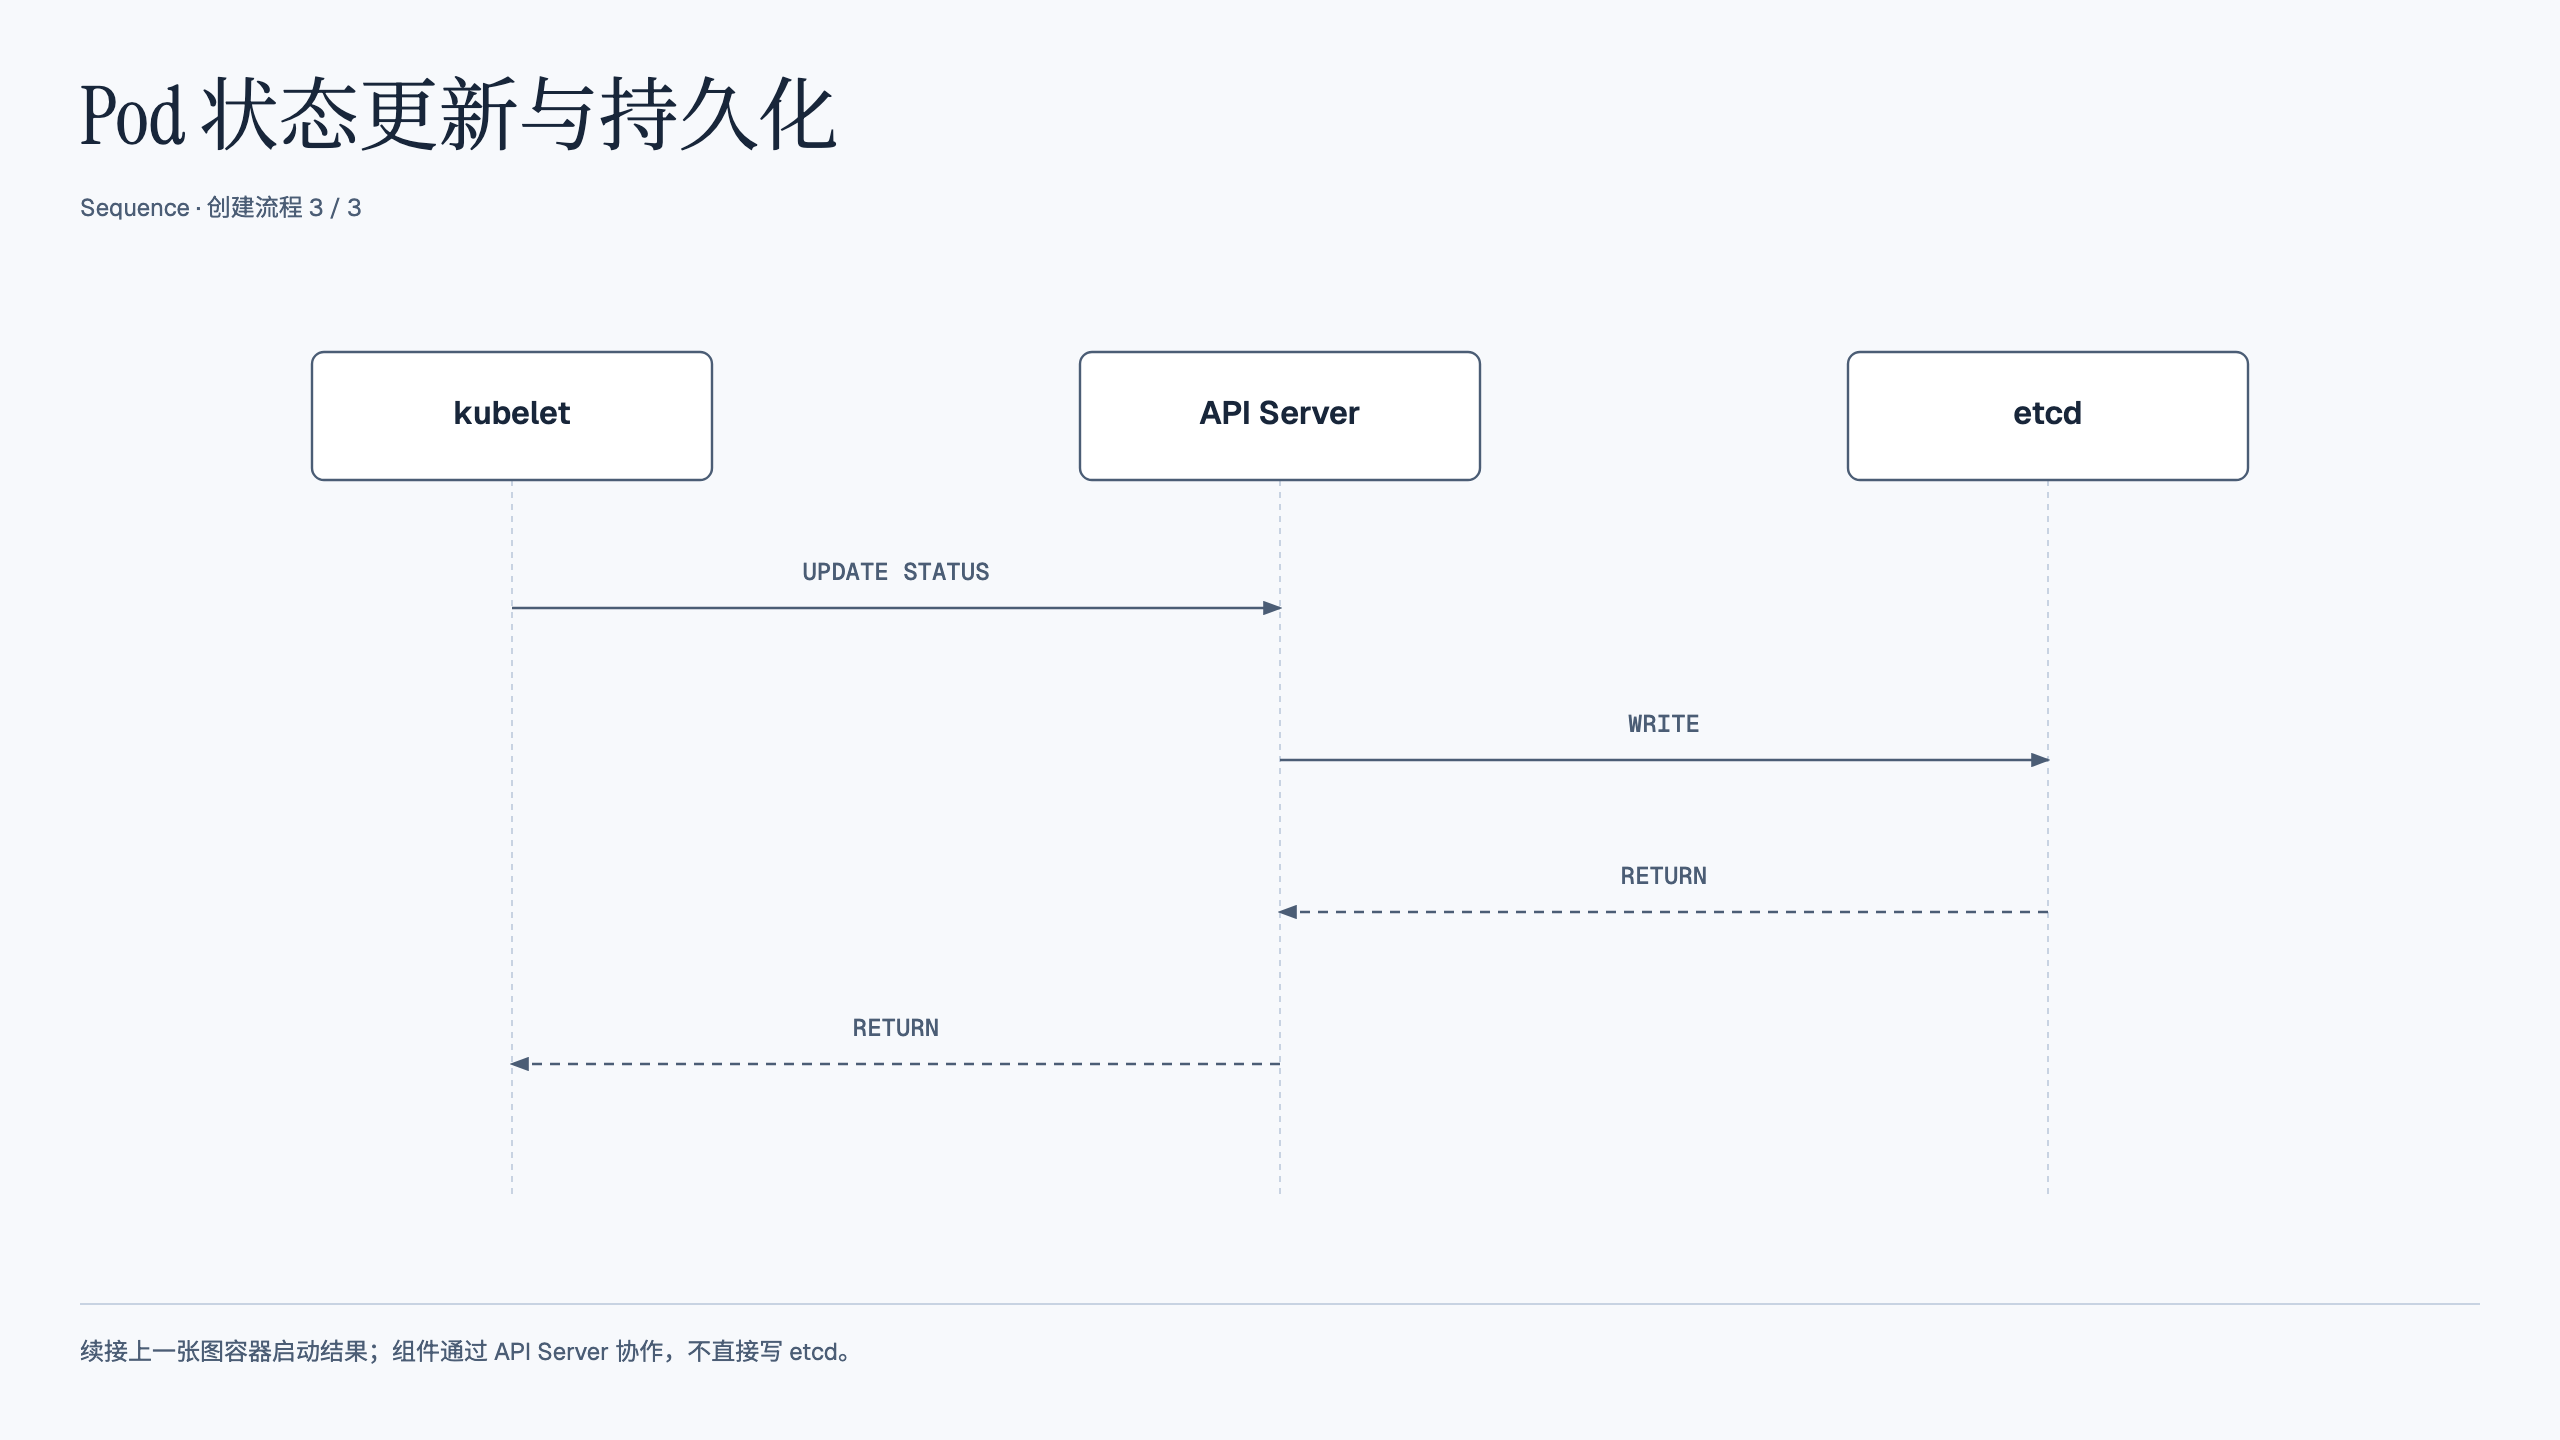
把视角切到 Pod 内部,启动主线则是:准备 sandbox 和卷,执行普通 Init Container,再启动应用容器;如果配置了 Startup Probe,等待它成功后才执行 Liveness 和 Readiness。只有满足就绪条件,Pod 才能作为通常意义上的 Service 就绪后端。
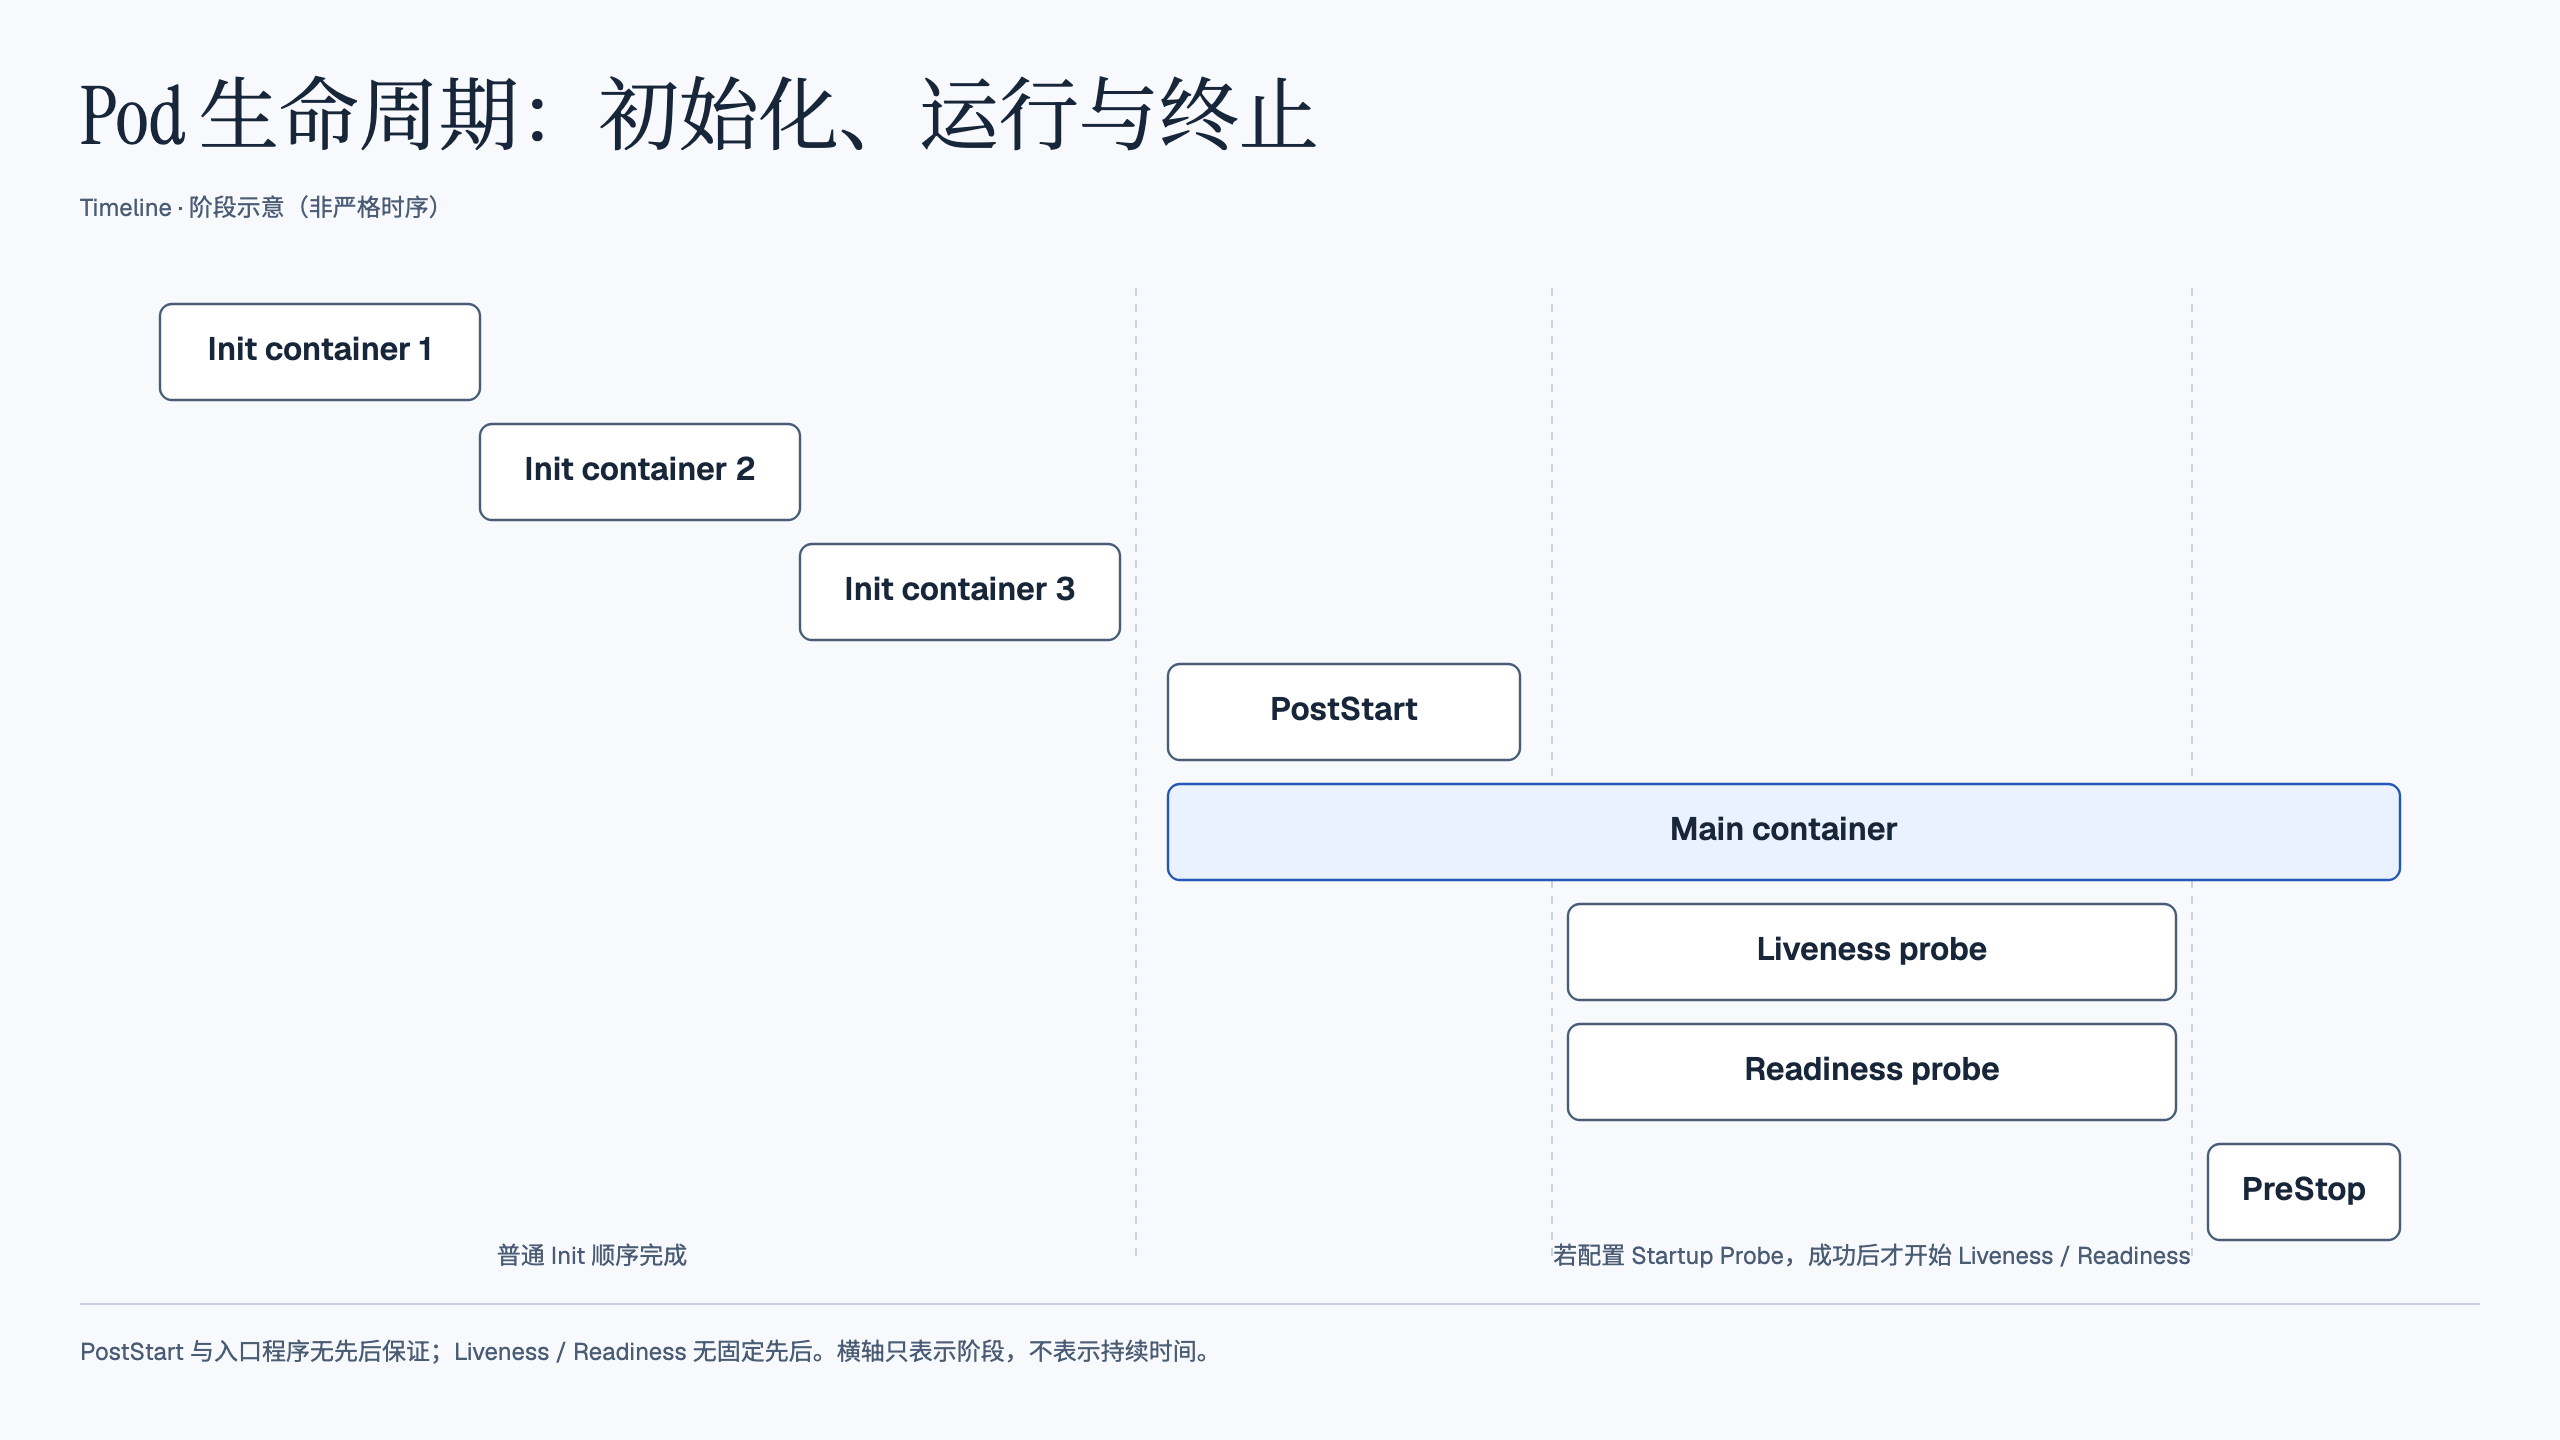
图示适合帮助理解各阶段,但不是所有事件的严格时序图。例如,PostStart 与容器入口程序之间没有先后保证,Liveness 与 Readiness 也没有固定的执行顺序。
Init Container:把必须先完成的工作放在启动之前
普通初始化容器定义在 spec.initContainers 中。多个 Init Container 按定义顺序执行,前一个成功结束后才运行下一个;全部成功后,应用容器才开始运行。失败后是重试还是让 Pod 失败,还受重启策略影响。
它适合下载文件、生成初始配置或等待启动前置条件。初始化容器与应用容器可以使用不同镜像,通过显式挂载的共享卷传递结果。在 Deployment、DaemonSet、StatefulSet、Job 等资源中,也是在各自的 Pod 模板内配置它。
普通 Init Container 不支持 lifecycle、livenessProbe、readinessProbe、startupProbe,因为它应当执行完成后退出。这里要与使用 initContainers 声明、设置容器级 restartPolicy: Always 的原生 sidecar 区分。
下面的示例先下载页面,再由 Nginx 提供访问。下载成功依赖镜像中的工具、DNS 和外部站点连通性:
#主容器运行nginx服务,初始化容器用来给主容器生成index.html文件
apiVersion: v1
kind: Pod
metadata:
  name: init-nginx
spec:
  volumes:
  - name: pod-workdir
    emptyDir: {} # Pod 级临时卷,供两个容器共享
  initContainers:
  - name: install
    image: docker.io/library/busybox:1.28
    imagePullPolicy: IfNotPresent
    command:
    - wget
    - "-O"
    - "/work-dir/index.html"
    - "https://www.baidu.com" #把百度主页下下来存到这个目录
    volumeMounts:
    - name: pod-workdir
      mountPath: /work-dir
  containers:
  - name: nginx
    image: nginx:latest
    imagePullPolicy: IfNotPresent
    ports:
    - containerPort: 80
    volumeMounts:
    - name: pod-workdir
      mountPath: /usr/share/nginx/html # 两个容器显式挂载同一个卷,在不同路径看到同一份文件。
emptyDir 是随 Pod 创建的临时卷,不是把某个指定宿主机目录直接挂入容器。它可以跨容器重启保留数据,但 Pod 从节点移除后,其中的数据会丢失。两个容器分别挂载到 /work-dir 和 /usr/share/nginx/html,因此访问的是同一份文件。
如果另一个 Pod 定义了两个初始化容器,列表中可能看到这样的输出:
pod-init   0/1     Init:0/2   0          7s
#Init: 0/2,表示两个初始化容器未完成
Init:0/2 表示两个初始化容器中还没有一个完成,需要继续查看初始化容器的日志和事件,而不是先排查尚未启动的主容器。
状态:先区分 Pod phase 与列表中的 STATUS
kubectl get pods 的 STATUS 列会展示便于排障的信息,它不总是 Pod 的 status.phase。例如 CrashLoopBackOff 和 Terminating 都不属于 Pod phase。
Pod phase 只有下面五类:
| Phase | 含义与排查入口 |
|---|---|
Pending | 对象已被接收,但一个或多个容器尚未准备好;可能还在等待调度、镜像或运行环境。先看 describe 与 Events。 |
Running | Pod 已绑定节点,容器已创建,至少一个容器仍在运行、启动或重启。它不保证应用已经就绪。 |
Succeeded | 所有容器均成功终止,且不会再重启。可查看任务日志确认结果。 |
Failed | 所有容器均已终止,且至少一个以失败结束。结合退出码、日志和 Events 判断原因。 |
Unknown | 无法获取 Pod 状态,通常涉及节点通信等问题。 |
日常排障中还会看到这些状态、原因或展示值:
| 展示值或原因 | 通常说明什么 |
|---|---|
ContainerCreating | 容器运行环境仍在准备,可能涉及镜像、网络、卷挂载或配置问题。 |
ErrImagePull / ImagePullBackOff | 镜像拉取失败或正在退避重试,检查镜像地址、网络和认证。 |
CrashLoopBackOff | 容器反复退出,kubelet 正在延迟下一次重启;检查启动命令、上一轮日志、退出原因和探针事件。 |
OOMKilled | 容器进程被 OOM 机制终止,检查内存 limit、实际使用、内存泄漏及节点压力。 |
Terminating | Pod 已进入删除流程,检查钩子、宽限期、节点状态及其他删除阻塞原因。 |
SysctlForbidden | 请求的内核参数未获允许或不受支持,检查 sysctl 配置与节点策略。 |
Completed | 常用于展示容器正常完成的终止原因,任务执行结束时可以看到。 |
Error | 容器失败终止时的常见展示值,需要进一步检查具体原因。 |
Evicted | Pod 被驱逐,常见原因包括节点内存、磁盘等资源压力。 |
默认情况下,反复失败的容器重启采用指数退避,例如 10、20、40 秒,最长到 300 秒;持续正常运行一段时间后会重置。较新版本可调整退避行为,因此这些数字应结合节点配置理解。CrashLoopBackOff 描述的是“正在等待重试”,真正的故障原因仍要从日志和事件中找。
Pod 如何退出:钩子与宽限期
启动和健康检查解决了“什么时候接流”和“什么时候恢复”,退出则要解决相反的问题:如何停止接收新请求,并尽量处理完正在进行的工作。
PostStart 与 PreStop 分别在什么时机执行
容器生命周期钩子定义在 spec.containers[].lifecycle 下:
postStart在容器创建后触发,与容器入口程序之间没有先后保证。可以处理不要求先于主程序完成的轻量动作;必须完成后才能启动业务的准备工作,应放进 Init Container。它不接收 Kubernetes 额外传入的事件参数,但处理器自身可以定义命令和参数。preStop在 kubelet 发出停止信号前执行,可用于通知下线、触发清理或给流量摘除留出传播时间。它会占用终止宽限期,不能无限阻塞,也不会因为主进程已自行退出而补做清理。
钩子失败可能导致容器被终止,后续行为再由重启策略等机制决定。Kubernetes 没有这里可以替代 postStart 的通用 preStart 钩子。
下面的示例在 postStart 中生成页面,在 preStop 中等待 10 秒:
apiVersion: v1
kind: Pod
metadata:
  name: life-demo
spec:
  containers:
  - name: lifecycle-demo-container
    image: nginx:latest
    imagePullPolicy: IfNotPresent
    lifecycle:
      postStart:
        exec:
          command: ["/bin/sh", "-c","echo 'lifecycle hookshandler' > /usr/share/nginx/html/test.html"]
      preStop:
        exec:
          command: ["/bin/sh", "-c", "sleep 10"] # 为流量摘除的传播留出等待时间
        # 支持 Sleep handler 的集群也可使用以下写法,与 exec 二选一
        # sleep:
          # seconds: 60
preStop 的等待只是给流量切换留出时间,不会自动让应用处理完请求。镜像中的主进程仍需正确处理停止信号。示例注释中的 Sleep handler 在 Kubernetes 1.30 进入 Beta 并默认启用,1.34 成为稳定功能;旧集群应确认支持情况。
一次普通删除,会发生哪些事
对于正常运行、没有其他删除阻塞的 Pod,可以这样理解终止过程:
- 客户端提交删除请求,API Server 给 Pod 记录删除时间和宽限期,列表中通常显示
Terminating。 - kubelet 看到终止请求,开始本地关闭流程;如果容器定义了
preStop且宽限期不为 0,先执行钩子。 - 钩子完成后,kubelet 请求容器运行时向容器主进程发送停止信号,通常为
SIGTERM;镜像或受支持的配置可以指定其他停止信号。应用应停止接收新任务并完成必要清理。 - 宽限期到期仍未退出的剩余进程,会被运行时强制终止,通常涉及
SIGKILL。本地终止完成后,kubelet 推进 API 对象的删除。
与节点关闭过程并行,控制平面也在更新 EndpointSlice:终止中的端点通常标记为 terminating,并不再作为常规就绪后端。传播到代理和客户端需要时间,不应假定“端点已更新”和“所有流量都已停止”是同一瞬间。
普通容器的停止顺序没有统一保证;原生 sidecar 有相应的终止顺序机制。上述行为通过 kubelet 和容器运行时完成,不能统一理解为 Kubernetes 在节点上执行 docker stop。
宽限期包含 preStop,也包含应用自己的退出时间
spec.terminationGracePeriodSeconds 默认是 30 秒。如果 preStop 在期限结束时仍未完成,kubelet 会请求一次很短的 2 秒扩展;这不是给应用额外保留的一整段正常退出时间。
因此,在默认 30 秒宽限期下写一个 90 秒的 preStop,不会自动获得 90 秒等待。如果业务确实需要更长时间处理长连接,应设置合适的 spec.terminationGracePeriodSeconds,例如 90,并让“钩子耗时 + 应用退出耗时”落在预算内。若钩子本身就等待 90 秒,仅把总宽限期设成 90 秒仍不足以给后续清理留出空间。
删除命令也可以用 --grace-period=<秒数> 指定宽限期。强制删除的示例如下:
# 强制删除pod
kubectl delete pod <pod-name> --force --grace-period=0
--force --grace-period=0 会绕过正常优雅终止,并使 API 对象立即删除,但不保证节点上的进程已经停止。尤其在节点失联时,不能把“列表里看不到 Pod”当作业务进程已退出的证据。
生产发布:把流量切换与应用生命周期对齐
单个字段写对,并不等于滚动发布时一定没有中断。需要明确新实例什么时候可以接流,并给旧实例留出退出空间,把启动、接流和终止放在同一条流程中考虑。
旧实例退出时,应用应处理停止信号、停止接收新工作,并在宽限期内完成存量请求。preStop 可以承载必要的下线动作或等待传播,但仅仅 sleep 一段时间,不能保证长连接和未完成请求都已结束。多副本、滚动更新策略和负载均衡行为也需要一起验证。
如果流量经过 Eureka 或 Nacos,摘流链路也要一起检查
有些 Spring Cloud 应用把 Pod IP 注册到 Eureka、Nacos,调用方直接根据注册表访问实例。这时,请求可能并不经过 Kubernetes Service,不能只检查 Service 后端是否更新。
更新过程中,即使旧 Pod 已经开始退出,注册中心或客户端缓存中的旧地址仍可能继续被使用。可以结合实际框架选择以下做法:
- 在下线前调用注销或状态更新接口,并确认客户端如何刷新地址;这一方案需要应用与调用方配合。
- 先向应用发出下线信号,再通过合适的
preStop等待时间覆盖地址传播,且将整个过程计入终止宽限期。 - 在架构允许时,使用 Kubernetes Service 统一服务发现,并验证 EndpointSlice、代理和调用方连接的更新过程。
Kubernetes 的服务发现不能概括为“替代整个 Spring Cloud”。Spring Cloud 还包括配置管理、熔断、路由等能力,迁移应逐项判断功能与调用路径。
日常调试:让容器运行并找到故障线索
到这里,Pod 从启动到退出的主线已经完整。实际排障时,还需要分清主进程是否存活、应用是否可用,以及日志来自当前实例还是上一轮实例。
进入指定容器
多容器 Pod 可以通过 -c 选择目标容器:
kubectl exec -it <pod-name> -c <container-name> -- /bin/bash命令中既要有 Pod 名,也要有容器名。镜像不包含 Bash 时,可以尝试 /bin/sh;精简镜像也可能没有 Shell。
长时运行:先确认主进程应该做什么
持续运行的业务通常让服务进程在前台运行。任务完成后本来就应该退出的程序,则更适合按任务语义选择 Job 等资源,不需要为了保持 Pod 的 Running 状态再加一个无限等待进程。
在临时调试场景中,下面两种写法可以让容器保持运行,方便进入环境检查。
使用 tail 等待。
apiVersion: v1
kind: Pod
metadata:
  name: tail-pod
spec:
  containers:
  - name: nginx
    image: nginx:latest
    command: ["tail", "-f", "/dev/null"]
它会持续等待,并不提供业务服务。尤其要注意,这里覆盖了 Nginx 镜像的默认入口,因此并没有启动 Nginx。
使用 sleep 暂停。
apiVersion: v1
kind: Pod
metadata:
  name: sleep-pod
spec:
  containers:
  - name: alpine
    image: alpine:latest
    command: ["sleep", "infinity"]
sleep infinity 通常开销很低,但仍需镜像中的 sleep 实现支持该参数。这同样只适合需要保留调试环境等场景。
Tini 解决 PID 1 问题,不负责业务自动拉起
Tini 是轻量级容器 init,主要处理信号转发和僵尸子进程回收。它启动的主子进程退出后,Tini 也会退出,并沿用子进程的退出码;它不是让业务永久运行、失败后自动拉起的进程监督器。
下面的镜像包装方式示意如何让 Tini 作为入口。your-main-process 是占位名称,实际构建还要把应用及其依赖放进镜像,并选择与目标平台匹配的 Tini 二进制:
FROM ubuntu:latest
ADD https://github.com/krallin/tini/releases/download/v0.19.0/tini /tini
RUN chmod +x /tini
ENTRYPOINT ["/tini", "--"]
CMD ["your-main-process"]
构建命令与 Dockerfile 分开执行:
docker build -t your-image-with-tini .Pod 可以通过 args 传入要运行的程序,保留镜像里的 Tini ENTRYPOINT:
apiVersion: v1
kind: Pod
metadata:
  name: tini-pod
spec:
  containers:
  - name: my-container
    image: your-image-with-tini
    args: ["your-main-process"] # 保留镜像中的 Tini ENTRYPOINT
看日志时,先确定是哪个容器、哪一轮运行
kubectl logs 默认读取容器标准输出、标准错误对应的日志。多容器 Pod 应明确选择容器,反复退出的容器则可以用 --previous 读取上一次已终止实例的日志。默认情况下,kubelet 保留一个已终止容器及其日志,不代表能够回看任意多轮历史;需要长期留存时,应依赖集中日志系统。
kubectl logs <pod-name>
# 读取指定容器上一次已终止实例的日志
kubectl logs --previous <pod-name>

# 查看 Pod 内所有应用容器的日志
kubectl logs mypod --all-containers=true
# 查看指定容器的日志
kubectl logs mypod -c container-name

# 查看当前命名空间中的事件
kubectl get events
kubectl get events --field-selector involvedObject.name=podName
遇到问题,可以先沿着“Events → 容器状态与退出原因 → 当前及上一轮日志 → 实际生效配置”排查。如果重启与健康检查有关,还要把探针事件和重启前的依赖延迟放在一起,判断重启是否真的能够修复故障。