Kubernetes 健康探针:从配置原理到重启风暴排查
发布一个新版本后,Pod 已经显示为 Running,请求却还在失败。应用可能正在加载配置、建立连接或预热缓存,进程虽然启动了,业务仍没有准备好。另一种情况出现在运行一段时间之后:进程没有退出,端口也在监听,处理请求的主循环却已经卡住。
这两种情况需要不同的处理。还在初始化的实例需要时间,暂时过载的实例可能需要先停止接收新请求,无法自行恢复的进程则可能需要重启。如果只用一个“健康或不健康”的结果来决定所有动作,就很容易把原本能恢复的短暂故障变成反复重启。
Kubernetes 用 Startup、Readiness 和 Liveness 三类探针表达这些差异。应用负责提供能反映自身状态的检查方式,节点上的 kubelet 负责执行检查,并根据结果调整就绪状态或终止容器。配置探针时,检查的内容与失败后的动作必须对应起来。
从 Running 到可用,还需要应用自己的判断
Pod 的 Running 是生命周期中的一个阶段。它说明容器已经被创建,且至少有一个容器正在运行、启动或重启,并不保证应用已经能处理业务请求。Ready 表达的是另一层状态:Pod 当前是否具备接收流量的条件。排查“Pod 看起来正常,服务却不可用”时,需要把这两层状态分开看。
如果容器内的主进程退出,kubelet 可以根据 restartPolicy 处理;对于进程仍在运行、内部却已卡死的情况,还需要应用提供额外的判断依据。健康探针就是 kubelet 获取这些依据的方式。它可以执行容器内的命令,也可以发起网络请求,但检查能覆盖什么故障,取决于命令或接口实际检查了什么。
探针配置在容器上。Startup 或 Liveness 失败达到阈值后,kubelet 终止的是对应容器,再按重启策略处理;这个动作通常发生在原 Pod 内,不会因此删除整个 Pod 或把它重新调度到其他节点。Readiness 失败则保留容器运行,调整 Pod 的就绪状态。
三类探针,各自负责什么
先确定失败后希望 Kubernetes 做什么,再选择探针类型,会比直接套一份 YAML 更容易判断配置是否合适。
| 探针 | 要回答的问题 | 达到失败阈值后的主要动作 |
|---|---|---|
startupProbe | 本轮容器启动是否已经完成? | 终止该容器,再按重启策略处理。 |
readinessProbe | 当前是否适合接收业务流量? | 标记未就绪,停止作为常规 Service 的就绪后端;不重启容器。 |
livenessProbe | 是否出现需要重启才能恢复的内部故障? | 终止该容器,再按重启策略处理。 |
Startup Probe 适合启动耗时较长或波动较大的应用。它为初始化单独设置一段容忍时间,避免应用尚未启动完成,就被 Liveness 判定为故障。初始化、迁移、缓存预热等条件是否需要纳入检查,应由应用的启动要求决定。
Readiness Probe 关注当前的接流能力。应用可能已经完成启动,却因关键连接未恢复或负载过高而暂时无法处理新请求。此时停止接流、保留进程运行,可以给它留下恢复空间。就绪检查也会在运行期间继续执行,恢复成功后,实例可以重新成为就绪后端。
Liveness Probe 适合识别主循环卡死、不可恢复的死锁等内部故障。判断时需要考虑重启是否有助于恢复。外部数据库短暂不可用,通常不应直接导致本进程被重启,因为重启应用并不能修好数据库。
Startup 成功后,另外两类探针各自工作
配置了 Startup Probe 时,Liveness 和 Readiness 都要等它成功后才开始执行。Startup 一旦成功,本轮启动便不再执行这项检查;容器再次启动时会重新检查。
此后,Liveness 与 Readiness 按各自的配置工作。Liveness 不需要等待 Readiness 先成功,也不会等 Readiness 失败后才运行。Kubernetes 对探针的说明明确区分了它们的执行条件,因此,“先摘流、再决定是否重启”需要通过健康语义和时间预算来设计,不能依赖固定的探针先后顺序。
三类探针都是可选配置。未配置某类探针时,其默认结果按成功处理,这只代表没有执行这项业务检查。是否需要同时配置三种,应由应用的启动过程和故障模式决定。
探测方式和参数,决定怎样判断健康
根据应用能提供的信号选择探测方式
探针类型决定失败后的处置,探测方式决定如何取得结果。每个探针选择一种方式:
exec在容器内执行命令,退出码为 0 表示成功。镜像中必须包含所需命令。tcpSocket由 kubelet 尝试连接目标端口,建立连接即表示成功。它只能证明端口可连接。httpGet通常向 Pod IP 的指定端口和路径发送 HTTP GET,状态码 200 至 399 表示成功。grpc要求应用实现 gRPC Health Checking Protocol,返回SERVING表示成功。
例如,Java 应用的端口仍在监听,业务线程却可能已经无法继续工作,单纯 TCP 检查很难识别这类问题。HTTP 或 gRPC 接口可以表达更细的状态,前提是接口的实现确实覆盖了目标故障;如果健康接口只是固定返回成功,也无法说明业务正常。没有合适接口时可以使用 TCP,同时接受它只能检查连通性的边界。
先读懂字段,再计算时间预算
探测多久执行一次、一次最多等多久、连续失败多少次才采取动作,是不同的配置项。
| 字段 | 默认值 | 作用 |
|---|---|---|
initialDelaySeconds | 0 秒 | 开始探测前的初始延迟,最小为 0。配置 Startup Probe 后,按当前官方文档,Liveness、Readiness 的延迟在 Startup 成功后才开始计算。 |
periodSeconds | 10 秒 | 探测周期,最小为 1 秒。Pod 未就绪时,Readiness 可能在周期之外额外执行,以便更快恢复就绪。 |
timeoutSeconds | 1 秒 | 单次探测的超时时间,最小为 1 秒。 |
failureThreshold | 3 | 连续失败多少次后判定失败,最小为 1。 |
successThreshold | 1 | 失败后需要连续成功多少次才恢复成功,最小为 1;Startup 和 Liveness 必须为 1。 |
可以用 failureThreshold × periodSeconds 估算一组配置的容忍时间量级。例如,Startup 每 5 秒探测一次,允许连续失败 30 次,对应约 150 秒的启动预算。这个乘积适合帮助理解参数,实际动作时间还受到初始延迟、探测在故障发生时所处的位置、请求耗时和容器退出过程的影响,不能当作精确倒计时。
启动与运行期间,需要不同的容忍程度
Startup 的预算应覆盖初始化耗时的合理上界。5 秒周期、30 次失败阈值只是一个演示组合;假设某应用实测单次健康请求通常在 1 至 5 秒内完成,就应根据这份耗时分布评估超时预算。这里的范围只是举例,实际取值应以应用的测量结果为准。
Readiness 的参数取决于希望多快停止向故障实例接流,以及能够接受多大程度的抖动。successThreshold: 1 可以较快恢复接流;如果实例容易在 Ready 与 NotReady 之间来回变化,可以评估增加连续成功次数的效果,同时观察恢复接流是否变慢。
Liveness 则要给可恢复的内部抖动留出空间。轻量应用 5 至 10 秒、重型应用 30 至 60 秒的周期,可以作为测试时讨论的候选值,最终仍要根据正常延迟、故障恢复时间和可接受的发现时间决定。没有 Startup 时,需要给初始化留出足够延迟;配置了 Startup 后,也应检查运行期的初始延迟是否仍有必要。
周期太短会增加节点和应用的检查负担,超时或失败阈值过严可能误杀;Readiness 周期过长,又可能使故障实例继续接收新请求。参数需要在压测和故障演练中验证,不能统一采用“失败两次就重启”。
配置示例:从单项检查到组合使用
下面按应用启动、接流、运行期间恢复的场景展开配置。独立 Pod 和 Service 用来演示机制,实验镜像及应用接口需要自行准备。业务由 Deployment 等工作负载管理时,应把探针写入相应的 Pod 模板。
Startup Probe:给慢启动应用留出时间
固定增大 Liveness 的 initialDelaySeconds 可以避开部分启动问题,但固定等待值很难适应初始化耗时的变化。Startup Probe 可以为启动单独保留较大的容忍窗口,同时让运行期间的 Liveness 保持合适的检测速度。只要 Startup 在窗口内成功,另外两类探针便可以按各自配置开始工作,不必等满整个窗口。
如果用 Exec 检查 Tomcat 进程,镜像需要包含 ps、grep,并根据实际进程调整匹配方式。[t]omcat 可以避免仅匹配到 grep 命令自身。这个例子检查的是进程存在,业务初始化是否完成还需要更准确的信号。
apiVersion: v1
kind: Pod
metadata:
  name: startupprobe
spec:
  containers:
  - name: startup
    image: tomcat-8.5-jre8:v1
    imagePullPolicy: IfNotPresent
    ports:
    - containerPort: 8080
    startupProbe:
      exec:
        command:
        - "/bin/sh"
        - "-c"
        - "ps aux | grep '[t]omcat'"
      initialDelaySeconds: 20 #容器启动后多久开始探测
      periodSeconds: 20 #执行探测的时间间隔
      timeoutSeconds: 10 #探针执行检测请求后,等待响应的超时时间
      successThreshold: 1 #成功多少次才算成功
      failureThreshold: 3 #失败多少次才算失败
如果应用的启动完成条件确实可以用“开始监听端口”表达,可以把容器内的 Startup 配置替换为 TCP 检查:
startupProbe:
  tcpSocket:
    port: 8080
  initialDelaySeconds: 10 #容器启动后多久开始探测
  periodSeconds: 5 #执行探测的时间间隔
  timeoutSeconds: 2 #探针执行检测请求后,等待响应的超时时间
  successThreshold: 1 #成功多少次才算成功
  failureThreshold: 30 #失败多少次才算失败
应用能提供反映初始化结果的接口时,也可以使用 HTTP 检查。下面默认请求 Pod IP 的 8080 端口,path 指定检查路径,httpHeaders 可携带自定义请求头:
startupProbe:
  httpGet:
    path: /health # 检查路径
    port: 8080
    scheme: HTTP
    # httpHeaders: # 可选,请求头。可以传入一个token做一个简单认证。
    # - name: end-user
      # value: Jason
    # 默认请求 Pod IP:8080,而不是节点的 localhost:8080
  initialDelaySeconds: 20 # 容器启动后多久开始探测。
  periodSeconds: 20 #执行探测的时间间隔
  timeoutSeconds: 10 #探针执行检测请求后,等待响应的超时时间
  successThreshold: 1 # 探测成功多少次才算成功
  failureThreshold: 3 # 探测失败多少次才算失败
这些写法是不同的探测选择。应选取能够表达启动条件的那一种,并根据初始化耗时设置预算。
Readiness Probe:决定当前是否接收新请求
应用预热缓存、等待关键依赖,或者因过载暂时无法继续接流时,可以通过 Readiness 返回失败。容器会继续运行,Pod 则进入未就绪状态。
对常规 Service 流量,控制平面会更新相应后端的就绪信息,Service 转发通常不再选择这个未就绪实例。EndpointSlice 可以保留端点记录并表达其状态,因此“摘流”不等于立即删除整条端点记录,也不等于网络层禁止直接访问 Pod IP。配置了 publishNotReadyAddresses 的 Service 还有不同的行为,详见官方对 EndpointSlice 就绪条件的说明。
下面的 Spring Boot 示例在 8081 端口提供健康接口,并通过 NodePort Service 暴露业务与管理端口:
apiVersion: v1
kind: Pod
metadata:
  name: springboot
  labels:
    app: springboot
spec:
  containers:
  - name: springboot
    image: docker.io/mydlqclub/springboot-helloworld:0.0.1
    imagePullPolicy: IfNotPresent
    ports:
    - name: server
      containerPort: 8080
    - name: management
      containerPort: 8081
    readinessProbe:
      initialDelaySeconds: 20
      periodSeconds: 5
      timeoutSeconds: 10
      httpGet:
        scheme: HTTP
        port: 8081
        path: /actuator/health
---
apiVersion: v1
kind: Service
metadata:
  name: springboot
  labels:
    app: springboot
spec:
  selector:
    app: springboot
  type: NodePort
  ports:
  - name: server
    port: 8080
    targetPort: 8080
    nodePort: 31180
  - name: management
    port: 8081
    targetPort: 8081
    nodePort: 31181
配置 Readiness 后,需要等探测成功,Pod 才能成为常规的就绪后端;后续探测失败则触发摘流,恢复成功后重新加入。选择接口时,要确认它表达的是当前能否处理请求,避免直接把包含所有依赖的总健康状态当作接流依据。
Liveness Probe:识别需要重启的内部故障
为了观察失败动作,可以让容器先创建 /tmp/healthy,30 秒后删除它,再由探针执行 cat。前 30 秒命令成功,文件删除后命令失败,连续失败达到默认阈值后,kubelet 终止容器并按重启策略处理:
apiVersion: v1
kind: Pod
metadata:
  name: liveness-exec
  labels:
    app: liveness
spec:
  containers:
  - name: liveness
    image: busybox:1.28
    imagePullPolicy: IfNotPresent
    args:                       #创建测试探针探测的文件
    - /bin/sh
    - -c
    - touch /tmp/healthy; sleep 30; rm -rf /tmp/healthy; sleep 600
    livenessProbe:
      initialDelaySeconds: 10   #延迟检测时间
      periodSeconds: 5          #检测时间间隔
      exec:
        command:
        - cat
        - /tmp/healthy
这个实验使用文件模拟健康状态变化。实际应用需要检查与目标故障有关的内部状态,单纯判断进程存在,通常无法识别主循环卡死。
HTTP 检查可以通过返回码表达结果。下面仍使用 Spring Boot 的 Actuator 接口演示语法:
apiVersion: v1
kind: Pod
metadata:
  name: liveness-http
  labels:
    test: liveness
spec:
  containers:
  - name: liveness
    image: docker.io/mydlqclub/springboot-helloworld:0.0.1 #ctr -n=k8s.io images import springboot.tar.gz解压
    imagePullPolicy: IfNotPresent
    livenessProbe:
      initialDelaySeconds: 20   #延迟加载时间
      periodSeconds: 5          #重试时间间隔
      timeoutSeconds: 10        #超时时间设置
      httpGet:
        scheme: HTTP
        port: 8081
        path: /actuator/health
生产环境使用 /actuator/health 前,需要检查其中包含哪些健康检查项,避免数据库等共享依赖的故障触发 Liveness 失败。支持相应功能的 Spring Boot 版本可以分别使用 /actuator/health/liveness 和 /actuator/health/readiness。Spring Boot 的探针文档也说明了这两类健康状态与外部依赖检查的区别;旧实验镜像是否支持相应端点,需要单独确认。
TCP 检查的配置更简单。下面只判断 Nginx 的 80 端口能否建立连接:
apiVersion: v1
kind: Pod
metadata:
  name: liveness-tcp
  labels:
    app: liveness-tcp
spec:
  containers:
  - name: liveness
    image: nginx:latest
    imagePullPolicy: IfNotPresent
    livenessProbe:
      initialDelaySeconds: 15
      periodSeconds: 20
      tcpSocket:
        port: 80
#探测80端口起来没起来
#停掉nginx
#kubectl exec -it liveness-tcp -- /bin/bash
# nginx -s stop 会停止主进程;此后的重启也可能由 restartPolicy 直接触发。
示例注释中的 nginx -s stop 会停止主进程,容器随后可能直接按 restartPolicy 重启。因此,观察到重启时,还要核对 Events 中的探针失败记录和容器终止原因,才能确认是否由 Liveness 触发。
把三类探针放进同一个容器配置
下面的完整清单展示三类探针在 Pod 中的位置,以及对应的 Service。它们都请求同一个 Actuator 路径,便于对照字段;实际使用时,仍需要按各自职责选择端点。
apiVersion: v1
kind: Pod
metadata:
  name: springboot-live
  labels:
    app: springboot
spec:
  containers:
  - name: springboot
    image: docker.io/mydlqclub/springboot-helloworld:0.0.1
    imagePullPolicy: IfNotPresent
    ports:
    - name: server
      containerPort: 8080
    - name: management
      containerPort: 8081
    readinessProbe:
      initialDelaySeconds: 20
      periodSeconds: 5
      timeoutSeconds: 10
      httpGet:
        scheme: HTTP
        port: 8081
        path: /actuator/health
    livenessProbe:
      initialDelaySeconds: 20
      periodSeconds: 5
      timeoutSeconds: 10
      httpGet:
        scheme: HTTP
        port: 8081
        path: /actuator/health
    startupProbe:
      initialDelaySeconds: 20
      periodSeconds: 5
      timeoutSeconds: 2
      httpGet:
        scheme: HTTP
        port: 8081
        path: /actuator/health
---
apiVersion: v1
kind: Service
metadata:
  name: springboot-live
  labels:
    app: springboot
spec:
  selector:
    app: springboot
  type: NodePort
  ports:
  - name: server
    port: 8080
    targetPort: 8080
    nodePort: 31180
  - name: management
    port: 8081
    targetPort: 8081
    nodePort: 31181
这份 Service 与前面的 Readiness 示例都使用 NodePort 31180、31181,两个实验应分别运行。如果需要并存,必须改用未占用的 NodePort,并区分选择后端的标签,避免两个 Service 同时选中两组 Pod。
三个字段都存在,只能说明声明了三项检查。它们是否真的覆盖不同状态,还要看健康接口的实现。
gRPC 探针:目标端口需要实现健康检查协议
原生 gRPC 探针在 Kubernetes 1.24 进入 Beta,在 1.27 成为稳定功能。下面以 etcd 为例,演示 grpc.port 的配置位置:
apiVersion: v1
kind: Pod
metadata:
  name: etcd-with-grpc
spec:
  containers:
  - name: etcd
    image: registry.cn-hangzhou.aliyuncs.com/google_containers/etcd:3.5.1-0
    command: [ "/usr/local/bin/etcd", "--data-dir", "/var/lib/etcd", "--listen-client-urls", "http://0.0.0.0:2379", "--advertise-client-urls", "http://127.0.0.1:2379", "--log-level", "debug"]
    ports:
    - containerPort: 2379
    livenessProbe:
      grpc:
        port: 2379 # 目标端口需要实现 gRPC 健康检查协议。
      initialDelaySeconds: 10
开放了 gRPC 端口,并不代表已经实现 gRPC Health Checking Protocol。目标服务需要支持该协议,探针才能获得健康结果。这里使用数字端口;实际镜像、协议支持与集群版本也需要对应。
健康接口应该检查到哪一层
Kubernetes 只能根据接口返回的结果采取动作。接口检查过多外部系统,可能把依赖故障变成本进程的故障;接口检查过少,又可能在业务已经卡住时继续返回成功。
可以按职责划分 /startup、/live、/ready,让维护者从路径就能判断检查的用途。这些路径名是应用约定,Kubernetes 不要求必须使用它们,也不要求三类探针必须请求不同 URL;职责能否分清,要看检查的实际含义。
下面的 Go 代码是处理函数示意,dbPool、cache 等需要替换为应用中的实际实现:
// /startup:检查初始化工作是否完成
func startupHandler(w http.ResponseWriter, r *http.Request) {
    if !dbPool.IsInitialized() || !cache.IsWarmed() {
        w.WriteHeader(http.StatusServiceUnavailable)
        return
    }
    w.WriteHeader(http.StatusOK)
}

// /live:极轻量,只证明进程仍能响应
func liveHandler(w http.ResponseWriter, r *http.Request) {
    // 不检查数据库、缓存、消息队列等外部依赖
    w.WriteHeader(http.StatusOK)
}

// /ready:检查当前是否可以接收业务流量
func readyHandler(w http.ResponseWriter, r *http.Request) {
    ctx, cancel := context.WithTimeout(r.Context(), time.Second)
    defer cancel()

    if err := dbPool.Ping(ctx); err != nil {
        w.WriteHeader(http.StatusServiceUnavailable)
        return
    }
    w.WriteHeader(http.StatusOK)
}
/startup 检查初始化是否完成;/live 不访问外部依赖,只证明这个处理函数仍然能够响应。后者的覆盖范围也很有限:如果健康接口还能响应、业务主循环却已卡死,仍需要增加能够反映业务处理是否继续推进的内部状态检查。
/ready 可以检查处理请求必需的依赖,但应限制检查耗时。示例为数据库检查设置了 1 秒超时;多个依赖应分别设置超时,并控制总耗时,避免某一个依赖拖住整个接口。健康检查本身也应保持轻量,避免复杂计算、长链路调用和大量 I/O。
共享依赖是否加入 Readiness,需要结合降级能力判断
如果业务完全依赖数据库,数据库不可用时,实例可能确实不适合接流。但如果所有副本都检查同一个数据库,一次数据库故障就可能让全部 Pod 同时 NotReady,Service 随之失去可用后端。对于能够通过缓存、熔断或其他方式降级处理的请求,把所有依赖都纳入 Readiness 可能反而扩大不可用范围。
因此,需要根据依赖是否必需、是否被所有实例共享,以及上层如何处理失败,决定检查范围。数据库、缓存、消息队列或下游 RPC 的失败,通常不应直接让 Liveness 失败;Readiness 是否包含这些检查,也需要逐项判断。
还要确认管理端口能否代表业务端口的实际状态。Spring Boot 如果把 Actuator 放在独立管理上下文中,管理端口可能使用不同的 Web 基础设施。管理接口正常时,业务端口仍可能无法接受新连接。验证健康接口时,需要同时验证它与真实业务入口的关系。
案例:探针怎样把依赖抖动放大成重启风暴
下面的案例整理自《一场由健康探针引发的Pod重启风暴——K8s LivenessReadiness Probe配置不当的深度复盘》,数字与时间线沿用该文记述,未独立核实。它适合用来分析配置中的故障放大过程。
一次为了更快发现故障的参数调整
按案例记述,订单服务遇到数据库慢查询与连接池争用,健康接口响应从约 50 ms 增长到 3.2 秒。此前,一次旨在更快发现不健康实例的变更,刚刚收紧了 Liveness 参数。
变更前的配置为:
livenessProbe:
  httpGet:
    path: /healthz
    port: 8080
  initialDelaySeconds: 30
  periodSeconds: 10
  timeoutSeconds: 5
  failureThreshold: 3
变更后的配置为:
livenessProbe:
  httpGet:
    path: /healthz
    port: 8080
  initialDelaySeconds: 10
  periodSeconds: 5
  timeoutSeconds: 3
  failureThreshold: 2
调整后,每 5 秒执行一次探测,单次请求超过 3 秒即失败,连续失败 2 次便触发终止容器。按周期与失败阈值相乘估算,容忍量级从约 30 秒缩短到约 10 秒。这里的 10 秒仍是估算,不是从首次失败结果起固定等待 10 秒,实际动作还受到探测时机、超时和终止过程影响。
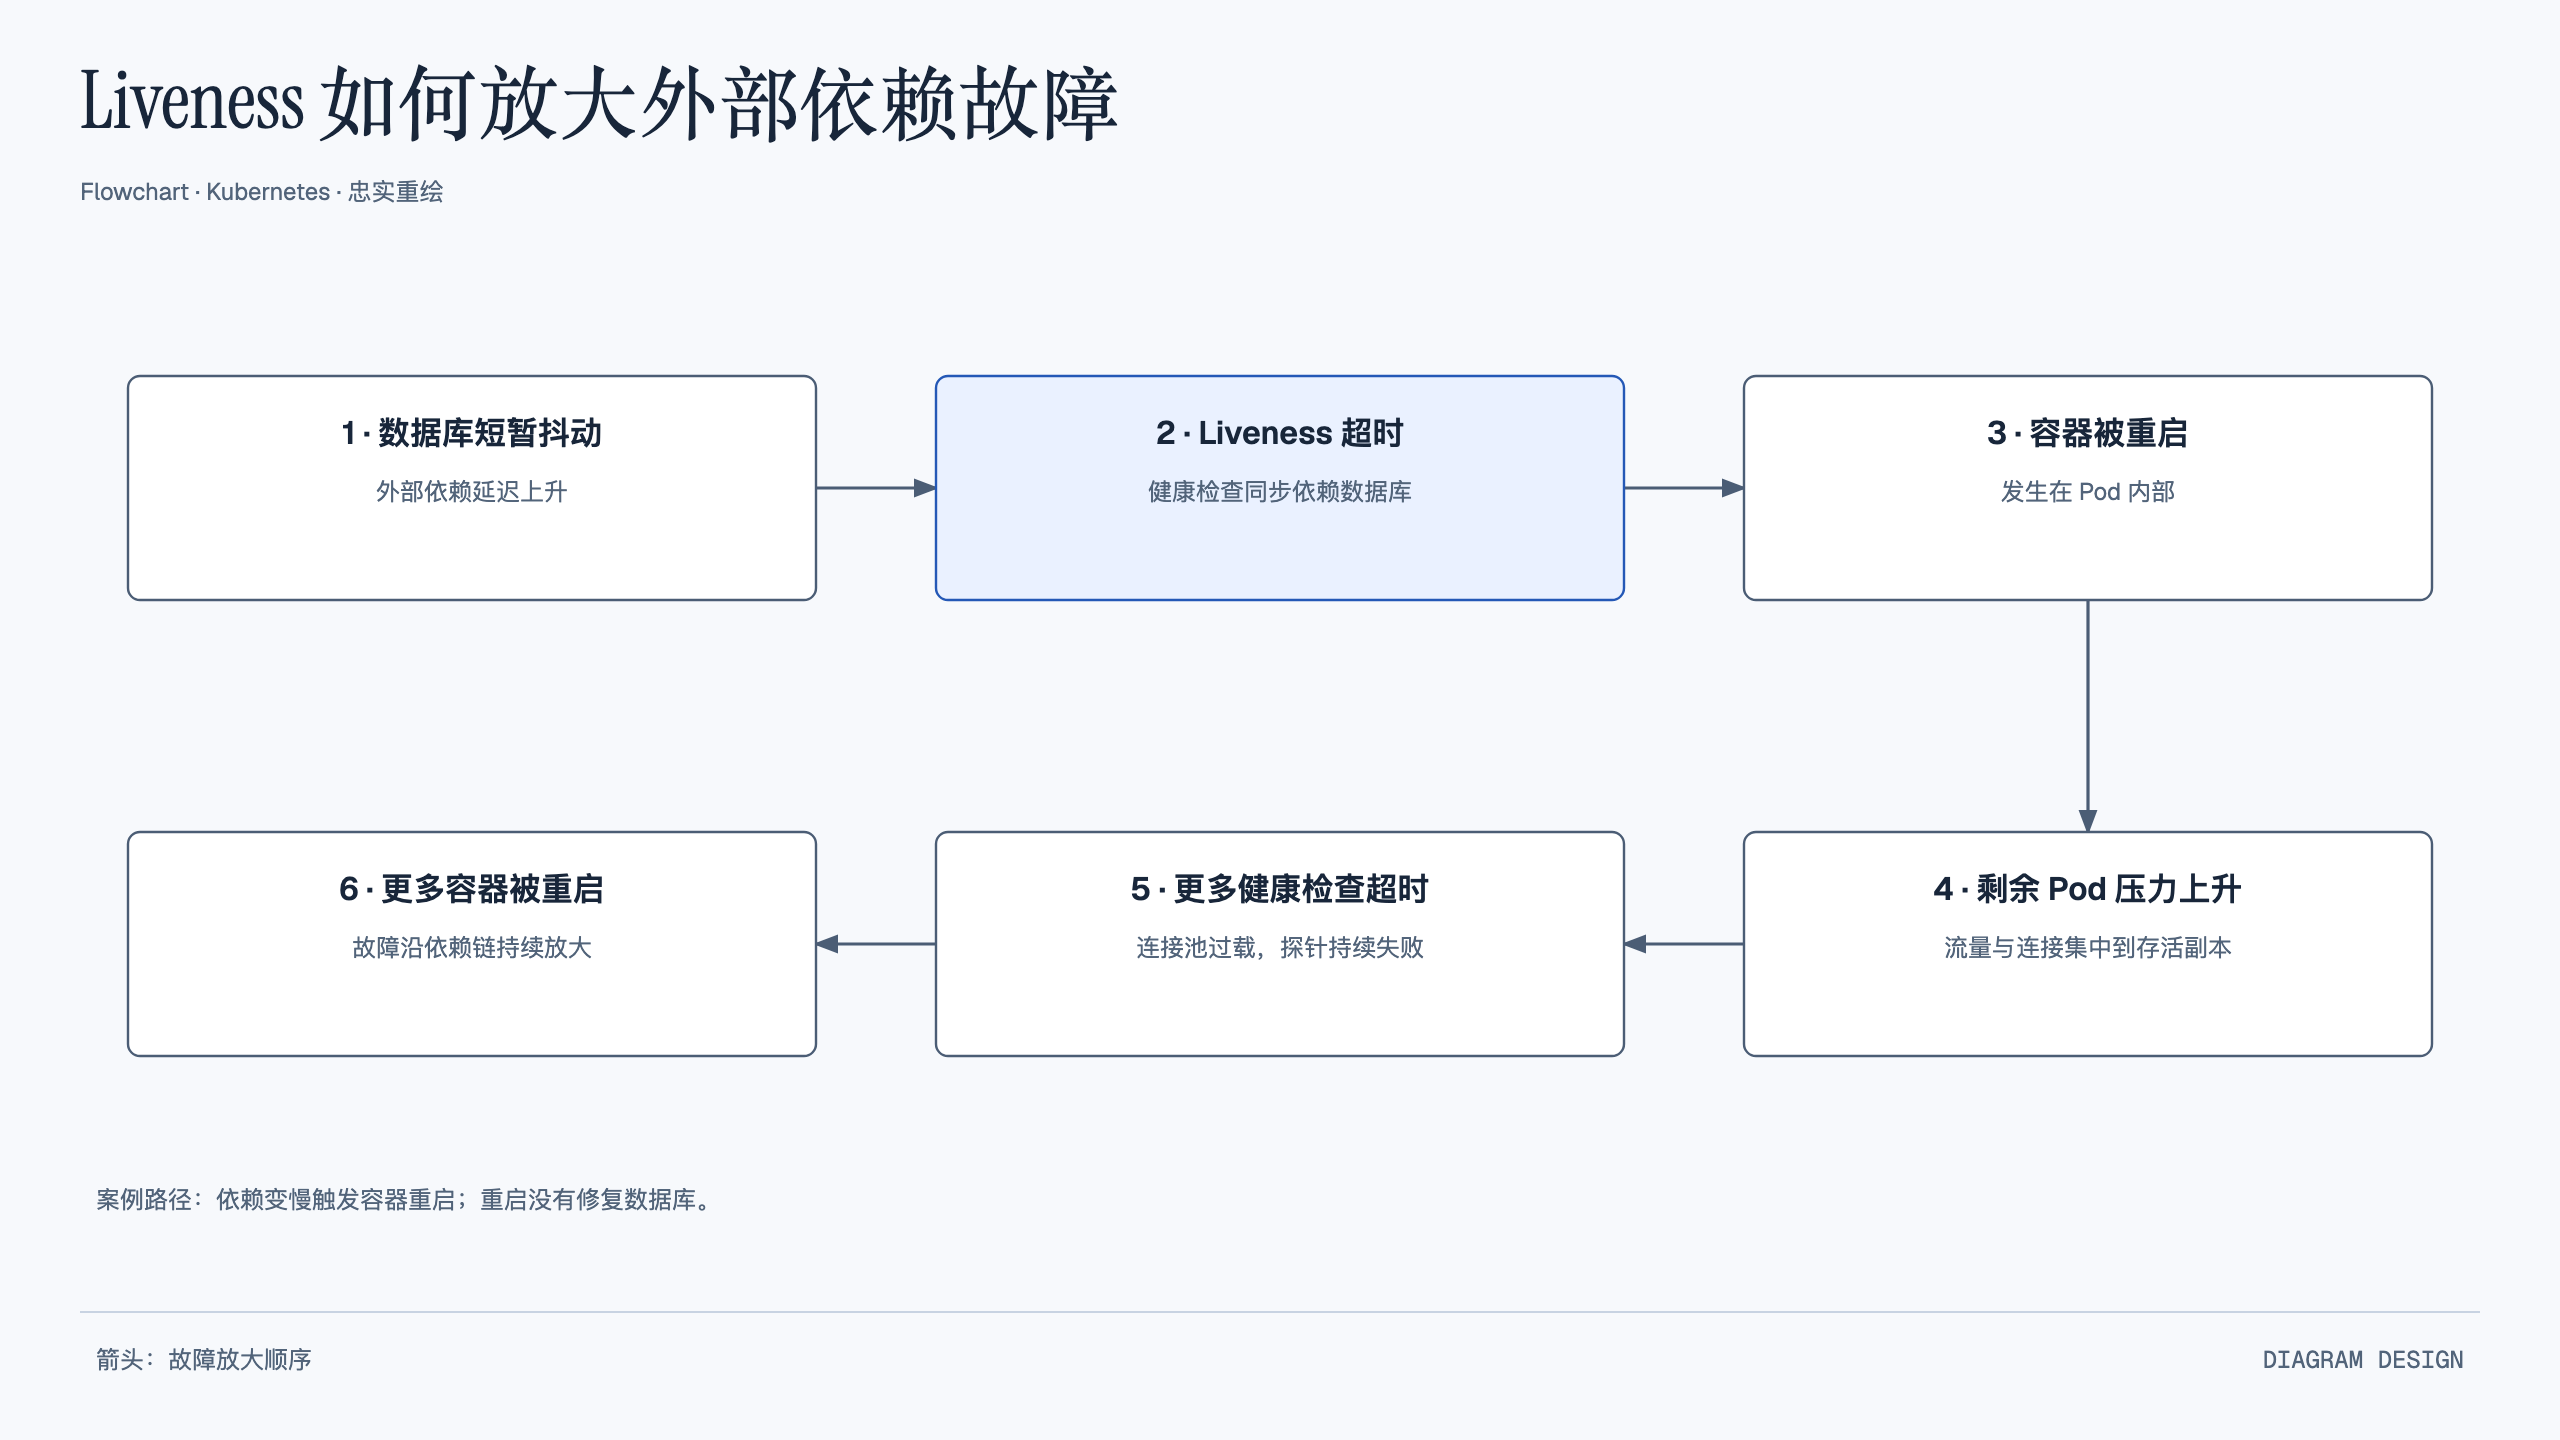
与此同时,/healthz 还同步检查数据库、Redis 和消息队列。健康接口慢到 3.2 秒后,外部依赖抖动便触发了 Liveness 失败,kubelet 开始重启业务容器。重启没有修复数据库,剩余副本却需要承受更多流量与连接压力。
案例记录中,订单服务的 40 个 Pod 中,可用副本快速下降到约 6 个;支付服务的 20 个 Pod 中,可用副本下降到约 3 个。约 5 分钟内,300 多个 Pod 中的容器发生连锁重启。订单服务的故障又通过 RPC 超时传播到支付服务,核心业务最终出现大面积 502 和不可用。
从依赖变慢到级联重启的时间线
| 时间 | 事件 |
|---|---|
| 15:12 | 慢查询触发,订单服务数据库连接池开始紧张 |
| 15:13 | /healthz 响应达到 3.2 秒,第一次超过 3 秒超时 |
| 15:13 | 5 秒后第二次超时,Liveness 判定失败 |
| 15:13 | kubelet 开始重启订单服务 Pod 内的容器 |
| 15:14 | 多个 Pod 内的业务容器被终止,剩余可用 Pod 承担更多流量 |
| 15:14 | 剩余 Pod 的连接池进一步过载,健康检查普遍超时 |
| 15:15 | 订单服务 Pod 大量进入 CrashLoopBackOff |
| 15:16 | 支付服务因依赖订单服务而发生 RPC 超时,其健康检查也开始失败 |
| 15:17 | 支付服务 Pod 内的容器被连续重启 |
| 15:18 | 核心业务大面积不可用 |
故障按下面的路径不断放大:
Readiness 为什么没有留下恢复窗口
当时的 Readiness 配置为:
readinessProbe:
  httpGet:
    path: /ready
    port: 8080
  initialDelaySeconds: 5
  periodSeconds: 10
  timeoutSeconds: 3
  failureThreshold: 3
  successThreshold: 1
Readiness 的周期是 10 秒,失败阈值是 3,容忍量级约为 30 秒;Liveness 的对应量级只有约 10 秒。对于这个希望通过摘流获得恢复空间的服务,配置反而倾向于更早触发重启。
按案例描述,Liveness 先达到失败阈值,业务容器还没有获得足够的摘流恢复时间,就已经被终止。新容器启动后继续承受依赖压力,健康接口再次超时,重启循环因此延续。
Readiness 无法阻止一个已经满足失败条件的 Liveness 采取动作。要给应用自愈留出空间,需要让 Readiness 对接流能力的变化更敏感,让 Liveness 对可恢复的抖动更保守,同时确保两者检查的故障确实不同。
修复:分离健康语义,再调整时间预算
首先,把外部依赖检查从 Liveness 中移出,让 /live 聚焦重启能够修复的内部故障;/ready 根据业务需要检查关键依赖和当前接流能力。数据库恢复的时间不会因为应用重启而缩短,把它留在 Liveness 中,只会继续制造连接重建和流量转移。
然后,为摘流后的恢复预留时间。例如:
readinessProbe:
  httpGet:
    path: /ready
    port: 8080
  initialDelaySeconds: 10
  periodSeconds: 5
  timeoutSeconds: 3
  failureThreshold: 2
  successThreshold: 1

livenessProbe:
  httpGet:
    path: /live
    port: 8080
  initialDelaySeconds: 30
  periodSeconds: 20
  timeoutSeconds: 5
  failureThreshold: 5
按相同方法估算,Readiness 的失败窗口约为 10 秒,Liveness 约为 100 秒。这里还同时改变了两个探针的检查路径:外部依赖变慢可以触发摘流,是否需要重启则由 /live 表达的内部状态决定。仅仅放宽超时、继续检查同一个包含所有依赖的接口,仍然会保留原来的故障放大风险。
有时会用“Liveness 的容忍窗口至少是 Readiness 的两倍”作为保守启发式。这个倍数不是 Kubernetes 的通用公式。实际窗口应根据正常延迟分布、依赖恢复时间、错误预算和可接受的故障发现时间,通过压测及故障演练确定。
对于启动较慢的服务,还可以用 Startup 隔离初始化阶段,避免每次重启后尚未完成启动,就再次被 Liveness 终止:
startupProbe:
  httpGet:
    path: /startup
    port: 8080
  periodSeconds: 5
  failureThreshold: 30

livenessProbe:
  httpGet:
    path: /live
    port: 8080
  periodSeconds: 20
  timeoutSeconds: 5
  failureThreshold: 5

readinessProbe:
  httpGet:
    path: /ready
    port: 8080
  periodSeconds: 5
  timeoutSeconds: 3
  failureThreshold: 2
这个组合为启动提供约 150 秒的探测预算,Startup 成功后,再由运行期探针各自工作。摘流、恢复接流和重启的实际时间,都应在测试环境中观察,确认它们与预期一致。
看到重启增多时,按什么顺序排查
先确认重启由什么触发
容器重启次数增加,并不能单独证明是探针导致的。排查时可以先查看下面几类信息:
kubectl describe pod <pod-name>
kubectl logs <pod-name> --previous
kubectl get events --field-selector involvedObject.name=<pod-name>
kubectl get pod <pod-name> -o yaml
这些命令需要在目标 namespace 下执行;多容器 Pod 查看日志时,还需要指定目标容器。--previous 用于查看该容器上一轮运行的日志,可以帮助还原重启前发生了什么。
- 查看
Last State和退出原因,区分探针终止、应用自行退出、OOM 等情况,并核对Restart Count的增长速度。 - 对照 Events 中的
Liveness probe failed及后续容器终止记录,判断失败是否连续达到阈值。 - 核对 Pod 当前生效的 YAML,确认检查路径、超时、周期和失败阈值,避免只看代码仓库里的预期配置。
- 将重启时间与依赖延迟、连接池状态放在同一时间线上,判断依赖变慢是否先于重启发生。
- 观察可用副本下降后,剩余 Pod 的请求量和资源压力是否继续增加,识别级联失效。
同时观察探针结果、延迟和可用副本
日常监控需要覆盖探针成功率、延迟、容器重启和可用副本变化。仅看重启次数,往往要到容器已经反复退出时才发现问题;把依赖延迟和健康接口耗时一起观察,更容易找到故障开始的位置。
下面使用自定义指标名演示查询方式。第一条计算成功事件的每秒速率;第二条假设延迟使用 classic Histogram,计算最近 5 分钟的 P99:
# 成功事件的每秒速率,假设该指标是自定义 Counter
rate(probe_success_total{probe="liveness"}[5m])

# 延迟 P99,假设该指标是 classic Histogram
histogram_quantile(
  0.99,
  sum by (le) (
    rate(probe_duration_seconds_bucket{probe="liveness"}[5m])
  )
)
成功事件速率与成功率含义不同,计算成功率还需要对应的总探测次数。实际指标名、标签和类型应以采集系统为准,这些名称不能直接当作 kubelet 默认指标。Histogram 查询保留 le 标签的原因,可对照 Prometheus 对分位数计算的说明理解。
把探针放回发布和恢复流程中
新实例接流与旧实例退出,需要一起验证
滚动发布时,新容器可能已经启动,业务却还没有准备好。Startup 为初始化保留时间,Readiness 表达何时能够接流,可以减少这段时间内的请求失败。Liveness 则应围绕明确的内部故障配置;如果进程遇到故障能够自行退出,已有重启策略也可能足以处理,不必为了配齐三类探针而增加误杀风险。
旧实例退出时,应用还需要处理停止信号,在终止宽限期内完成存量工作。preStop、终止宽限期和应用自身的优雅关闭逻辑仍然需要配置与验证。Pod 删除后,控制平面也会更新相应端点的终止与就绪状态,不能把删除时的摘流完全归因于 Readiness。
探针通过,只能说明检查条件满足。是否能平稳发布,还要验证多副本、滚动更新策略、实际负载均衡路径和应用退出过程。
PDB 与 HPA 不能阻止探针误杀
PodDisruptionBudget 主要通过 Eviction API 约束节点排空等自愿中断,直接删除 Pod 或 Deployment 会绕过这类约束。kubelet 因 Liveness 失败而重启容器,以及应用自身崩溃,都不能靠 PDB 阻止。这些边界在 Kubernetes 的中断说明中有明确区分。
HPA 的 minReplicas 约束的是期望副本下限,无法保证这些副本在探针误杀时保持 Ready。增加副本与分散部署可以增强可用性,但仍然需要正确的探针语义、时间预算和故障隔离。
自定义高频检查,需要单独设计控制动作
原生 periodSeconds 最小为 1 秒。如果确实需要更细粒度的观测,可以在应用或 sidecar 中实现自定义监控,但轮询结果如何参与流量控制和故障恢复,需要另外设计。下面的脚本展示了一个容易混淆的例子:
#!/bin/bash
while true; do
  response=$(curl -s -o /dev/null -w "%{http_code}" http://localhost:8080/health)
  if [ "$response" != "200" ]; then
    echo "Tomcat is not healthy. Exiting..."
    exit 1
  fi

  sleep 0.001  # 两轮请求之间暂停 1 ms;实际周期还包含 curl 请求耗时
done
脚本每轮请求后暂停 1 毫秒,实际周期还包含 HTTP 请求耗时,并不保证每毫秒执行一次。如此密集的检查也会增加负载,需要先评估必要性。
如果这段脚本运行在 sidecar 中,exit 1 退出的就是 sidecar 自身。这个结果不会自动变成业务容器的 Readiness 或 Liveness,也不会自动重启业务容器。自定义观测只有接入明确的应用或控制逻辑后,才能产生相应动作。
上线前的检查清单
探针参数会影响流量分配和容器生命周期,批量修改核心服务探针时,应按高风险变更安排灰度与回滚。上线前可以逐项确认:
- 每类探针的检查范围与失败动作是否对应,Liveness 是否混入了数据库、缓存或下游 RPC 等外部依赖。
- 慢启动服务是否需要 Startup,超时和失败窗口是否经过正常延迟、依赖变慢与连接池耗尽等场景验证。
- 生产探针变更是否经过 Code Review,CI/CD 是否检查了过短容忍窗口、需要却缺失的 Startup 等高风险配置。
- 是否先在少量副本灰度,并观察完整故障窗口;是否准备了能够快速恢复的上一版配置。
- 是否为容器重启率、探针失败率和可用副本骤降配置告警,并定期演练探针超时与依赖故障。
- 滚动更新策略、拓扑分布、反亲和性和副本数,是否能够承受少量实例摘流或重启后的负载转移。