Job 与 CronJob:在 Kubernetes 中运行一次性和定时任务
数据库备份、数据修复和文件转码都有一个结束条件:任务做完,进程就应退出。如果用 Deployment 承载这类工作,容器成功退出后还会被不断重启。Job 用于追踪任务是否完成,CronJob 则在计划时间创建 Job。
下面从一次性任务开始,逐步加入并行、失败重试、定时调度和两个运维案例。示例需要可用集群与相应命名空间的创建权限;备份案例还需要 MySQL 服务、可写存储和经过验证的备份账号。命令和 YAML 用于实验说明,使用前需要替换镜像、密码与资源名称。
Job
从进程退出到任务完成
Job 控制器创建一个或多个 Pod,记录成功完成的数量,达到目标后把 Job 标记为完成。Pod 列表中常见的 Completed 表示容器正常结束,对应 Pod 的 Succeeded 阶段。失败时是否重试、重试多久,由 Job 与 Pod 的配置共同决定;尚未达到成功数量,也不意味着立刻被判定为失败。
以备份为例,可以把包含 mysqldump 的镜像放进 Job,命令成功完成后退出。控制器保留任务状态,运维人员能够查看失败原因与日志,而无需让备份进程一直运行。
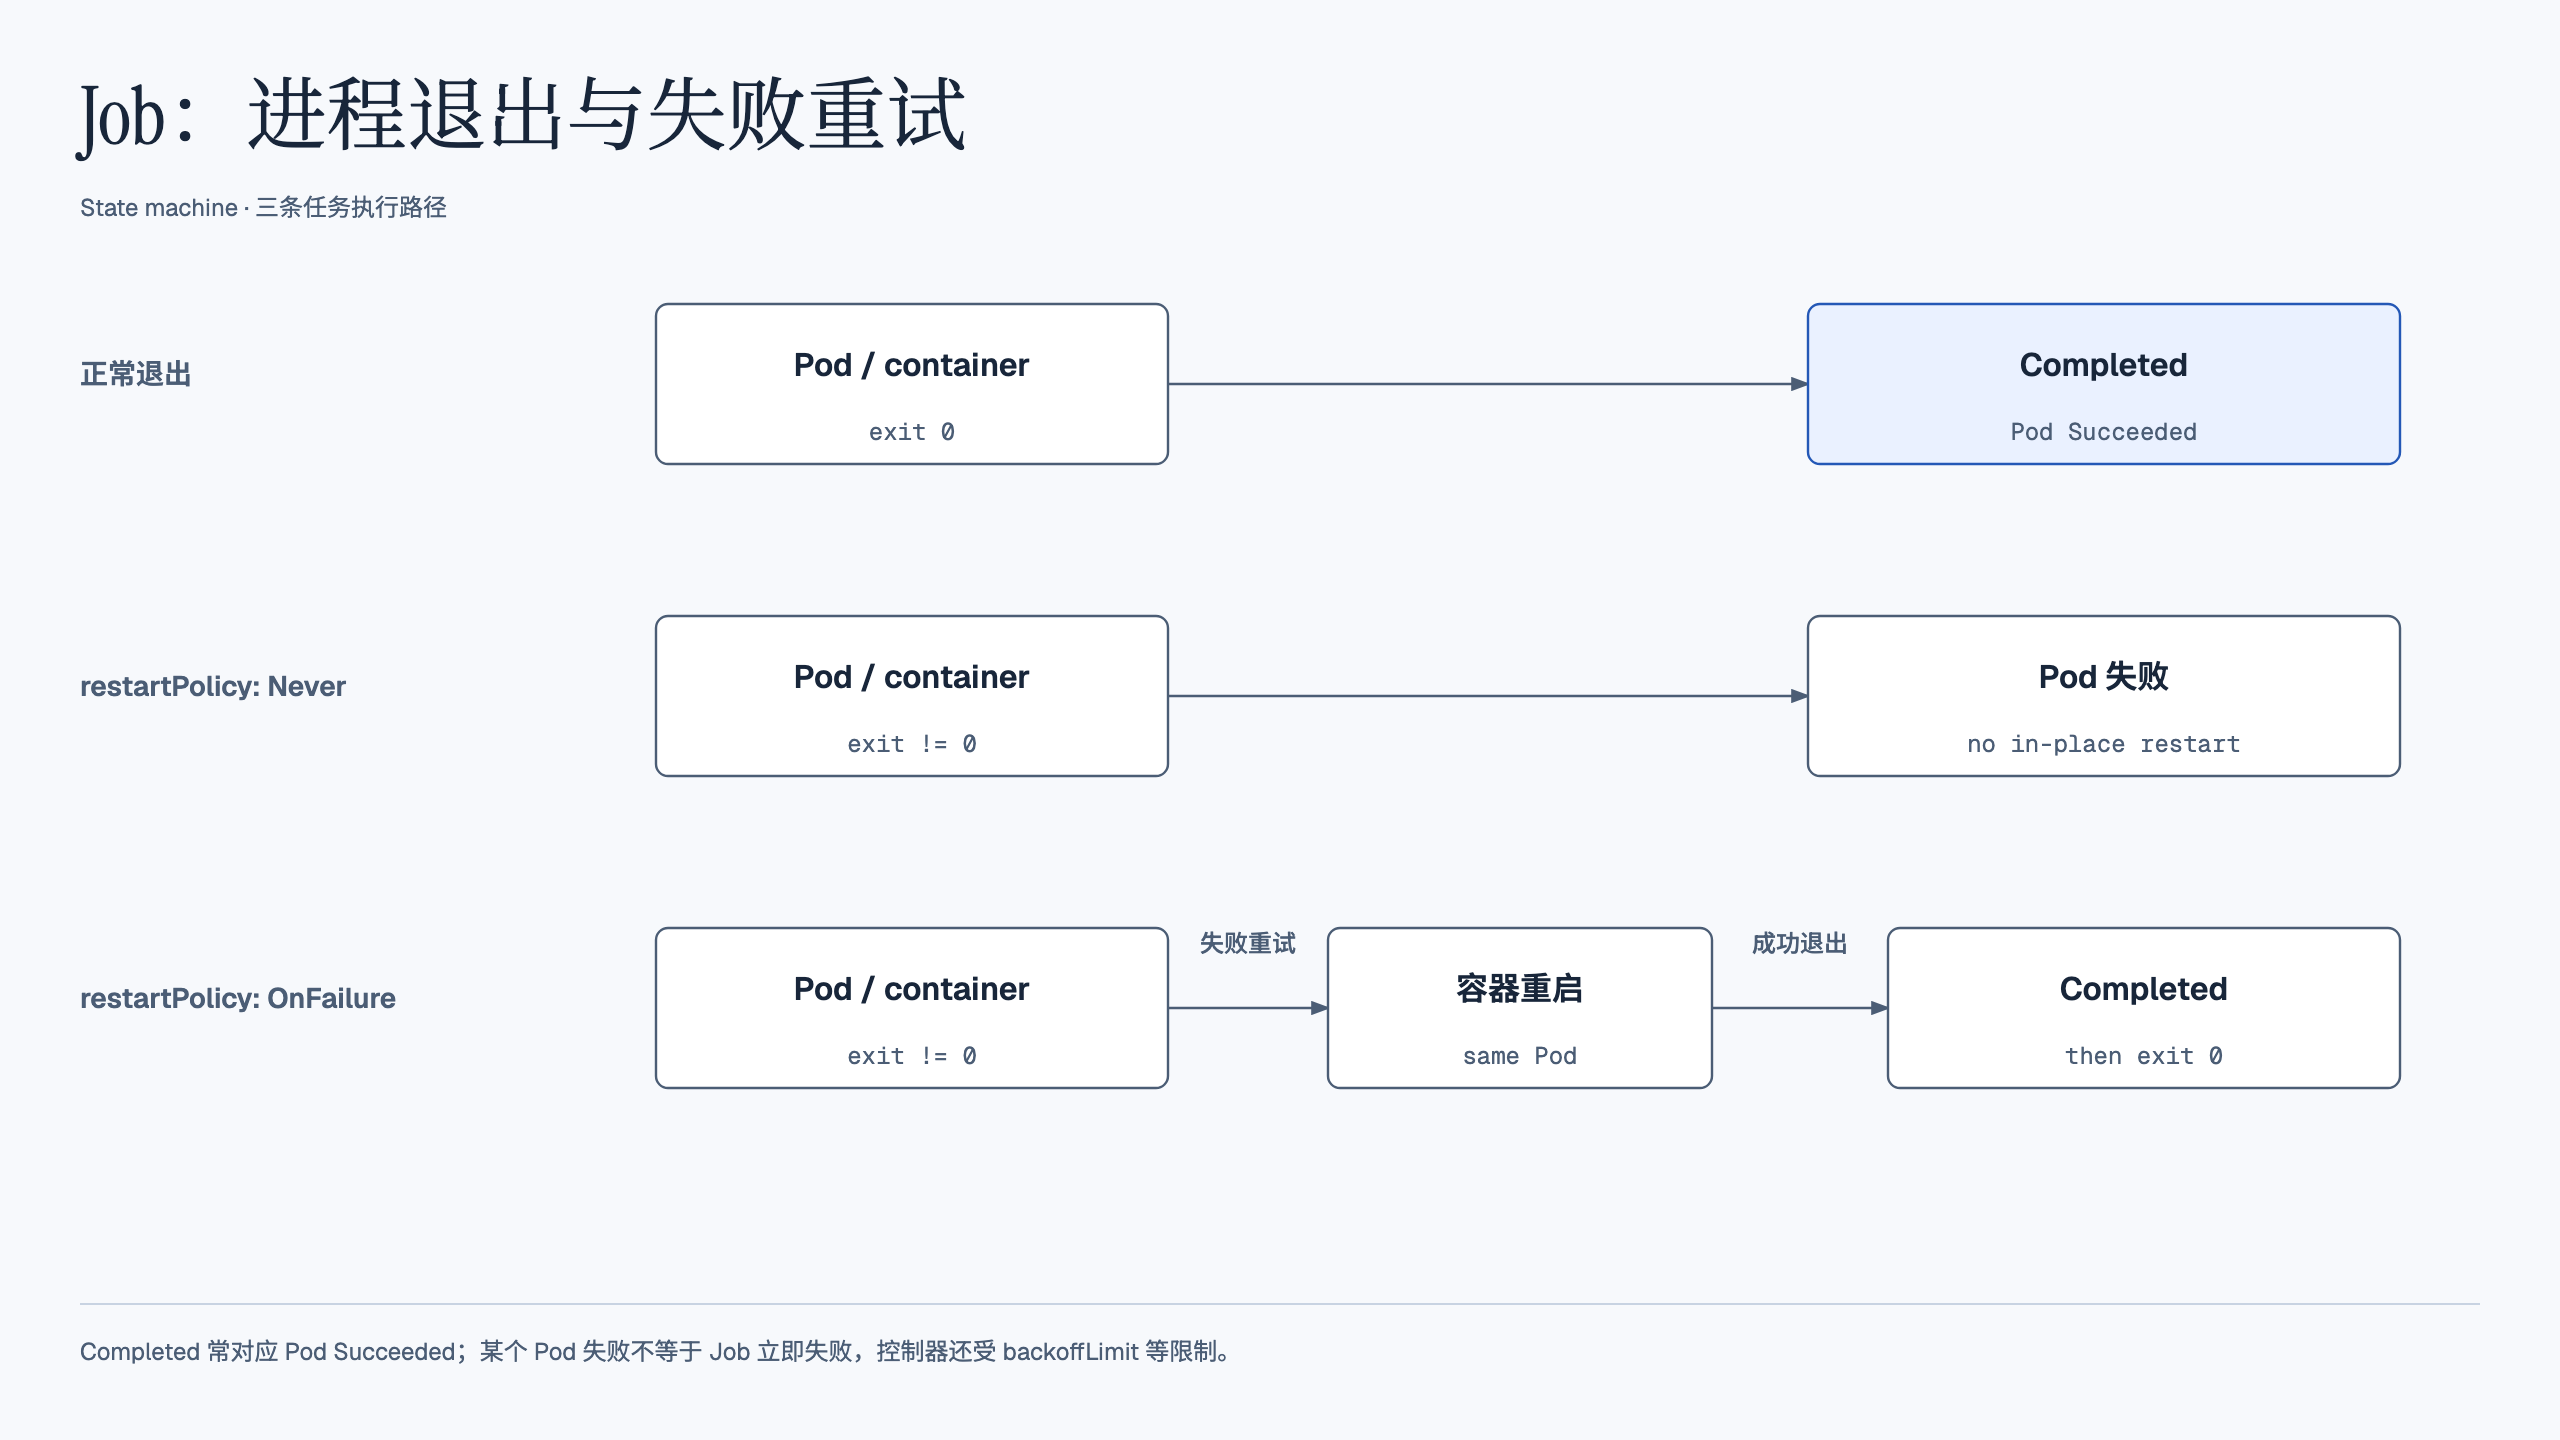
与直接在 Linux 上运行脚本相比,Job 能使用独立镜像隔离不同版本的工具,追踪任务状态,按策略重试失败任务,也能把独立工作项分给多个 Pod。但这些能力不保证业务操作只执行一次,任务仍需处理重复执行、临时文件和未完成输出。官方Job 说明明确指出,即使并发数与完成数都为 1,同一程序仍可能被启动多次。
三种任务组织方式
| 方式 | 关键配置 | 完成条件 |
|---|---|---|
| 单任务 | parallelism、completions 均可省略,均默认为 1 | 一个 Pod 成功结束 |
| 固定完成次数的并行任务 | 显式设置 completions,用 parallelism 限制并行程度 | 成功 Pod 数达到 completions |
| 工作队列任务 | 不设置 completions,设置 parallelism | 某个 Pod 成功后不再创建新 Pod,等待其余 Pod 结束 |
工作队列模式要求应用自行分配工作,并协调“队列已经处理完”的判定。某个 Pod 成功不会立即强制终止所有其他 Pod;其他 Pod 应已完成工作或准备退出。Job 常用于发送邮件、渲染帧、文件转码、扫描数据库键等相互独立的工作。通信密集型并行计算还需要额外考虑进程间通信、协同启动与故障处理,不能只设置一个并发数。
成功次数、重试和超时怎么配
| 配置 | 含义与使用边界 |
|---|---|
.spec.completions | 需要成功完成的 Pod 数;与并行上限是两个概念 |
.spec.parallelism | 请求的并行 Pod 数,默认 1;改为 0 相当于暂停,控制器会将活跃 Pod 数量向 0 缩减,恢复为正数后继续执行 |
.spec.template.spec.restartPolicy | Job 只允许 Never 或 OnFailure。前者让失败容器结束,由控制器按需新建 Pod;后者允许 kubelet 在原 Pod 中重启失败容器 |
.spec.backoffLimit | Job 的失败重试限制,普通 Job 默认 6;不是每个 Pod 独立的重启次数。OnFailure 下容器重试次数也参与计算 |
.spec.activeDeadlineSeconds | 整个 Job 的执行时限,包含重试时间;到期后终止运行中的 Pod,Job 失败,优先于重试限制 |
.spec.ttlSecondsAfterFinished | Job 成功或失败后经过多少秒可被自动清理,同时级联清理 Pod;0 表示立即具备清理条件,不设置则不由 TTL 控制器清理 |
若需要通过状态明确暂停 Job,可以设置 .spec.suspend: true;控制器会终止尚未完成的活跃 Pod,恢复时再创建 Pod。它不会冻结容器进程,应用仍需保存进度并处理中断。
失败重试采用退避机制。达到重试限制或超时限制后,Job 会进入终止流程,运行中的 Pod 被终止,Job 不会因为 Pod 的重启策略而自动重新开始。清理前要把诊断日志和任务结果保存在外部系统中,避免短 TTL 让故障现场过早消失。
示例
apiVersion: batch/v1
kind: Job
metadata:
  name: my-busybox-job
spec:
  parallelism: 3 # 请求最多并行3个;完成后补充剩余工作,实际并发也受资源限制
  completions: 4 # 需要累计4个Pod成功完成,不等于parallelism
  backoffLimit: 2 # Job级别的重试限制,按任务容错需求选择
  ttlSecondsAfterFinished: 100 # job执行结束之后多久自动清理。为0是立即清理。不设置就不清理。
  # 下面是job管理的pod模板字段
  template:
    spec:
      restartPolicy: Never
      containers:
        - name: my-container-job
          image: busybox:1.28
          imagePullPolicy: IfNotPresent
          command: ['sh', '-c']
          args: ['echo "Welcome to k8s";sleep 60; echo "Next to Meet you"']
CronJob:按时间创建 Job
调度的是 Job,不是长期运行的进程
CronJob 在计划时间创建 Job,再由 Job 创建 Pod。它适合周期性备份、发送报表等任务,计划本身常驻集群,而每次执行都有独立 Job 记录。Cron 表达式有五个字段,依次是分钟、小时、日、月、星期。
CronJob 的调度是近似的,控制器恢复、网络故障等情况可能造成漏跑或重复创建。因此需要在业务侧实现幂等,例如使用任务日期作为去重键,并监控 Job 的完成状态。concurrencyPolicy 只能约束同一个 CronJob 创建的 Job,不能防止其他 CronJob 或手动任务操作同一份数据。相关限制见CronJob 官方说明。
示例
apiVersion: batch/v1
kind: CronJob
metadata:
  name: cj-hello
spec:
  schedule: "*/1 * * * *" # 分时日月周
  concurrencyPolicy: Allow
  suspend: false # 改成true相当于把计划任务关了
  successfulJobsHistoryLimit: 3 # 保留多少个成功任务
  failedJobsHistoryLimit: 3 # 保留多少个失败任务
  jobTemplate:
    spec:
      backoffLimit: 2
      template:
        spec:
          restartPolicy: OnFailure
          containers:
          - name: hello
            image: busybox
            imagePullPolicy: IfNotPresent
            command:
            - /bin/sh
            - -c
            - date; echo Hello from the Kubernetes cluster
该计划期望每分钟创建一个 Job,再由 Job 创建 Pod。suspend: true 暂停后续调度,已经启动的 Job 不会因此停止;恢复调度时还需结合错过的计划与 startingDeadlineSeconds 判断是否补跑。
用并发策略处理上一次仍未完成的任务
例如备份耗时 10 分钟,计划却每 5 分钟触发一次,就需要明确如何处理重叠。.spec.concurrencyPolicy 有三种选择:
| 策略 | 到达下一次计划时间时的行为 |
|---|---|
Allow | 默认值,允许新旧 Job 同时执行 |
Forbid | 上一次尚未完成时跳过新一次执行,后续是否补跑还受 startingDeadlineSeconds 影响 |
Replace | 取消正在运行的 Job,用新 Job 替换;任务需要能处理中断 |
对于会写入同一份数据、不能并发执行的任务,可以考虑 Forbid。但它只约束同一个 CronJob 的调度,手动创建的任务仍需自行协调。
保存多少次执行记录
CronJob 默认保留 3 个成功 Job 和 1 个失败 Job,分别由 .spec.successfulJobsHistoryLimit 与 .spec.failedJobsHistoryLimit 控制。上面的清单把失败记录也设为 3,便于比较最近几次错误。记录保留不代替业务数据保留;如果同时配置 Job TTL,历史 Job 也可能被 TTL 控制器提前清理。
把业务时间写进调度时区
不设置 .spec.timeZone 时,计划按 kube-controller-manager 进程所在时区解释。假设该组件使用 UTC,schedule: '00 01 * * *' 对应北京时间每天 09:00,容易与操作者理解的“凌晨一点”产生偏差。
.spec.timeZone 在 Kubernetes 1.27 达到稳定,可使用 Asia/Shanghai 等 IANA 时区名称。旧版本需核对 CronJobTimeZone 的特性状态和开关默认值。不要在 schedule 里写 TZ 或 CRON_TZ,应使用专门字段。
下面只展示时区相关字段,需要合入包含 jobTemplate 的完整清单。它表示每天北京时间 02 点这一小时内,每 5 分钟调度一次:
spec:
  schedule: "*/5 02 * * *"
  timeZone: "Asia/Shanghai"
手动触发一次测试
如果已创建前面的 cj-hello,无需等到下一个计划时间,可以从其模板创建一个独立 Job:
kubectl create job hello-manual-test --from=cronjob/cj-hello -n default测试 Job 有独立名称,不受该 CronJob 的并发策略保护。重复运行命令时要使用新的 Job 名称,或先按实验清理流程处理旧对象。
两个运维任务案例
定期备份 MySQL
先准备 cronjob 命名空间、名为 nfs-csi 的 StorageClass,以及 mysql.default 对应的 MySQL Service。示例使用第三方 MySQL 工具镜像,实验前需要检查来源、工具版本和仓库可访问性。备份文件写入 PVC,Pod 结束后仍可保留。
生产环境应使用受限备份账号,并将凭据放在 Secret 中。这个案例通过 secretKeyRef 读取 mysql-backup-credentials 的 password 键;该 Secret 需预先在 cronjob 命名空间创建,user 键保存备份用户名。MySQL 客户端配置文件通常比环境变量更适合严格的凭据管理,这里用环境变量展示 Secret 的引用方式。Kubernetes 的Secret 用法说明了相应配置方式。
使用 Forbid 避免同一计划的备份重叠。命令失败时保留非零退出码,先写临时文件、成功后再改名,可以避免把不完整 SQL 当成有效备份;备份账号还需要与 --all-databases 操作匹配的权限。
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: mysql-backup-data
  namespace: cronjob
spec:
  accessModes:
    - ReadWriteMany
  resources:
    requests:
      storage: 10Gi
  storageClassName: nfs-csi

---
apiVersion: batch/v1
kind: CronJob
metadata:
  name: mysql-backup
  namespace: cronjob
spec:
  schedule: '01 16 * * *'
  timeZone: Asia/Shanghai
  concurrencyPolicy: Forbid
  failedJobsHistoryLimit: 5
  successfulJobsHistoryLimit: 5
  jobTemplate:
    spec:
      template:
        spec:
          volumes:
          - name: data
            persistentVolumeClaim:
              claimName: mysql-backup-data
          restartPolicy: Never
          containers:
          - name: backup
            image: registry.cn-beijing.aliyuncs.com/dotbalo/mysql:8.0.20 # 这个镜像已经包含mysqldump的命令
            command:
            - sh
            - -c
            - |
              set -eu
              backup_file="/mnt/all-$(date +%Y%m%d-%H%M%S).sql"
              mysqldump -hmysql.default -P3306 -u"$MYSQL_USER" --all-databases > "${backup_file}.tmp"
              mv "${backup_file}.tmp" "$backup_file"
              ls -lh "$backup_file"
            env:
            - name: MYSQL_USER
              valueFrom:
                secretKeyRef:
                  name: mysql-backup-credentials
                  key: user
            - name: MYSQL_PWD
              valueFrom:
                secretKeyRef:
                  name: mysql-backup-credentials
                  key: password
            volumeMounts:
            - name: data
              mountPath: /mnt
定时重启 Kubernetes 服务
有些应用需要在维护窗口重启。CronJob 可以调用 kubectl rollout restart,但它解决不了内存泄漏、连接泄漏等根因,实施前仍需确认副本、探针和滚动发布配置能够承受重启。
这个例子让 cronjob 命名空间中的专用 ServiceAccount,只能读取和 patch default 命名空间里名为 mysql 的 Deployment。RoleBinding 可以引用其他命名空间的 ServiceAccount,因此无需给默认账号授予集群范围权限。授权关系见RBAC 官方说明。
apiVersion: v1
kind: ServiceAccount
metadata:
  name: deployment-restarter
  namespace: cronjob
---
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  name: deployment-restart
  namespace: default
rules:
- apiGroups: ["apps"]
  resources: ["deployments"]
  resourceNames: ["mysql"]
  verbs: ["get", "patch"]
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: deployment-restart-binding
  namespace: default
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: Role
  name: deployment-restart
subjects:
- kind: ServiceAccount
  name: deployment-restarter
  namespace: cronjob
接着创建 CronJob。下面的第三方 kubectl:latest 镜像用于说明调用方式;实际使用应选择来源可信、固定版本且符合 API server 版本偏差要求的镜像:
apiVersion: batch/v1
kind: CronJob
metadata:
  name: default-restart
  namespace: cronjob
spec:
  schedule: "01 18 * * 5"
  timeZone: Asia/Shanghai
  concurrencyPolicy: Forbid
  suspend: false
  successfulJobsHistoryLimit: 3
  failedJobsHistoryLimit: 3
  jobTemplate:
    spec:
      template:
        spec:
          serviceAccountName: deployment-restarter
          restartPolicy: Never
          containers:
          - name: restart
            image: registry.cn-beijing.aliyuncs.com/dotbalo/kubectl:latest
            command:
            - /bin/sh
            - -c
            - kubectl rollout restart deployment/mysql -n default
这里的成功只表示重启 patch 请求提交成功。若需要确认应用恢复,还要观察 Deployment 的发布状态与业务指标;新增状态查询命令时,也应同步核对其最小 RBAC 权限。对于 StatefulSet 管理的 MySQL,需要改为操作 StatefulSet,不能直接照搬 Deployment 的名称与权限。