Kubernetes Service:从稳定入口到服务发现与流量转发
应用运行起来以后,还需要解决“其他应用从哪里访问它”。直接记录 Pod IP 很容易在重建、扩缩容后失效,Service 为一组后端提供稳定的名称和访问入口。理解 Service,可以帮助我们把应用自身的监听端口、集群内部发现和集群外部接入分开处理。
本文从传统服务发布讲起,先理解 Service 与 EndpointSlice,接着配置 DNS、端口和四种 Service 类型,再接入外部数据库,最后深入节点转发规则与代理模式实验。阅读前需要熟悉 Pod 标签、Deployment 和基本 TCP/IP;实验要求有可用集群及对应 Namespace 的操作权限。文中的 IP、Pod 名称和镜像仓库是实验示例,运行前应替换并检查当前上下文。
从应用地址变化说起
传统服务发布
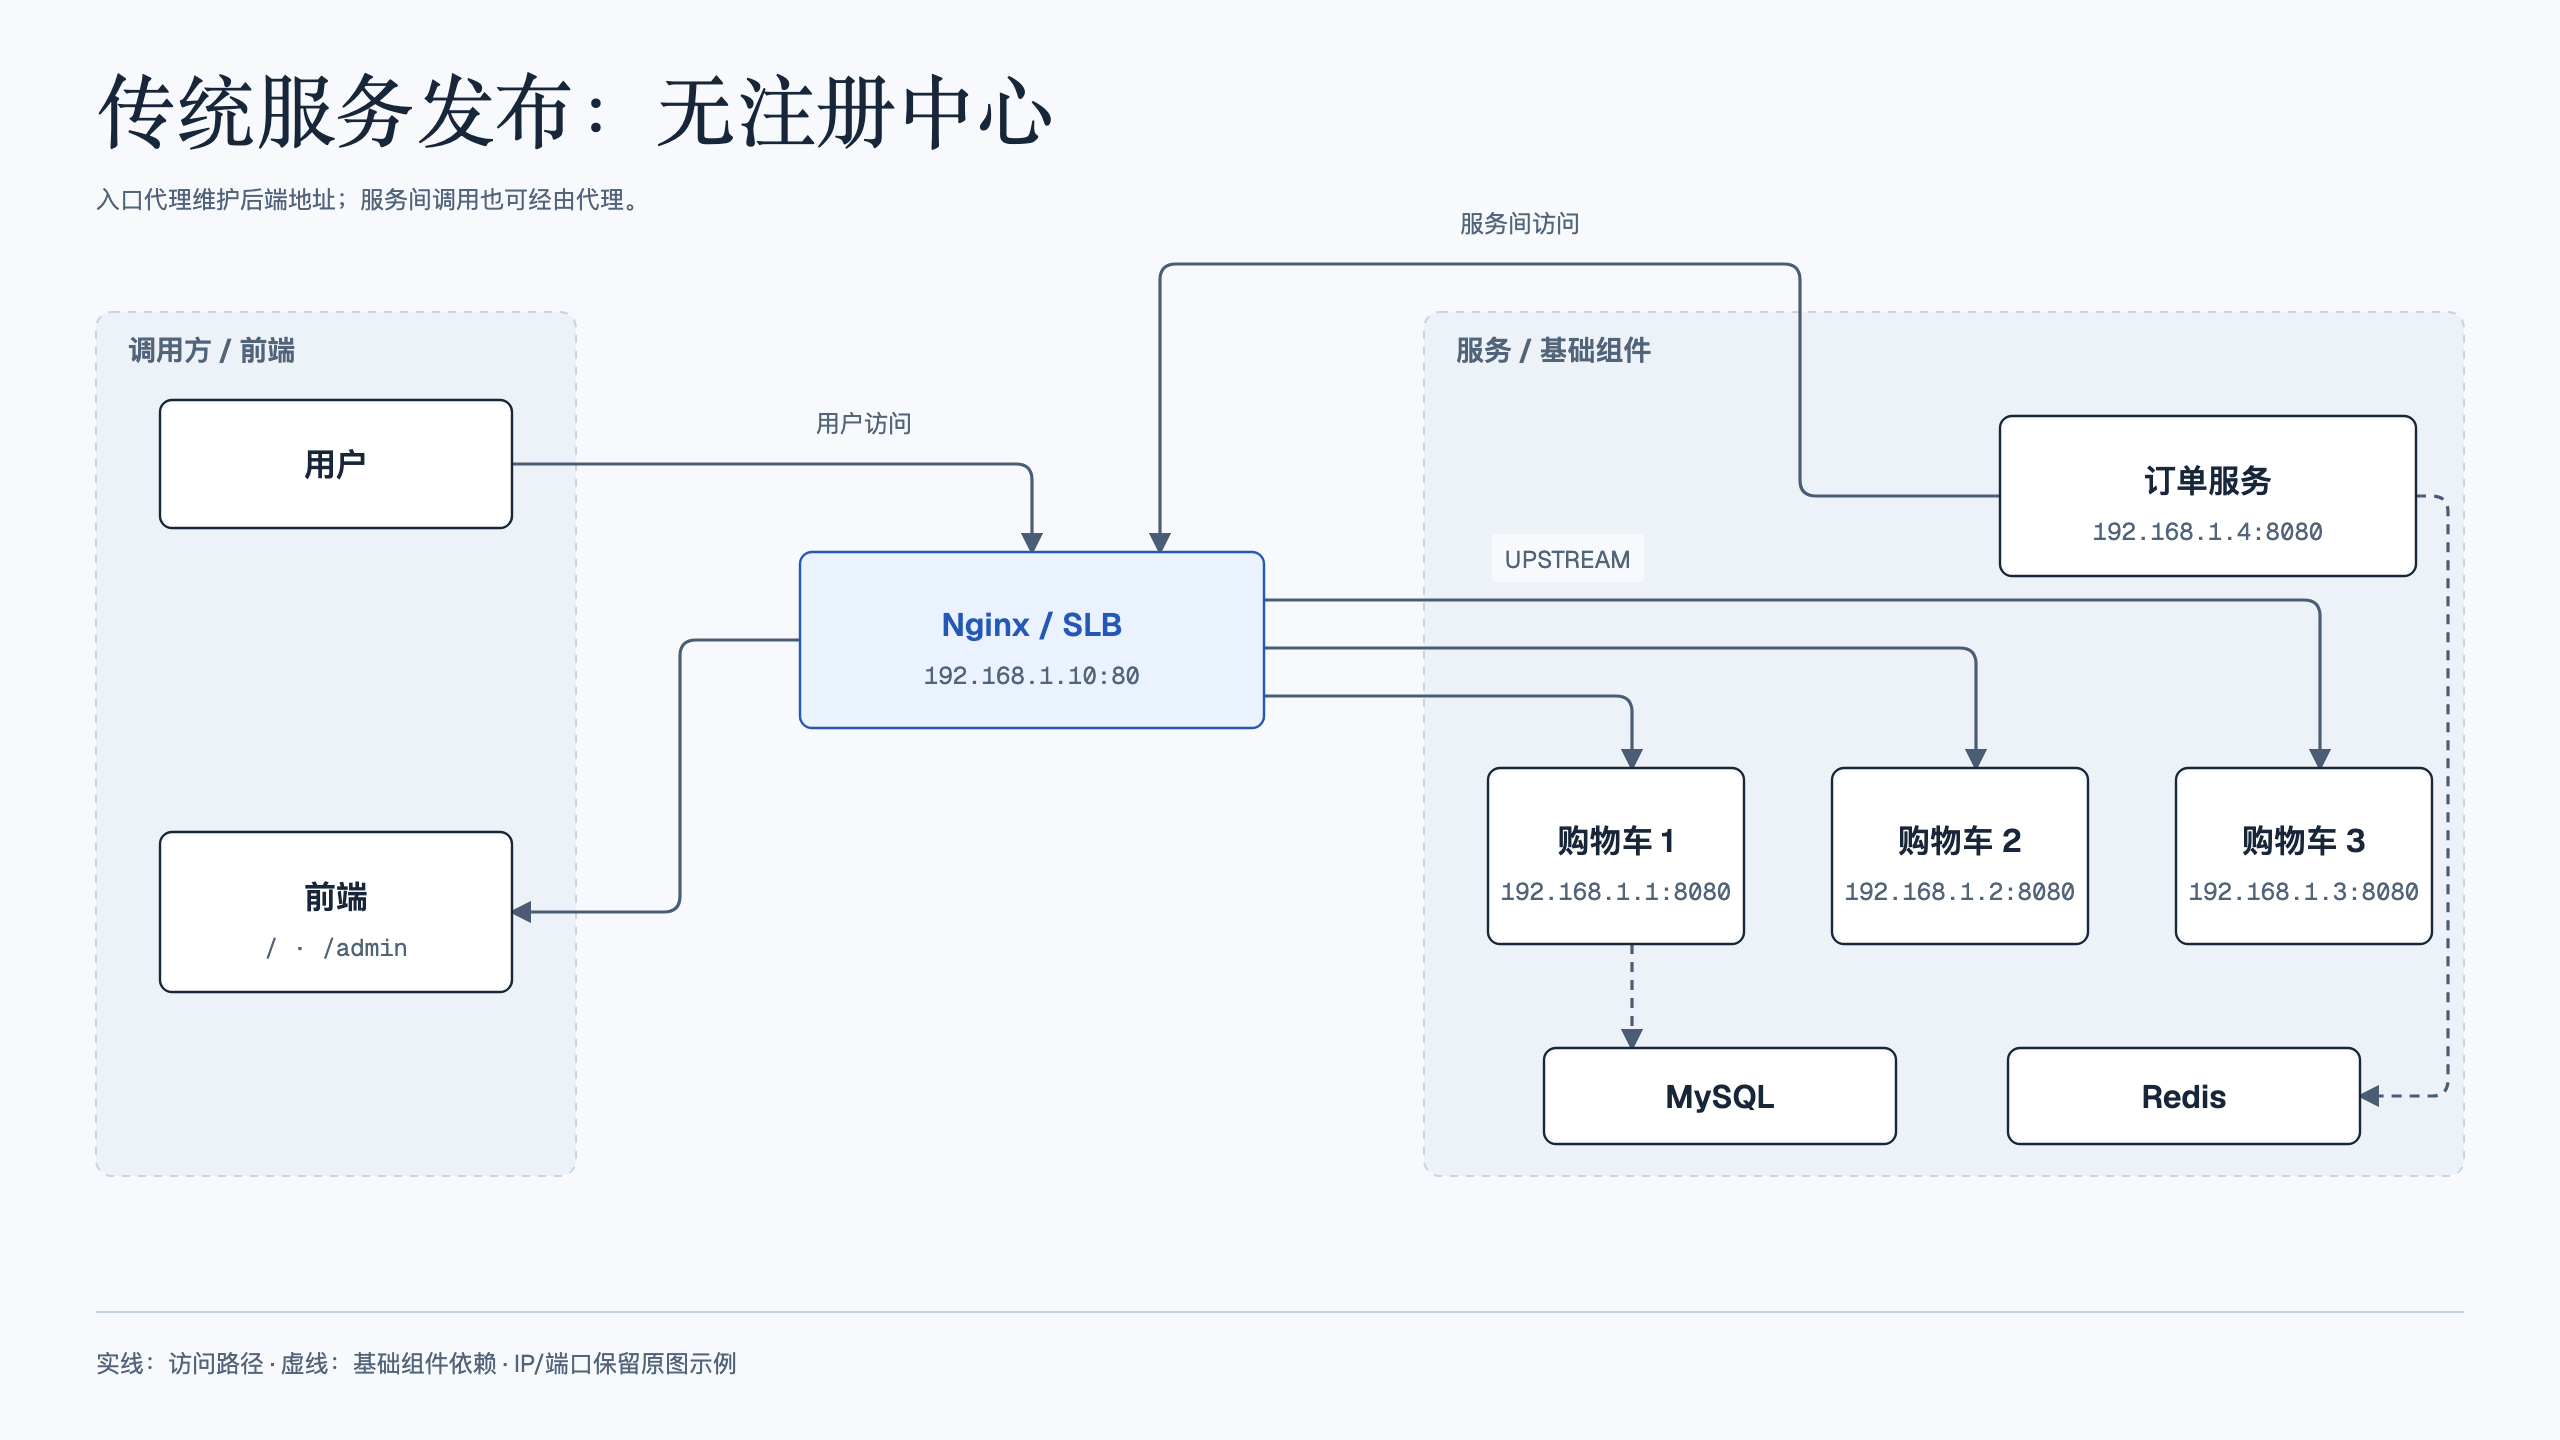
服务发布通常要覆盖外部用户访问、服务间调用和数据库等基础组件访问。这些调用方对地址稳定性、服务发现和入口暴露的需求不同。
没有注册中心时,外部用户和服务间调用往往通过 Nginx、SLB 等代理到达后端;数据库等基础组件则常以固定 IP 和端口写入配置。后端地址改变后,配置或代理规则也要随之更新。
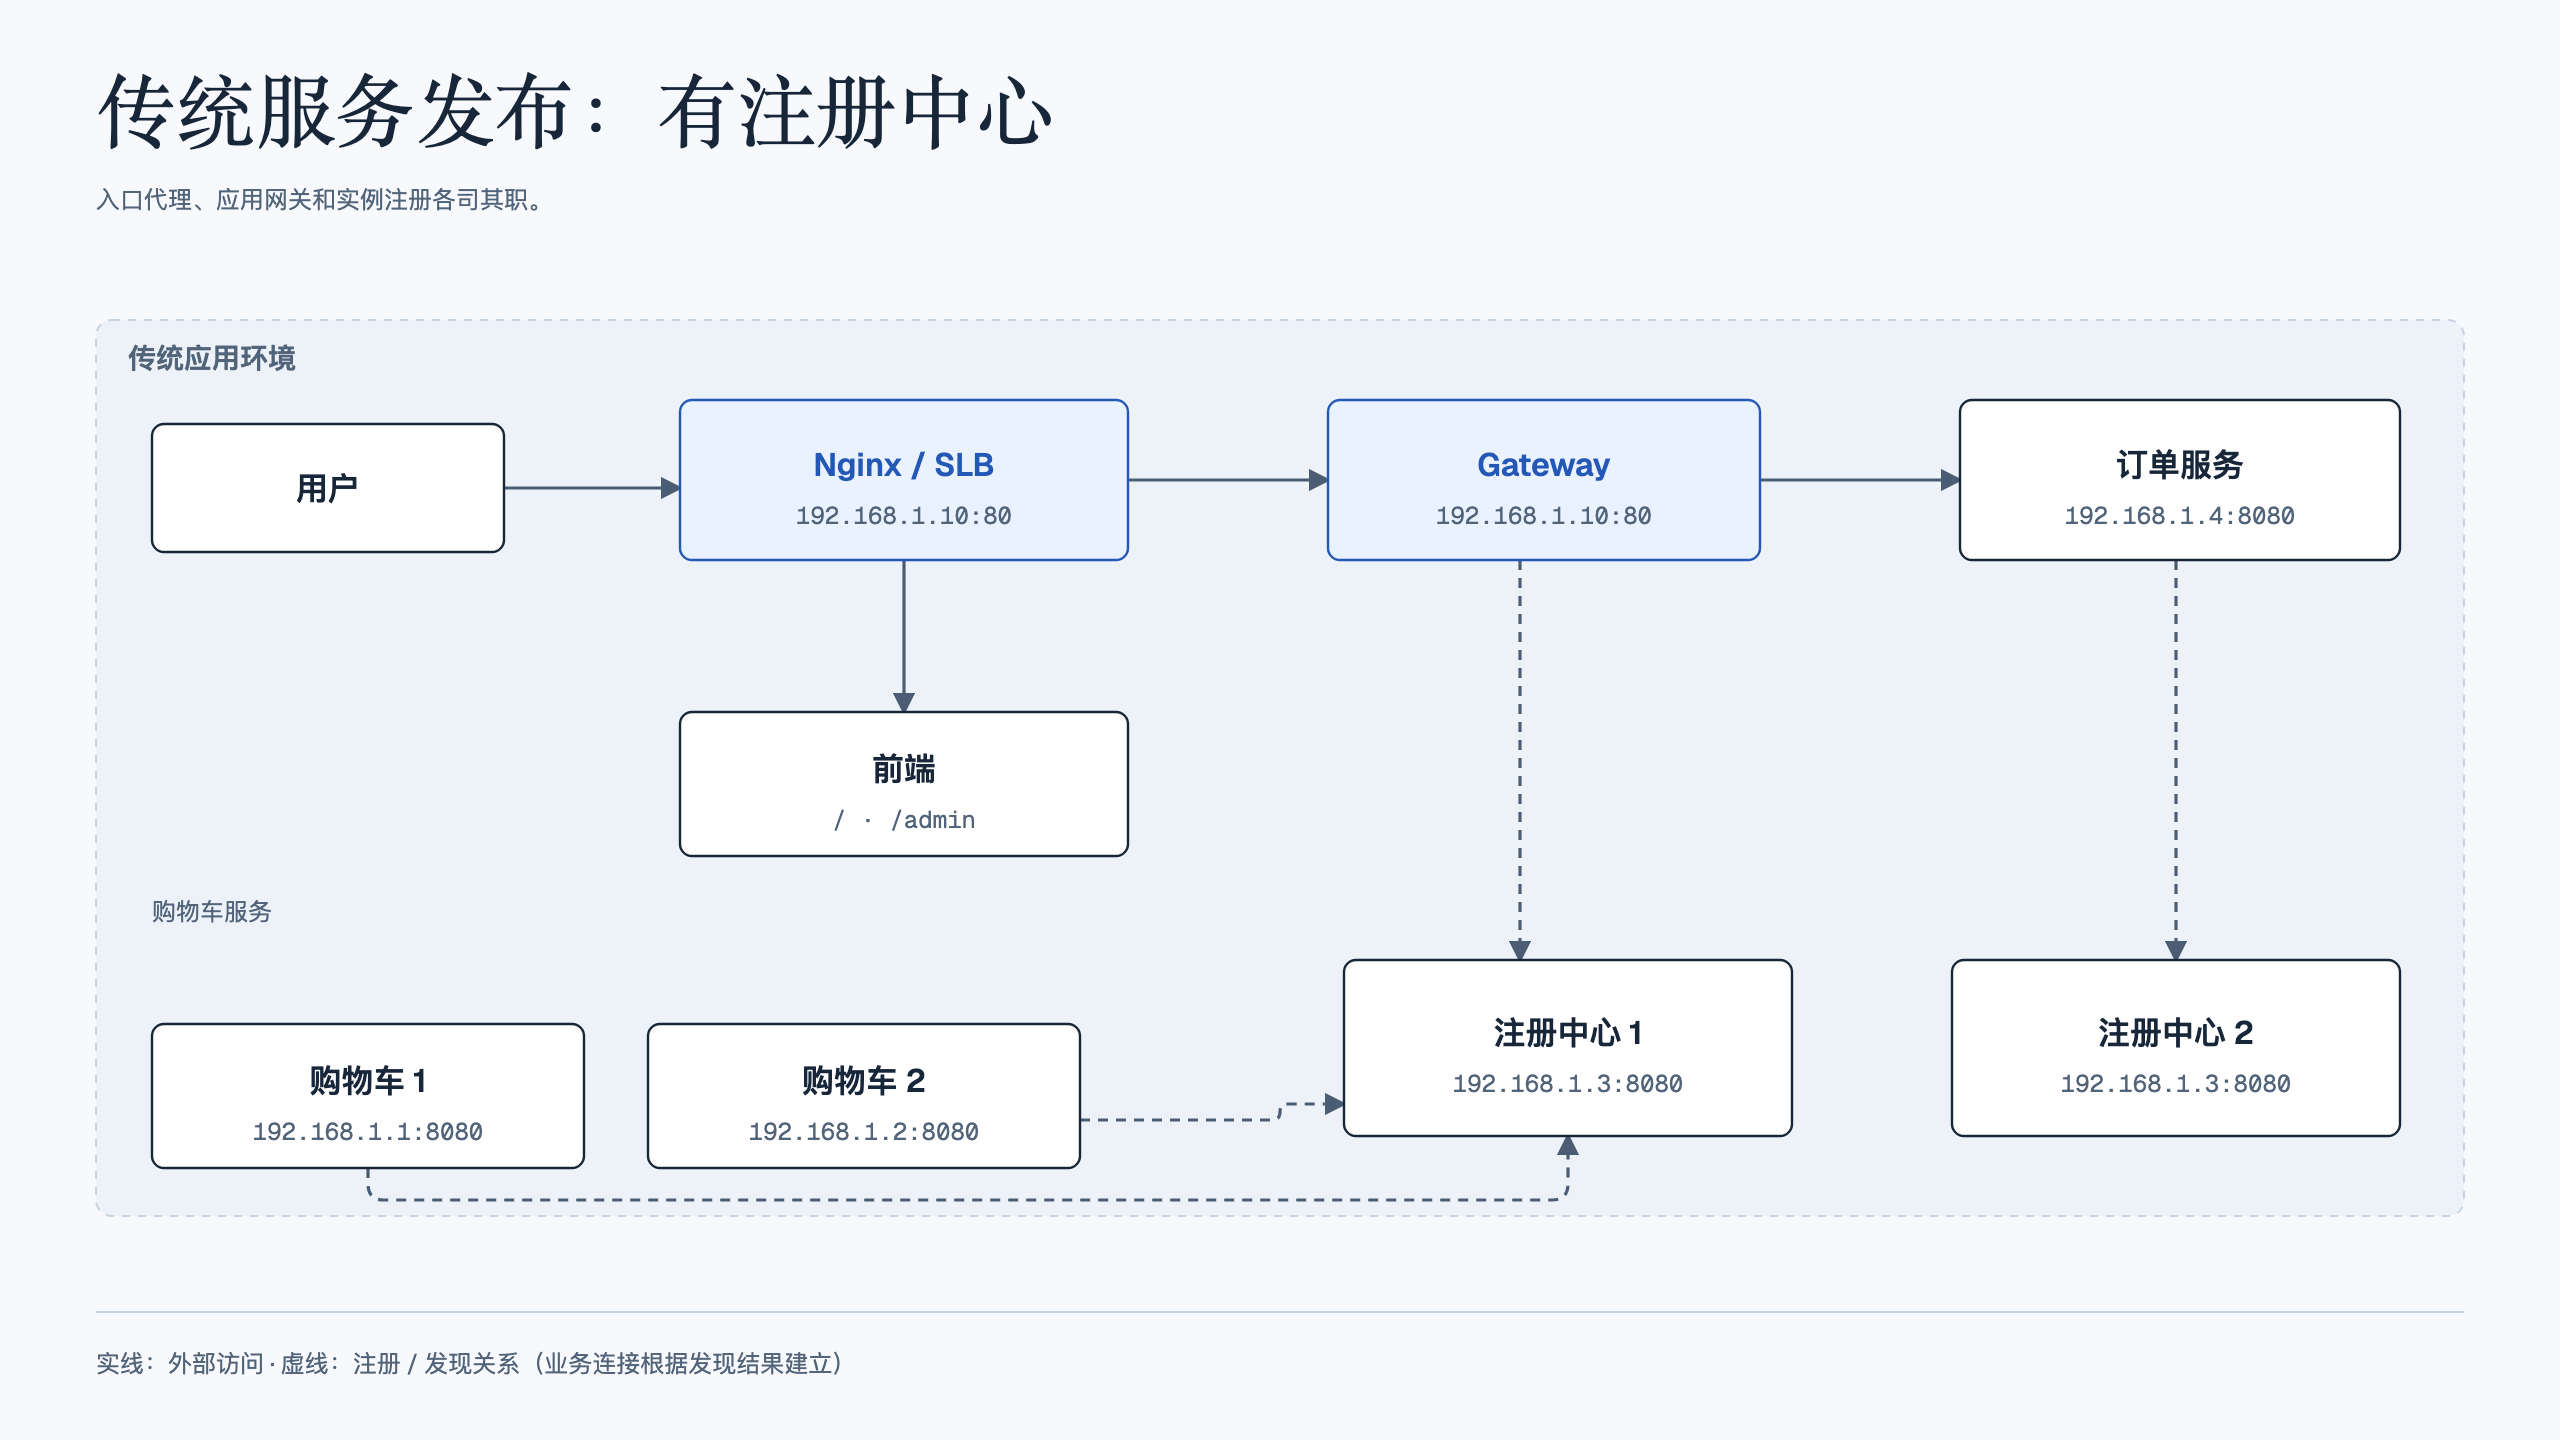
引入注册中心后,服务可以先查询目标实例的 IP 和端口,再建立连接。外部请求仍可能经过 Nginx 或 SLB 到达应用网关,再由网关路由到各个服务。注册中心解决实例发现,入口代理承担外部接入,两者的职责不同。
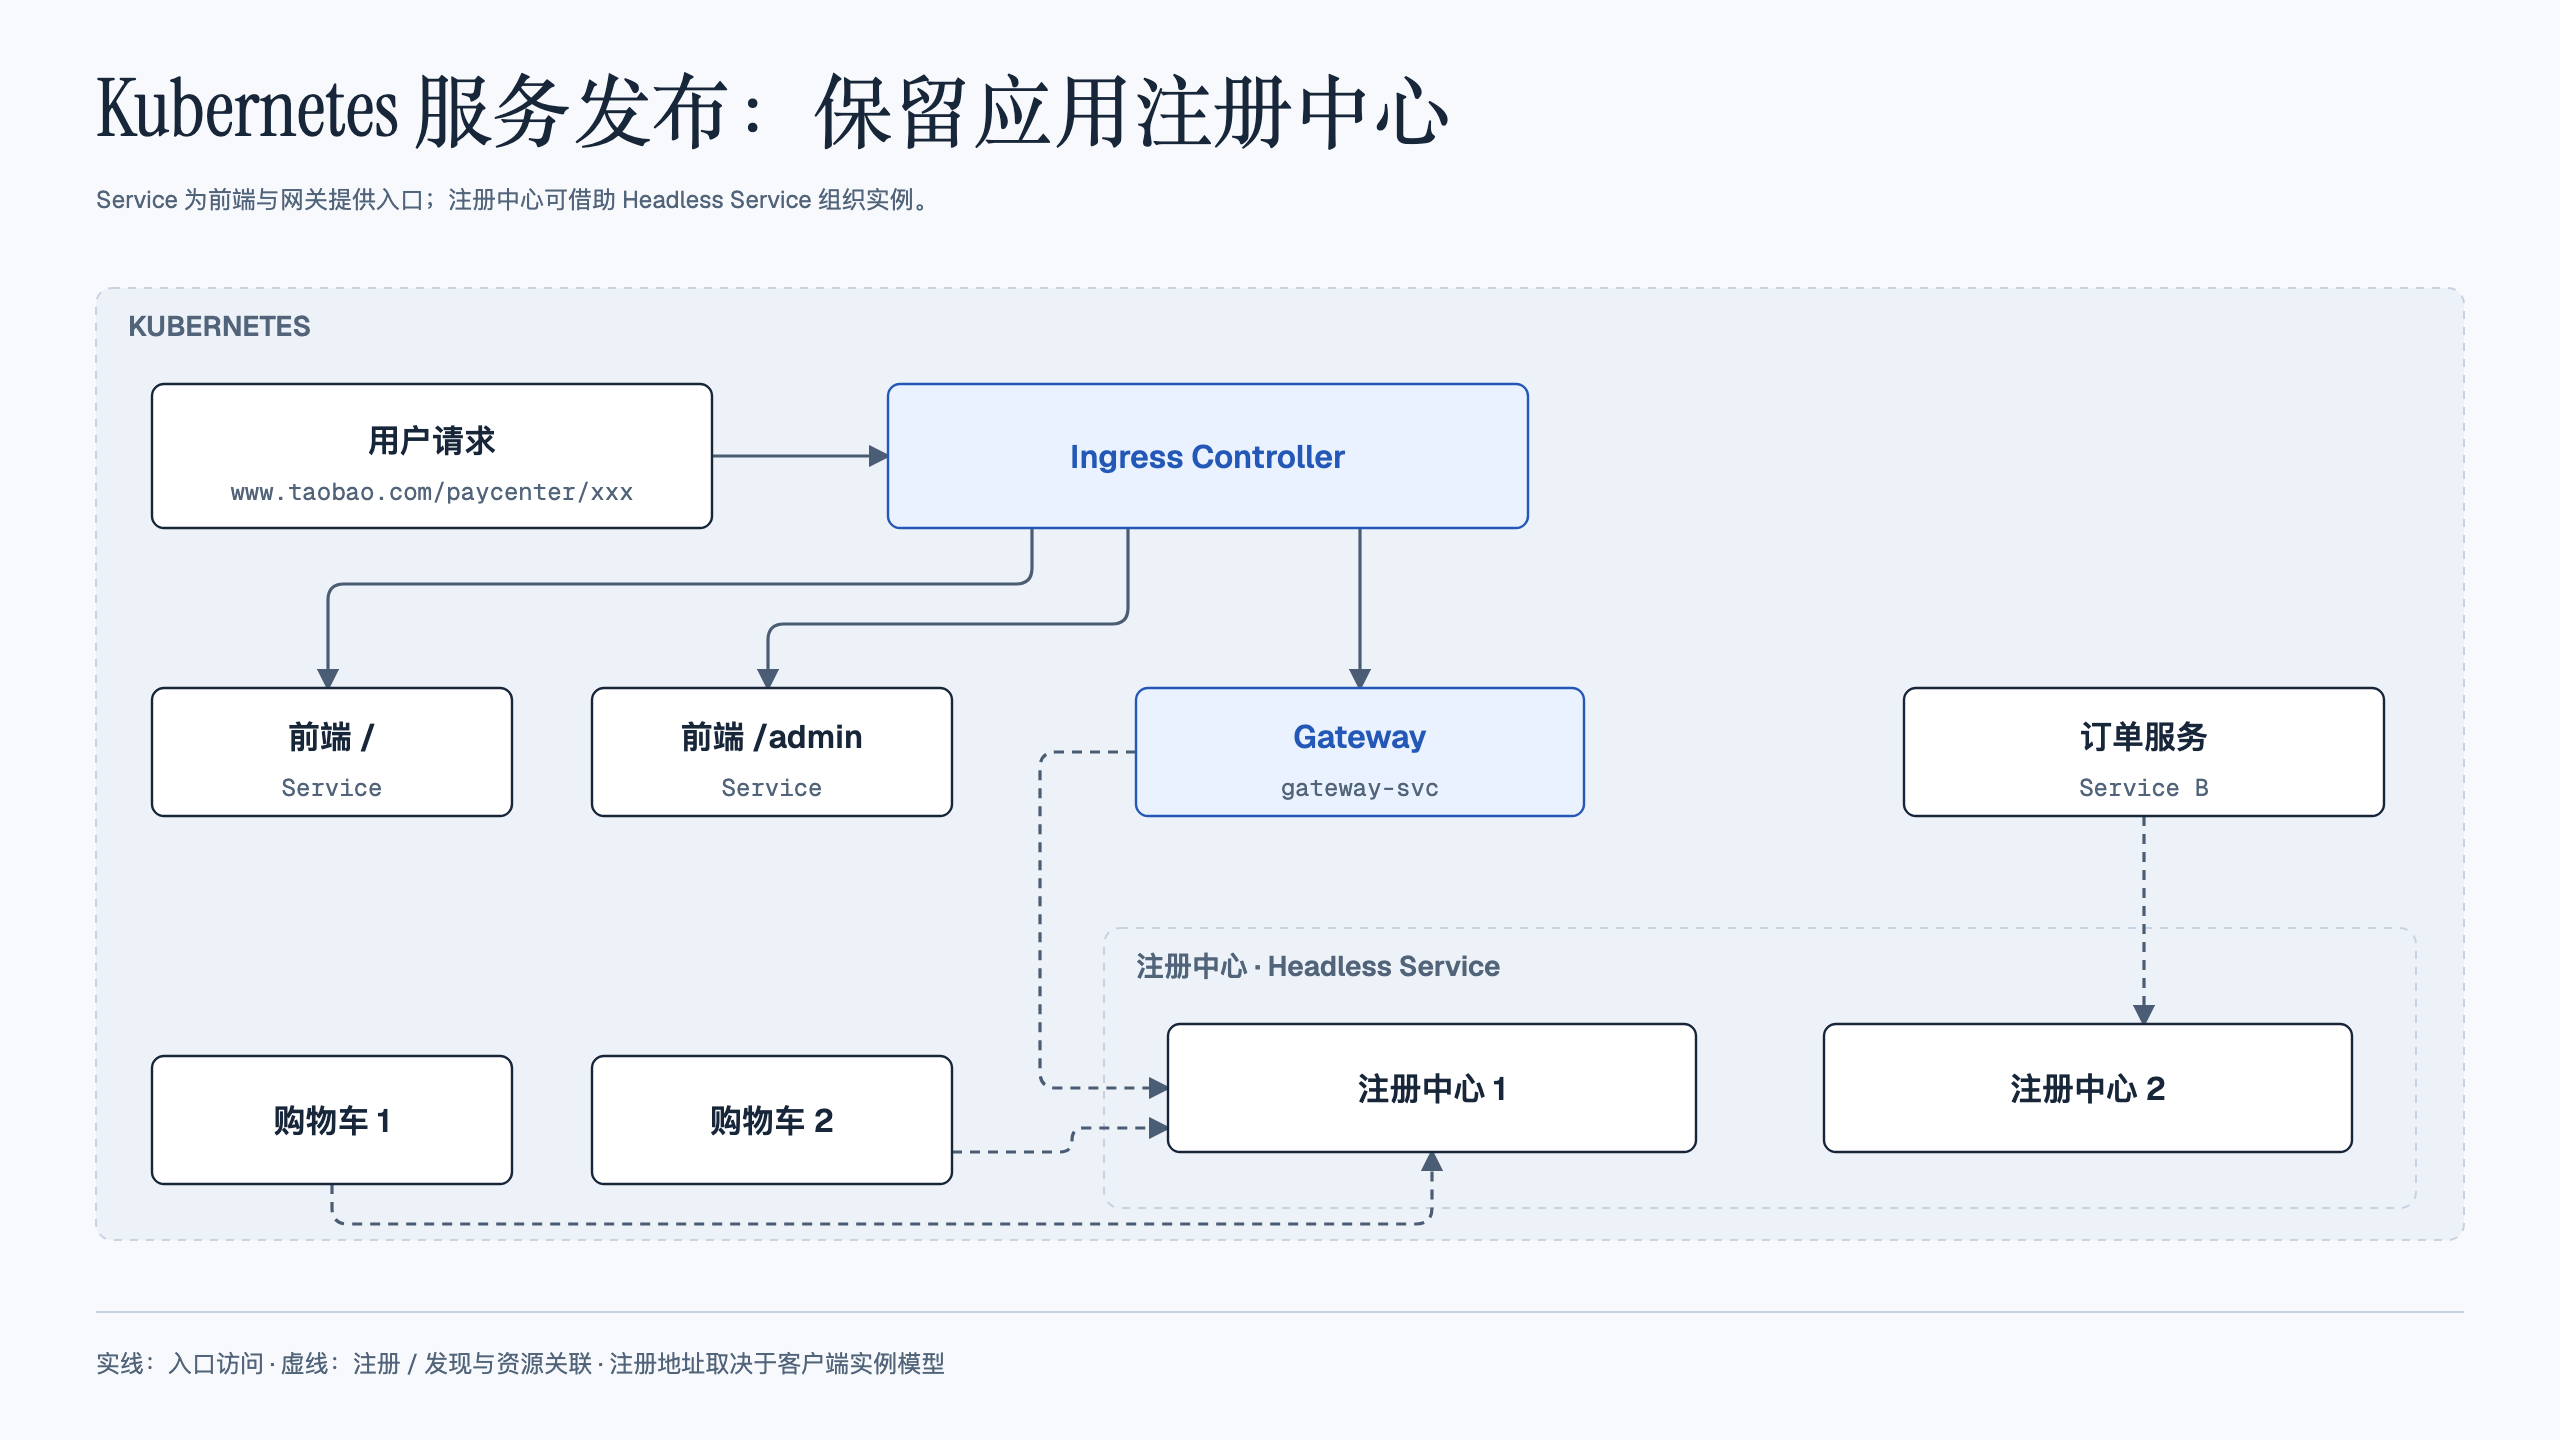
在 Kubernetes 中继续使用 Eureka 等注册中心时,要先确认客户端怎样注册和发现实例。StatefulSet 可借助 Headless Service 获得稳定的 Pod DNS 名称;Deployment 也可以通过 Service 提供稳定入口。究竟注册 Pod 地址、Pod DNS 还是 Service 地址,取决于注册中心客户端的实例模型,不能按工作负载类型一概决定。HTTP 网关可通过 Ingress 或其他入口暴露。
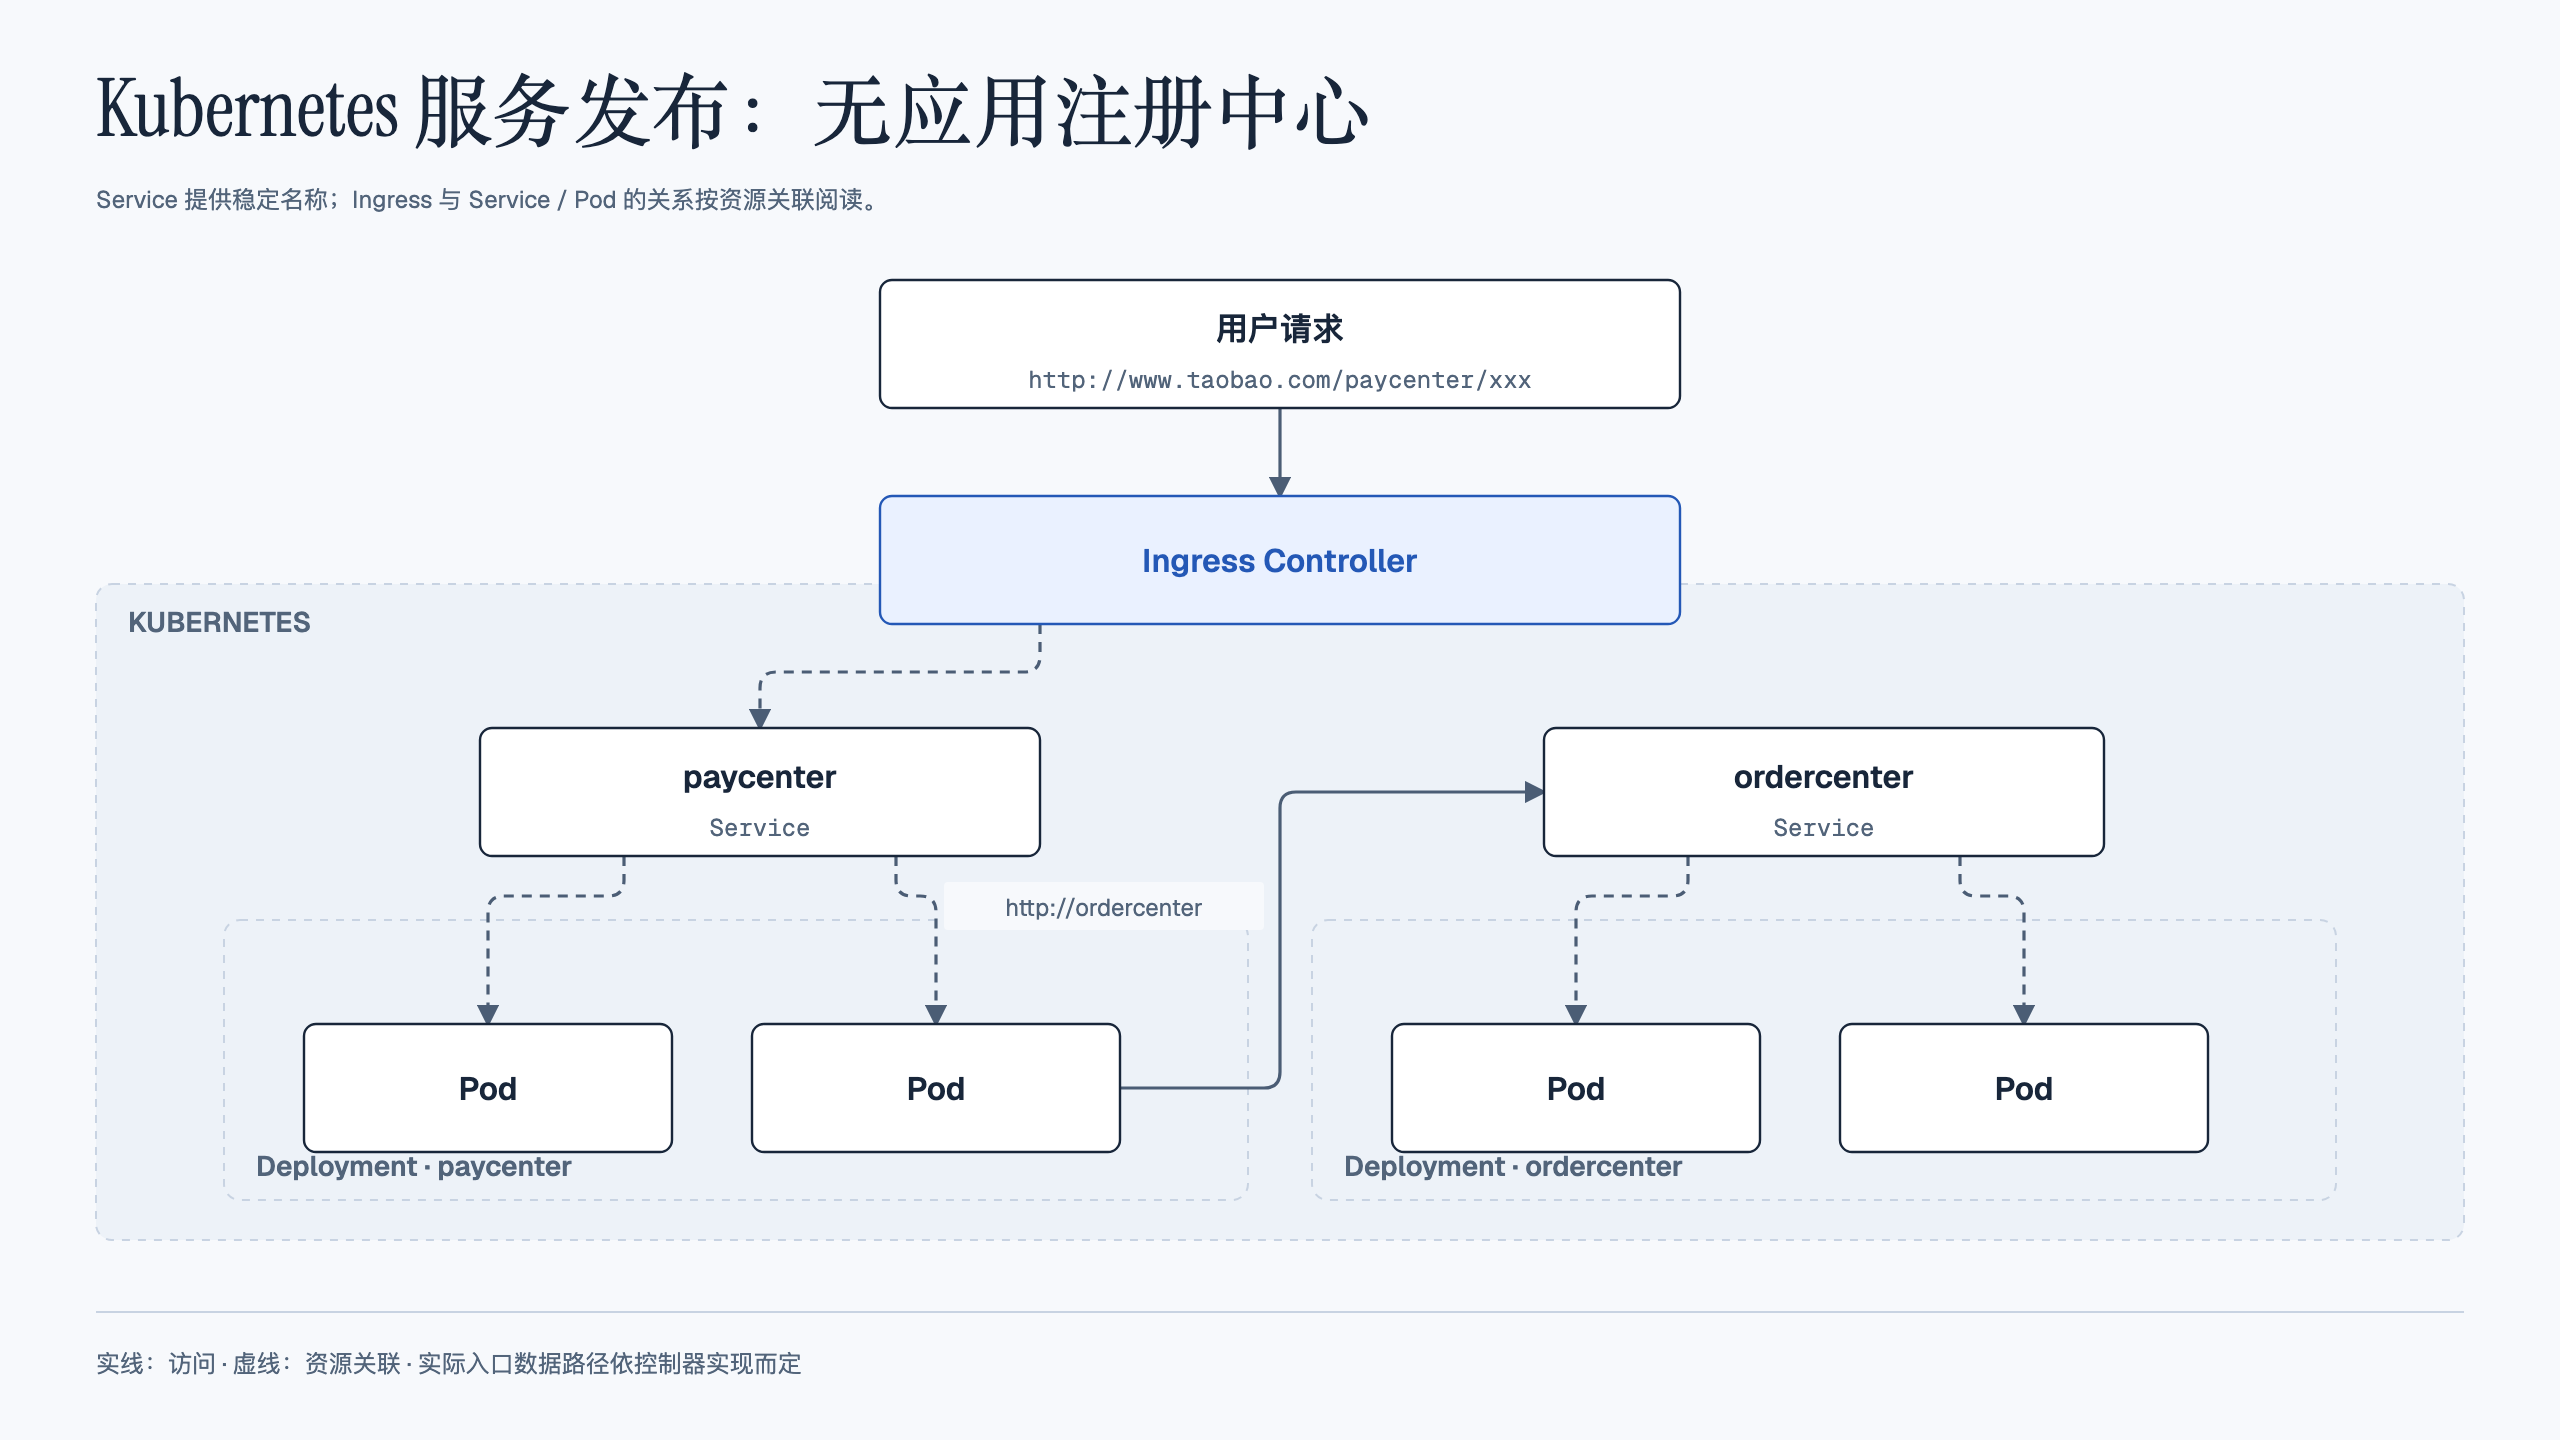
没有单独的应用注册中心时,集群内服务和基础组件常通过 Service DNS 发现彼此;HTTP 外部访问可以使用 Ingress。图中的 Ingress → Service → Pod 表示资源关联关系,实际数据路径取决于入口实现,某些控制器会直接转发到 Service 对应的后端地址。
直接访问 Pod IP 的限制
Pod 通常会获得自己的 IP,但重建后地址可能变化。它的外部可达性取决于 CNI、路由和安全规则,通常不会直接作为对外发布入口。Pod IP 与 Service 的虚拟 ClusterIP 也不是同一类地址。
Service 如何提供稳定入口
Service 把一组提供相同功能的后端抽象为一个逻辑服务。常见的 ClusterIP Service 在自身生命周期内保持稳定地址,selector 根据 Pod 标签决定关联哪些后端;Pod 重启、迁移、扩缩容后,调用者仍使用原来的 Service 名称。
因此,应用调用时不必自己追踪每个 Pod IP。需要注意的是,Service 删除后重建并不保证获得原 IP;客户端使用 DNS 名称通常更方便。Headless 和 ExternalName 是后面会讨论的特殊形式,并不都分配虚拟 IP。
EndpointSlice 保存实际后端
对于带 selector 的 Service,控制器根据同一 Namespace 中匹配标签的 Pod 维护 EndpointSlice。Slice 保存后端 IP、端口和就绪条件;Pod 重建、就绪状态或地址变化后,控制器会更新这些记录,数据平面再据此更新转发规则。
早期资料使用与 Service 同名的 Endpoints 对象。Endpoints API 已从 Kubernetes v1.33 起弃用,新的集成应优先使用 EndpointSlice;Slice 通过 kubernetes.io/service-name 标签关联 Service,名称不必相同。旧 Endpoints 还有双栈和大规模地址列表方面的限制,参见官方 Service 说明。
kubectl get svc svc-nginx -n default
kubectl get endpointslices -n default -l kubernetes.io/service-name=svc-nginx -o wide
一次连接通常由节点数据平面根据规则选定一个后端,不会每个数据包都去实时查询 API Server。Service 定义稳定入口,EndpointSlice 描述可用后端,kube-proxy 等实现负责把二者落实为转发行为。
通过 DNS 访问 Service
Kubernetes 通常使用 CoreDNS 为 Service 提供服务发现。普通 ClusterIP Service 的 DNS 记录指向虚拟 IP;Headless Service 则通常返回后端地址;ExternalName 返回 CNAME。解析成功只说明发现了地址,不代表应用端口一定可达。
Service 的完整 DNS 名称通常包含服务名、命名空间和集群域。以默认集群域 cluster.local 为例,default 中的 svc-nginx 可通过下面的名称访问:
svc-nginx.default.svc.cluster.local在 Pod 中测试时,先用实际 Pod 名替换示例中的名称,再执行查询或请求。进入容器后的 curl 使用 Service DNS,而非某个后端 Pod 地址:
kubectl exec -it dep-nginx-57886b49fb-f2bk2 -- /bin/bash
curl svc-nginx.default.svc.cluster.local
同一命名空间内通常可以使用短名称 svc-nginx,跨命名空间可使用 svc-nginx.default。具体搜索后缀由 Pod 的 DNS 配置决定。
YAML 字段:重点看地址、选择器和端口
下面列出常用字段的阅读示例,实际字段以目标集群的 kubectl explain 和Service API为准。命令输出不是可直接 apply 的 YAML。旧版本字段可能已移除,例如 topologyKeys;loadBalancerIP 也已弃用。
# spec
kubectl explain service.spec

KIND:     Service
VERSION:  v1
RESOURCE: spec <Object>
DESCRIPTION:
     Spec defines the behavior of a service.
     https://git.k8s.io/community/contributors/devel/sig-architecture/api-conventions.md#spec-and-status
     ServiceSpec describes the attributes that a user creates on a service.
FIELDS:
   allocateLoadBalancerNodePorts	<boolean>
   clusterIP	<string> #通常由集群分配,也可在创建时指定;常规更新中不可变
   clusterIPs	<[]string>
   externalIPs	<[]string>
   externalName	<string>
   externalTrafficPolicy	<string>
   healthCheckNodePort	<integer>
   ipFamilies	<[]string>
   ipFamilyPolicy	<string>
   loadBalancerIP	<string>
   loadBalancerSourceRanges	<[]string>
   ports	<[]Object>  #定义service端口,用来和后端pod建立联系
   publishNotReadyAddresses	<boolean>
   selector	<map[string]string> #通过标签选择器选择关联的pod有哪些
   sessionAffinity	<string>
   sessionAffinityConfig	<Object> #service在实现负载均衡的时候还支持sessionAffinity,会话联系,默认是none,随机调度的(基于iptables规则调度的);如果我们定义sessionAffinity的client ip,那就表示把来自同一客户端的IP请求调度到同一个pod上
   type	<string>  #定义service的类型

#spec.ports
kubectl explain service.spec.ports

KIND:     Service
VERSION:  v1
RESOURCE: ports <[]Object>
DESCRIPTION:
     The list of ports that are exposed by this service. More info:
     https://kubernetes.io/docs/concepts/services-networking/service/#virtual-ips-and-service-proxies
     ServicePort contains information on service's port.
FIELDS:
   appProtocol	<string>
   name	<string>  #定义端口的名字
   nodePort	<integer>   #service在物理机映射的端口,默认在 30000-32767 之间
   port	<integer> -required-  #service的端口,这个是k8s集群内部服务可访问的端口
   protocol	<string>
   targetPort	<integer|string> #后端监听端口,可用数字或Pod容器端口名称指定
选择器应匹配 Pod 模板上的标签,而不是 Deployment 对象自身的标签。匹配不到就绪后端时,Service 仍可能已经创建,但无法把请求送到预期应用。
四种 Service 类型
ClusterIP
ClusterIP 是默认类型,为服务分配集群内部的虚拟 IP。下面用一个三副本 Nginx Deployment 和匹配其标签的 Service 演示;它们属于同一 Namespace,port 接收客户端请求,targetPort 对应后端实际监听端口。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: dep-nginx
spec:
  selector:
    matchLabels:
      run: nginx # 标签要写pod的标签,也就是deployment的选择器匹配的标签,而不是deployment自己的标签。
  replicas: 3
  template:
    metadata:
      labels:
        run: nginx
    spec:
      containers:
      - name: nginx
        image: docker.io/library/nginx:latest
        imagePullPolicy: IfNotPresent
        ports:
        - containerPort: 80  #pod中的容器需要暴露的端口
---
apiVersion: v1
kind: Service
metadata:
  name: svc-nginx
  labels:
    run: nginx
spec:
  selector:
    run: nginx
  type: ClusterIP
  ports:
  - name: port-svc-nginx
    port: 80 # service 暴露的端口
    protocol: TCP
    targetPort: 80 # pod暴露的端口
在仍使用 IPVS 的节点上,可以查看 Service 到后端的映射:
ipvsadm -LnTCP 10.99.178.109:80 rr
-> 10.244.184.54:80 Masq 1 0 0
-> 10.244.184.55:80 Masq 1 0 0
-> 10.244.190.30:80 Masq 1 0 0Headless Service 通过 clusterIP: None 禁用虚拟 ClusterIP,DNS 通常返回实际后端地址,由客户端选择连接目标;客户端也可以直接使用这些地址。它不是第五种 Service type,常用于 StatefulSet 的稳定网络标识。
在节点上能访问 ClusterIP,不代表节点能解析 Service DNS。宿主机通常不使用 CoreDNS 作为默认解析器,DNS 测试应优先放在 Pod 内。
NodePort
NodePort 在 ClusterIP 的基础上分配一个节点端口,让客户端可以通过 NodeIP:nodePort 访问。默认端口范围是 30000 到 32767,可由 API Server 的 --service-node-port-range 配置。
默认集群转发策略下,请求可从一个节点进入后再转发到其他节点的 Pod。实际可用的节点地址受 kube-proxy 的 nodePortAddresses、防火墙和路由约束;externalTrafficPolicy: Local 则只转发给本节点符合条件的后端,没有本地后端的节点可能无法服务。
常见链路为 客户端 → NodeIP:nodePort → 节点转发规则 → PodIP:targetPort,不要求经过 docker0。NodePort 也不一定表现为用户进程监听的 socket,不能只凭 ss 或 netstat 没有监听就判断服务失效;需要结合代理模式、规则和实际请求检查。
apiVersion: v1
kind: Service
metadata:
  name: svc-nginx-nodeport
  labels:
    run: nginx
spec:
  selector:
    run: nginx
  type: NodePort
  ports:
  - port: 80 #svc端口
    protocol: TCP
    targetPort: 80 # pod端口
    nodePort: 30380 #pod端口映射到物理机的端口
ExternalName
ExternalName 通过 DNS 返回 CNAME,把集群内名称映射到另一个域名。它不使用 selector 选择 Pod,也不建立数据转发或端口映射。HTTP Host 和 TLS 证书名称不会自动改写,访问外部 HTTPS 服务时尤其需要核对名称,见ExternalName 官方说明。
下面的 Service 指向外部域名。使用 nslookup 查询它时,集群 DNS 返回指向 www.taobao.com 的 CNAME;后续连接仍受目标协议和名称校验约束:
kind: Service
apiVersion: v1
metadata:
  name: my-externalname
spec:
  type: ExternalName
  externalName: www.taobao.com
用相同名称连接不同环境的 Redis
假设项目有 DEV、UAT 两个环境,各自连接独立的 Redis。基础组件分别部署在 basic-component-dev 和 basic-component-uat 命名空间,应用则分别部署在 projecta-dev 和 projecta-uat。
在两个应用命名空间中各创建名为 redis 的 ExternalName Service,分别指向对应环境的 Redis DNS。应用统一连接 redis:6379,由所在命名空间决定解析结果,无需在业务配置里写入另一环境的地址。
环境准备:
#  创建 Namespace
kubectl create ns basic-component-dev
kubectl create ns basic-component-uat
#  创建服务
kubectl create deploy redis -n basic-component-dev --image=registry.cn-beijing.aliyuncs.com/dotbalo/redis:7.2.5
kubectl create deploy redis -n basic-component-uat --image=registry.cn-beijing.aliyuncs.com/dotbalo/redis:7.2.5
#  创建 Service
kubectl expose deploy redis --port 6379 -n basic-component-dev
kubectl expose deploy redis --port 6379 -n basic-component-uat
访问测试:
# 创建专门用于测试的 Redis 客户端
kubectl create deploy redis-cli -n default --image=registry.cn-beijing.aliyuncs.com/dotbalo/redis:7.2.5
kubectl rollout status deployment/redis-cli -n default
# 每条命令都从当前终端发起,完成后直接返回,不进入交互式 Redis 会话
kubectl exec deployment/redis-cli -n default -- redis-cli -h redis.basic-component-dev set a dev
kubectl exec deployment/redis-cli -n default -- redis-cli -h redis.basic-component-dev get a
# 预期返回 dev
kubectl exec deployment/redis-cli -n default -- redis-cli -h redis.basic-component-uat set a uat
kubectl exec deployment/redis-cli -n default -- redis-cli -h redis.basic-component-uat get a
# 预期返回 uat
创建项目的两个命名空间:
kubectl create ns projecta-dev
kubectl create ns projecta-uat
接着创建两份同名的 ExternalName Service,注意它们属于不同命名空间,externalName 也指向不同的后端。这里假设集群 DNS 后缀为 cluster.local:
kind: Service
apiVersion: v1
metadata:
  name: redis
  namespace: projecta-dev
spec:
  type: ExternalName
  externalName: redis.basic-component-dev.svc.cluster.local
---
kind: Service
apiVersion: v1
metadata:
  name: redis
  namespace: projecta-uat
spec:
  type: ExternalName
  externalName: redis.basic-component-uat.svc.cluster.local
在两个应用环境中分别创建 Redis 客户端,模拟业务连接:
kubectl create deploy usercenter --image=registry.cn-beijing.aliyuncs.com/dotbalo/redis:7.2.5 -n projecta-dev
kubectl create deploy usercenter --image=registry.cn-beijing.aliyuncs.com/dotbalo/redis:7.2.5 -n projecta-uat
分别测试两个环境的 ExternalName:
# DEV 环境
kubectl rollout status deployment/usercenter -n projecta-dev
kubectl exec deployment/usercenter -n projecta-dev -- redis-cli -h redis get a
# 预期返回 dev
# UAT 环境
kubectl rollout status deployment/usercenter -n projecta-uat
kubectl exec deployment/usercenter -n projecta-uat -- redis-cli -h redis get a
# 预期返回 uat
LoadBalancer
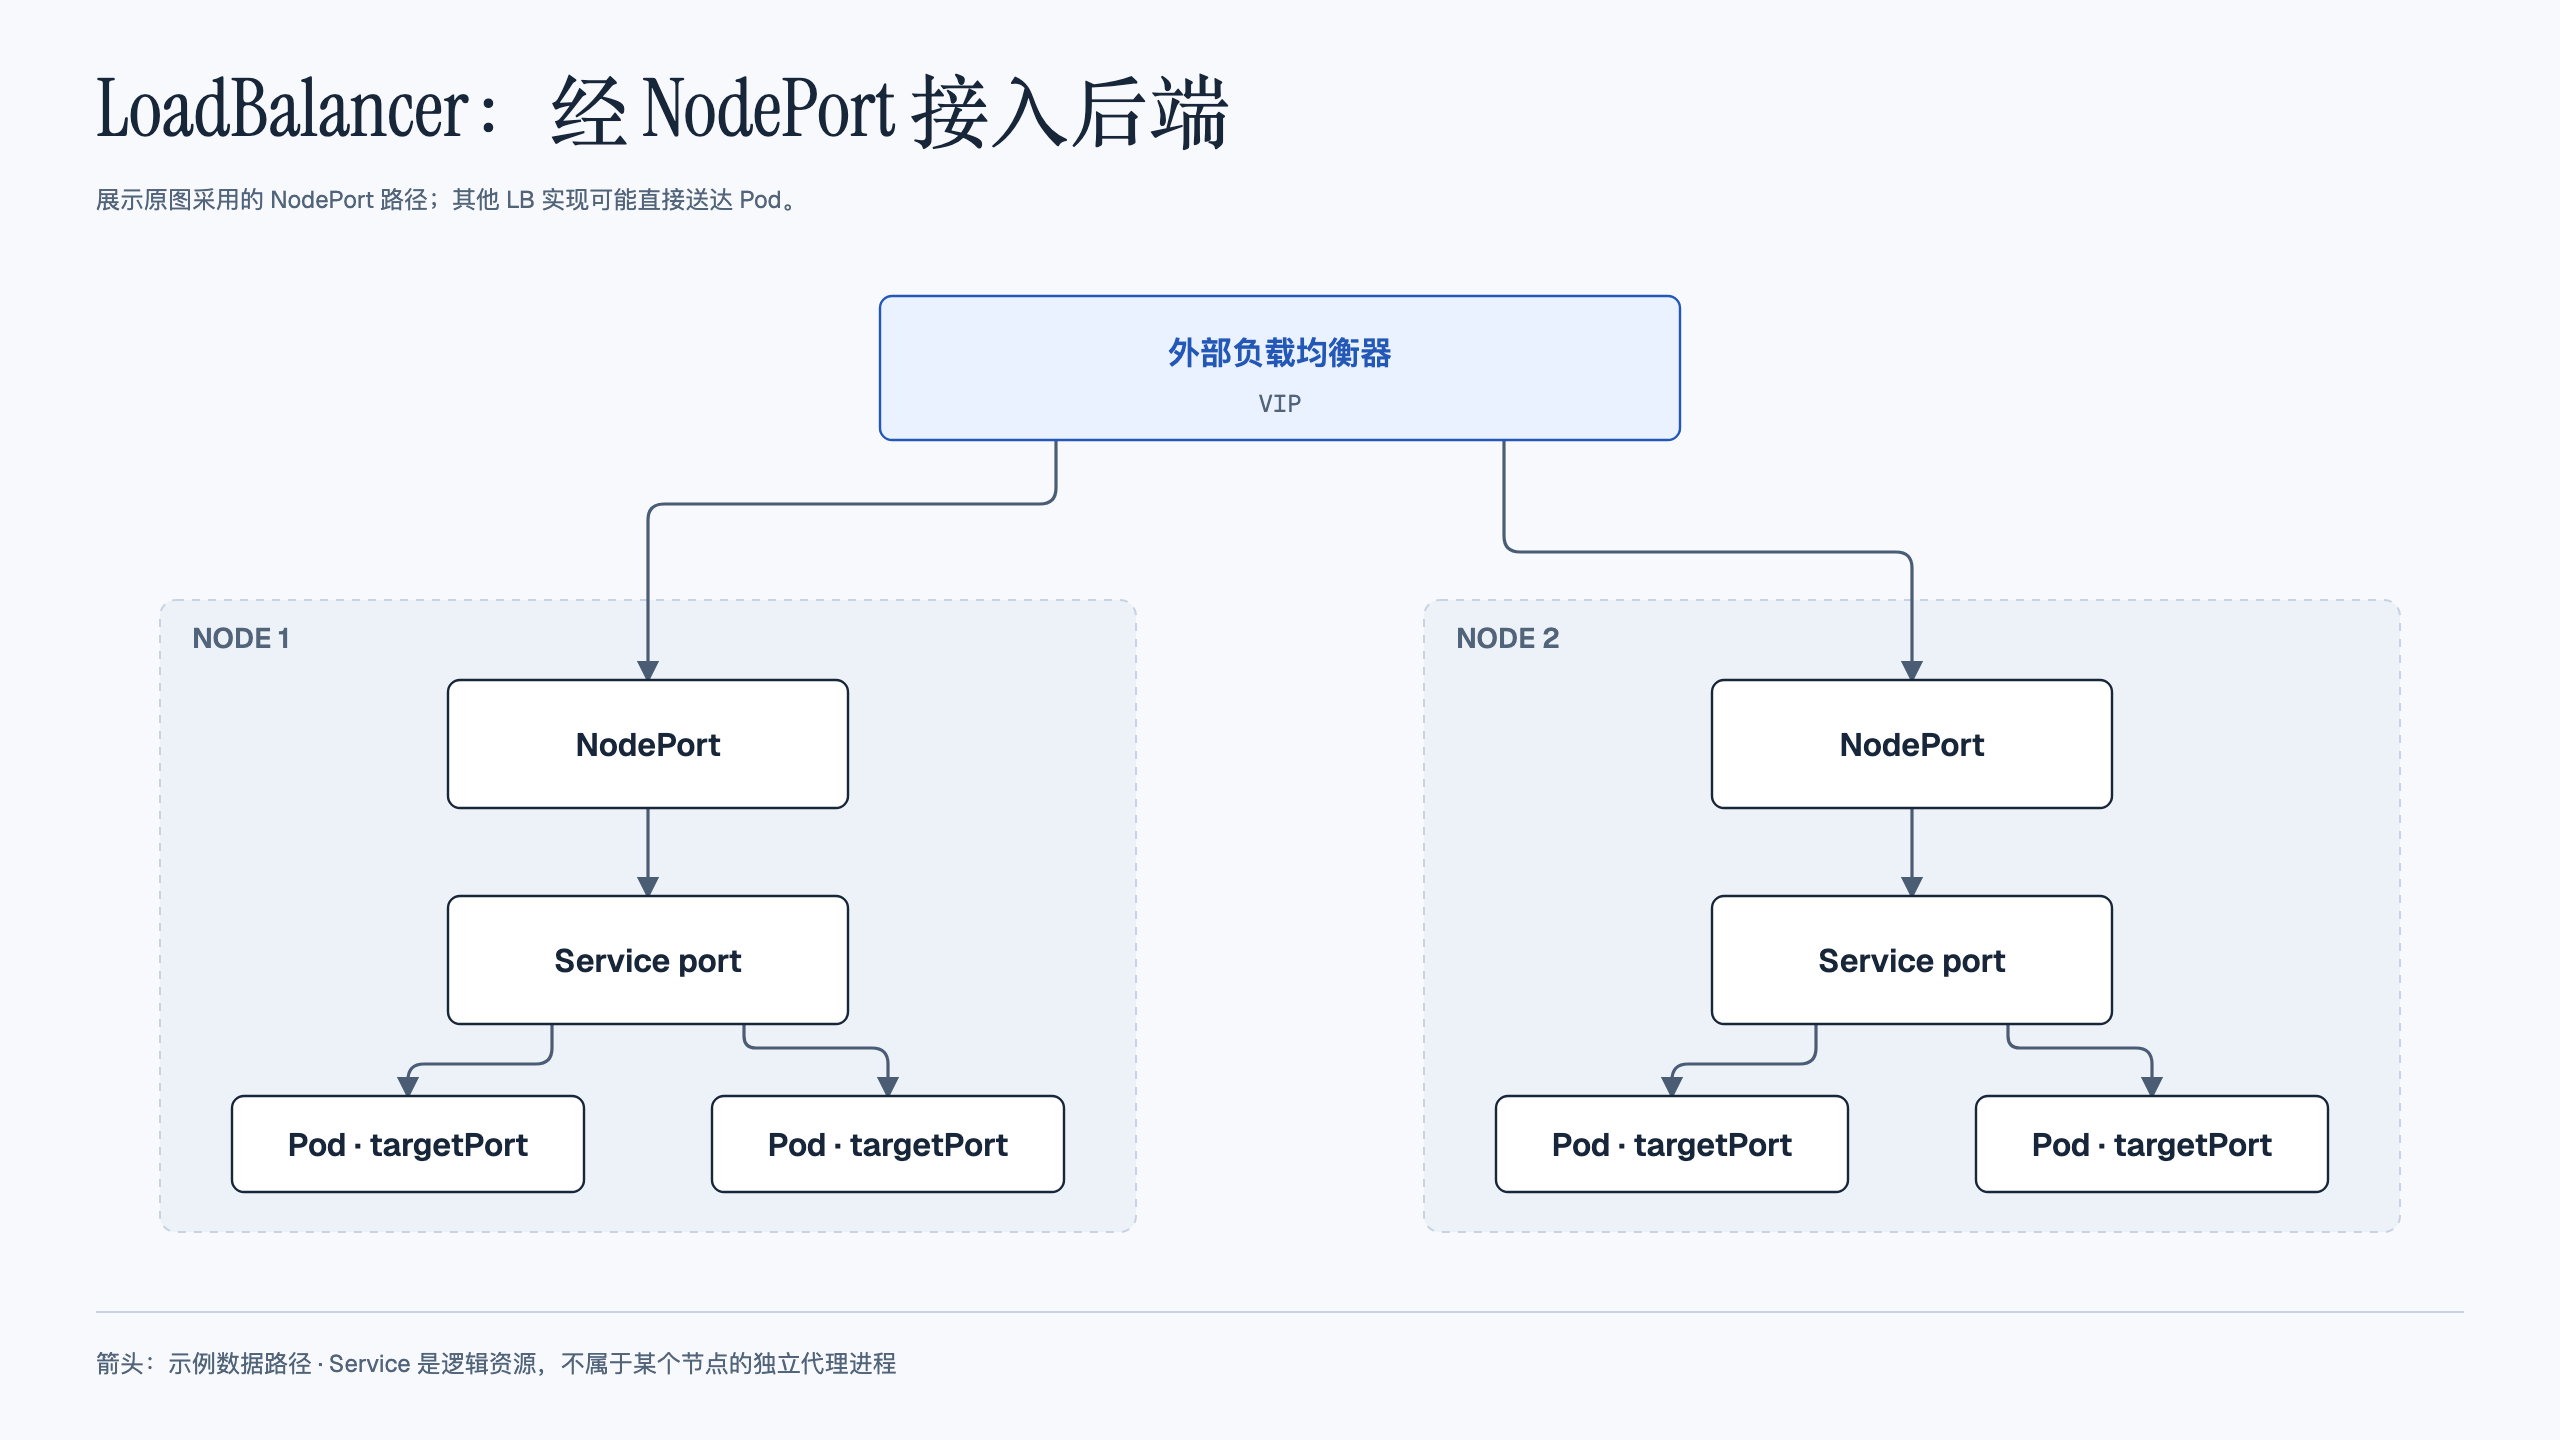
LoadBalancer 通过集群的负载均衡实现申请或配置外部入口。公有云通常由云控制器对接云 LB,裸机也可以使用兼容的实现,并非必须有公有云。 Azure 的两种常见入口可分别对照官方部署说明:
- Internal LB:创建内部负载均衡器 - Azure Kubernetes Service | Azure Docs
- External LB:在 Azure Kubernetes 服务 (AKS) 中使用公共负载均衡器 - Azure Kubernetes Service | Azure Docs
流量可能经由 NodePort,也可能由具体实现直接送到 Pod,取决于云平台、网络和 LB 配置,不能统一假设直连 Pod。
无 selector 的 Service:接入外部后端
Service 的后端也可以位于集群外。调用方继续使用约定的 Service 名称,后端地址变化时,由资源维护者更新映射,减少业务配置对固定 IP 的依赖。
不带 selector 的 Service 不会自动发现 Pod 后端,需要自行维护 EndpointSlice。若后端是域名别名,可以使用前面的 ExternalName;若要代理固定 IP,则使用 Service 与 EndpointSlice。
使用场景:
- 希望在生产环境中使用某个固定的名称而非 IP 地址访问外部的中间件服务;
- 希望 Service 指向另一个 Namespace 中或其他集群中的服务;
- 正在将工作负载转移到 Kubernetes 集群,但是一部分服务仍运行在 Kubernetes 集群 之外的 backend。
示例:集群引用外部 MySQL 数据库
假设 node2 上运行一个数据库实例,地址为 192.168.40.5,集群内希望通过 svc-mysql 访问。
第一步:在实验主机安装数据库
yum install mariadb-server.x86_64 -y
systemctl start mariadb
第二步:创建无 selector 的 Service
apiVersion: v1
kind: Service
metadata:
  name: svc-mysql
spec:
  type: ClusterIP
  ports:
  - name: mysql
    port: 3306
# 没有 selector,不会自动生成后端 EndpointSlice
第三步:创建 EndpointSlice
kubernetes.io/service-name 必须匹配 Service 名称,资源位于同一 Namespace;managed-by 用于标识维护者。
apiVersion: discovery.k8s.io/v1
kind: EndpointSlice
metadata:
  name: svc-mysql-external
  labels:
    kubernetes.io/service-name: svc-mysql
    endpointslice.kubernetes.io/managed-by: example.com/manual
addressType: IPv4
endpoints:
- addresses:
  - "192.168.40.5"
  conditions:
    ready: true
ports:
- name: mysql
  protocol: TCP
  port: 3306
旧集群中可能会看到同名 Endpoints,写法如下。维护旧配置时需要认识这种关联,新配置优先使用上面的 EndpointSlice,不要为同一后端同时手工维护两套来源:
apiVersion: v1
kind: Endpoints
metadata:
  name: svc-mysql
subsets:
- addresses:
  - ip: 192.168.40.5
  ports:
  - name: mysql
    port: 3306
这两种资源的关联方式不同:Endpoints 依赖与 Service 同名,EndpointSlice 依赖标签。MySQL 还需监听可达地址、允许相应用户连接,节点到外部数据库的路由和防火墙也必须放行。Service 不会自动为外部数据库配置认证或高可用。
集群自带的 kubernetes Service
default 命名空间中的 kubernetes Service 为集群内应用提供 API server 入口。Pod 可以通过 kubernetes.default.svc 等名称访问 API,无需固定某一台控制平面节点的地址。
能够连接这个入口不等于获得管理权限。调用仍需通过身份认证和授权,Pod 通常使用自己的 ServiceAccount。控制平面组件也可能通过 kubeconfig 中配置的地址连接 API server,并非所有组件都经由这个 Service。
从 API 对象到节点转发规则
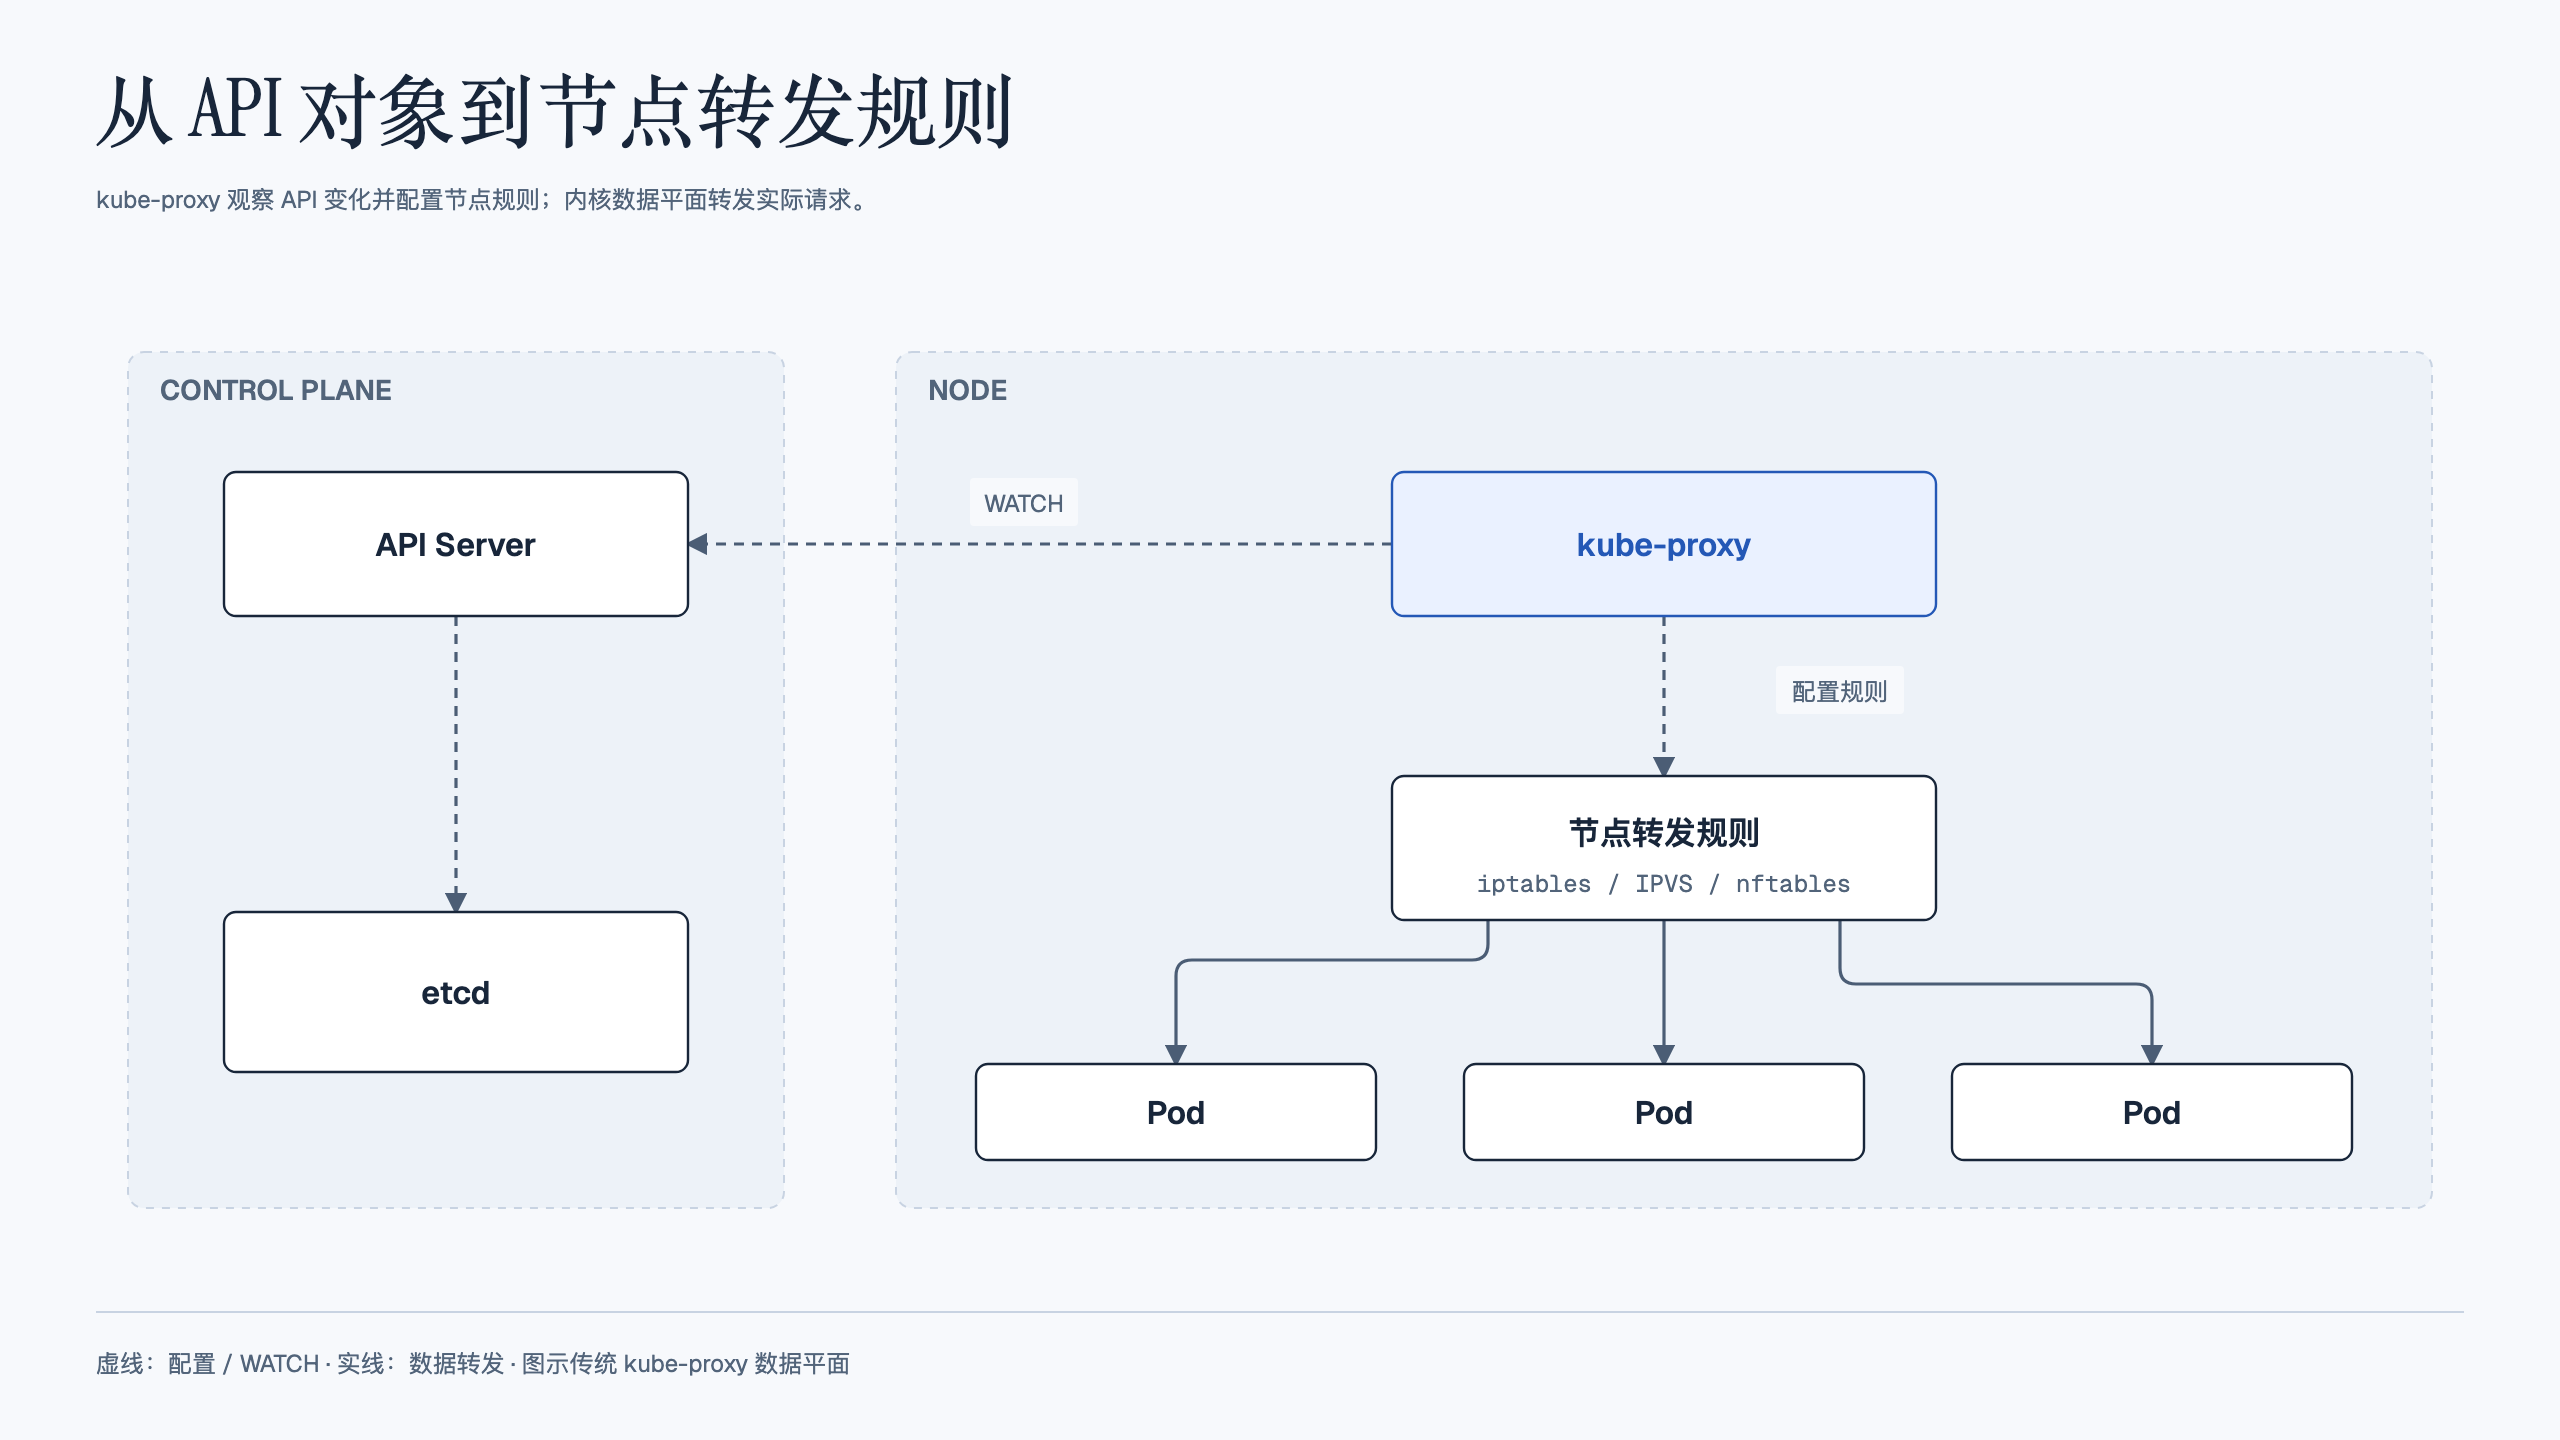
Service 是 API 资源。传统集群由各节点的 kube-proxy 将 Service 和 EndpointSlice 转换为内核转发规则;采用替代数据平面的集群也可能由 CNI 实现 Service 转发,不运行 kube-proxy。
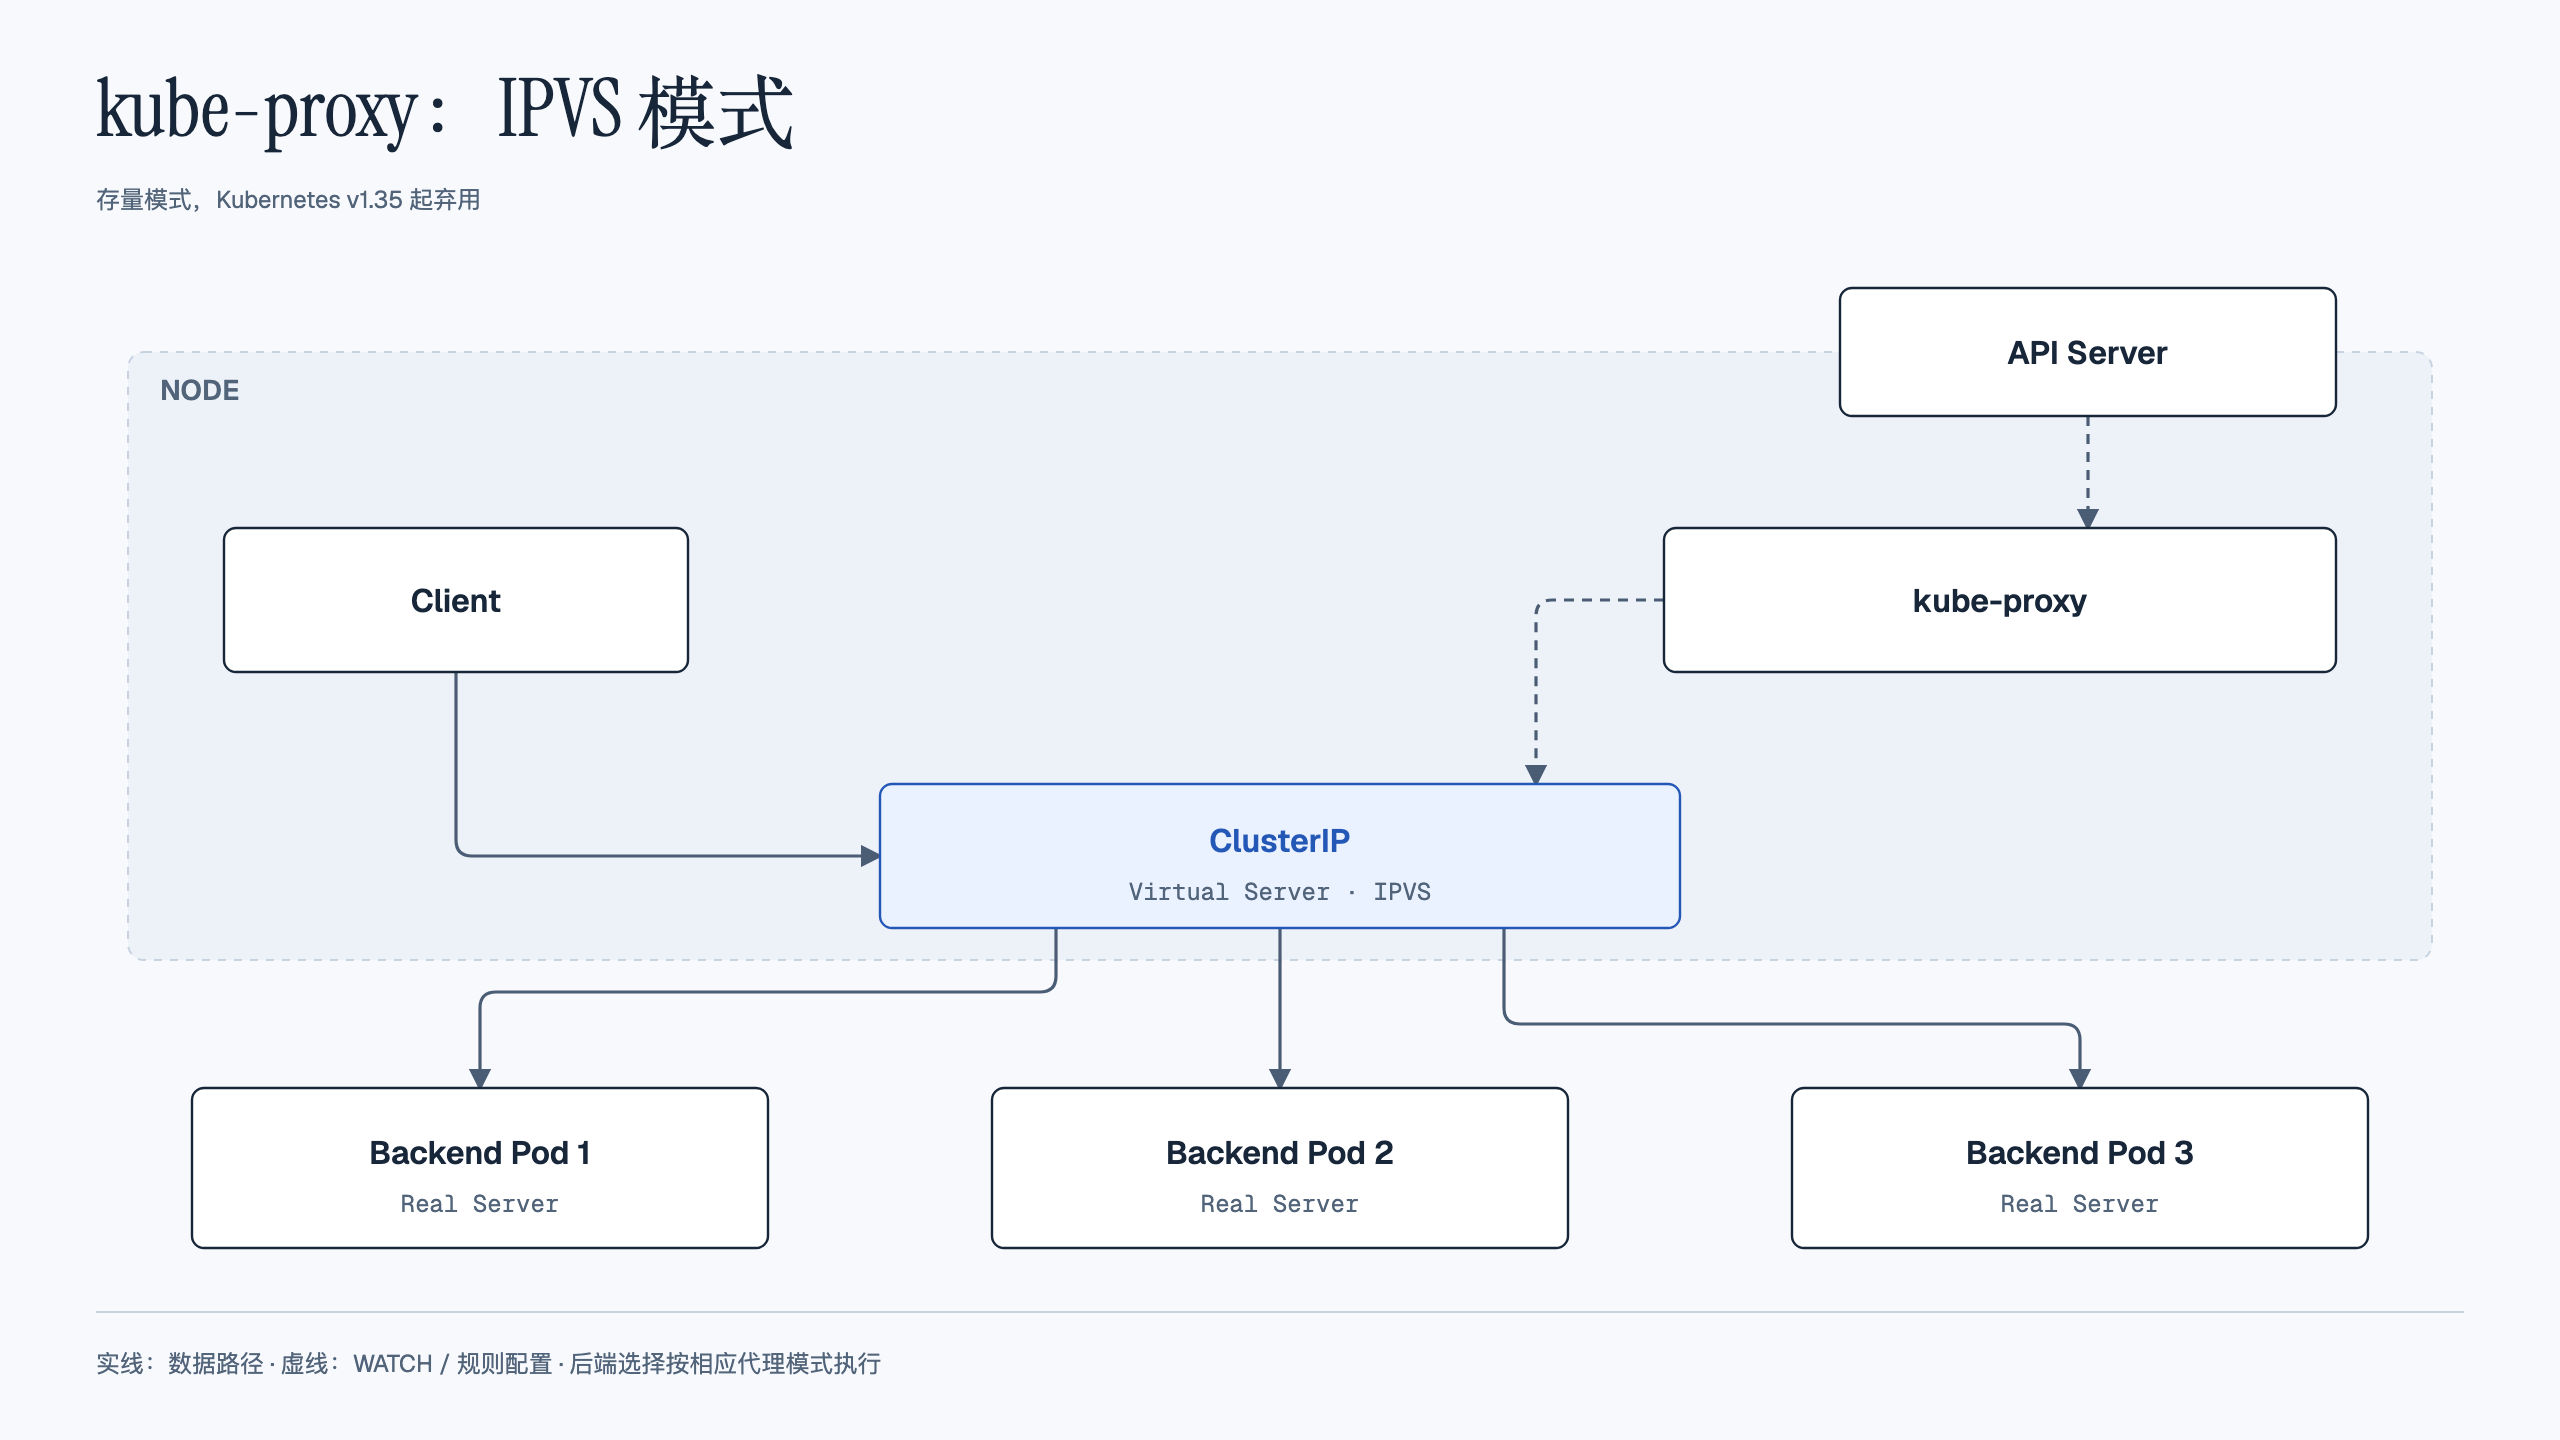
创建 Service 的请求先经过 API Server 并持久化;kube-proxy 通过 watch 观察 Service 和 EndpointSlice 的变化,将它们转换为节点转发规则。在 iptables、IPVS 或 nftables 模式下,实际请求主要由内核处理,通常不经过 kube-proxy 用户态进程逐个转发。
kube-proxy 的工作模式
Userspace
早期的 userspace 模式会为 Service 创建监听端口。发往 ClusterIP 的请求先由 iptables 重定向到 kube-proxy,再由它选择后端并转发。此时 kube-proxy 本身承担四层代理,每条连接都增加了用户态处理和数据拷贝开销。
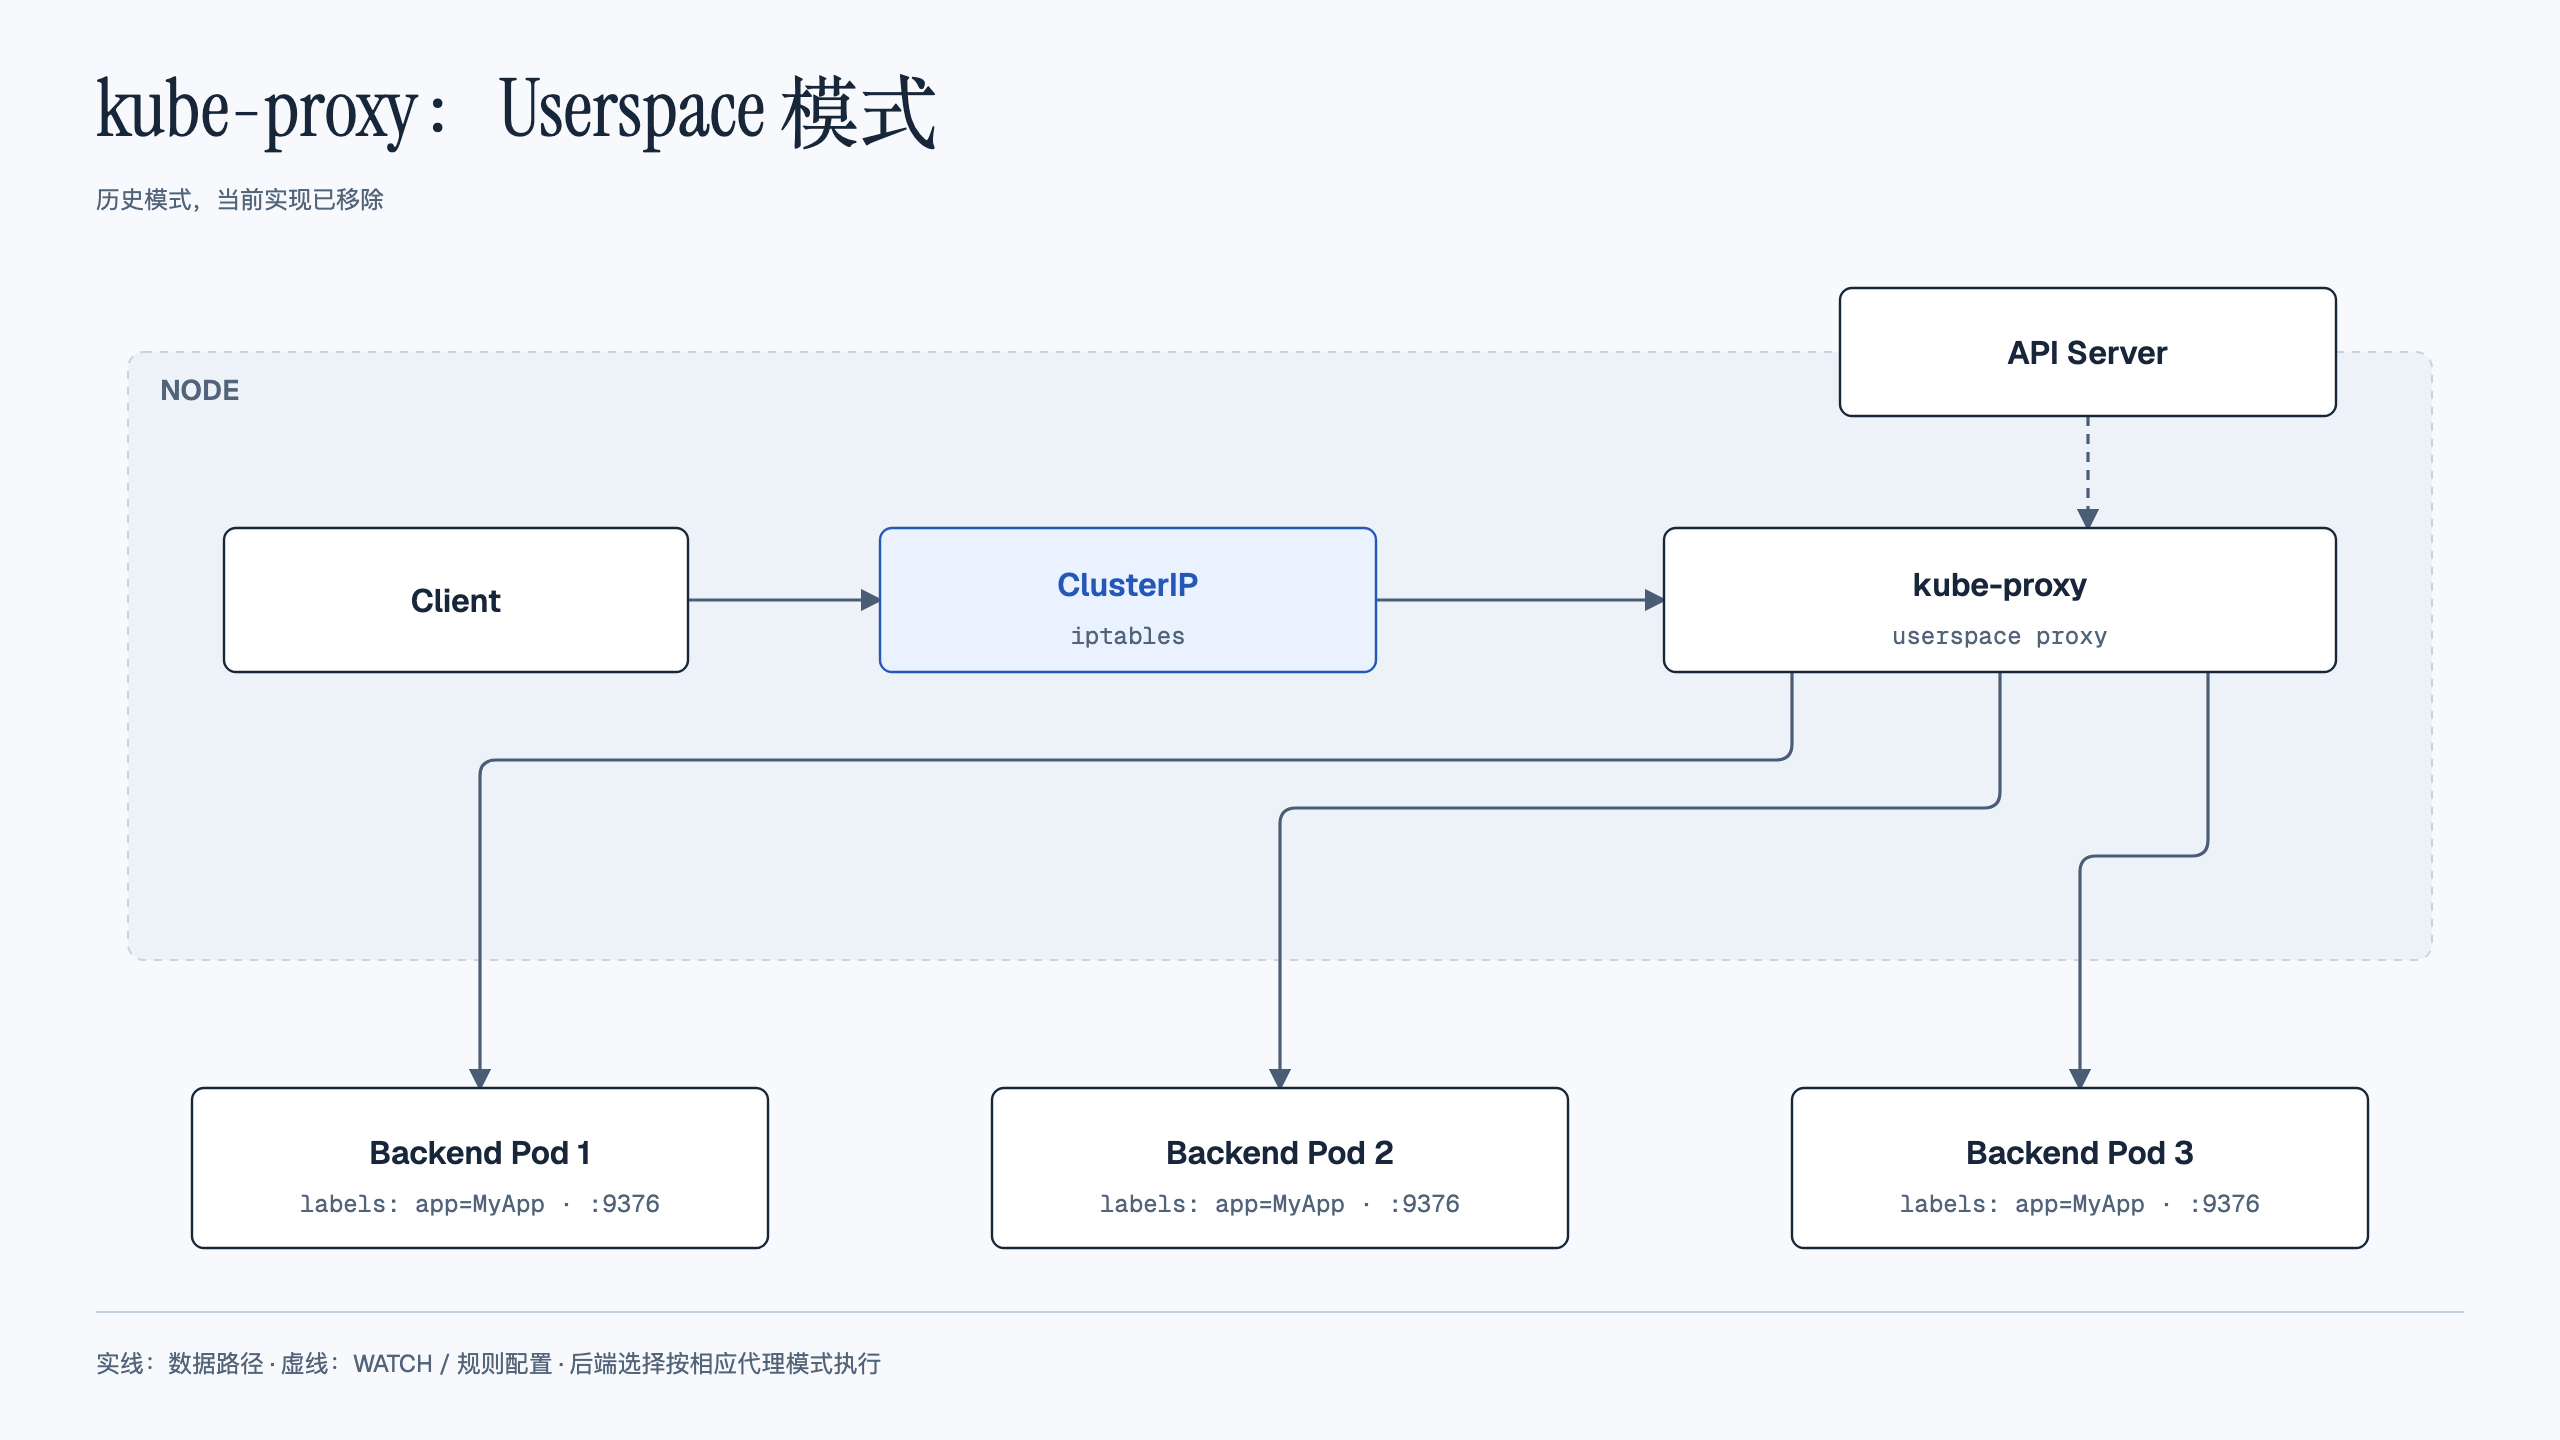
这一模式已退出当前 Kubernetes 的实现,了解它有助于看懂旧架构图。
iptables
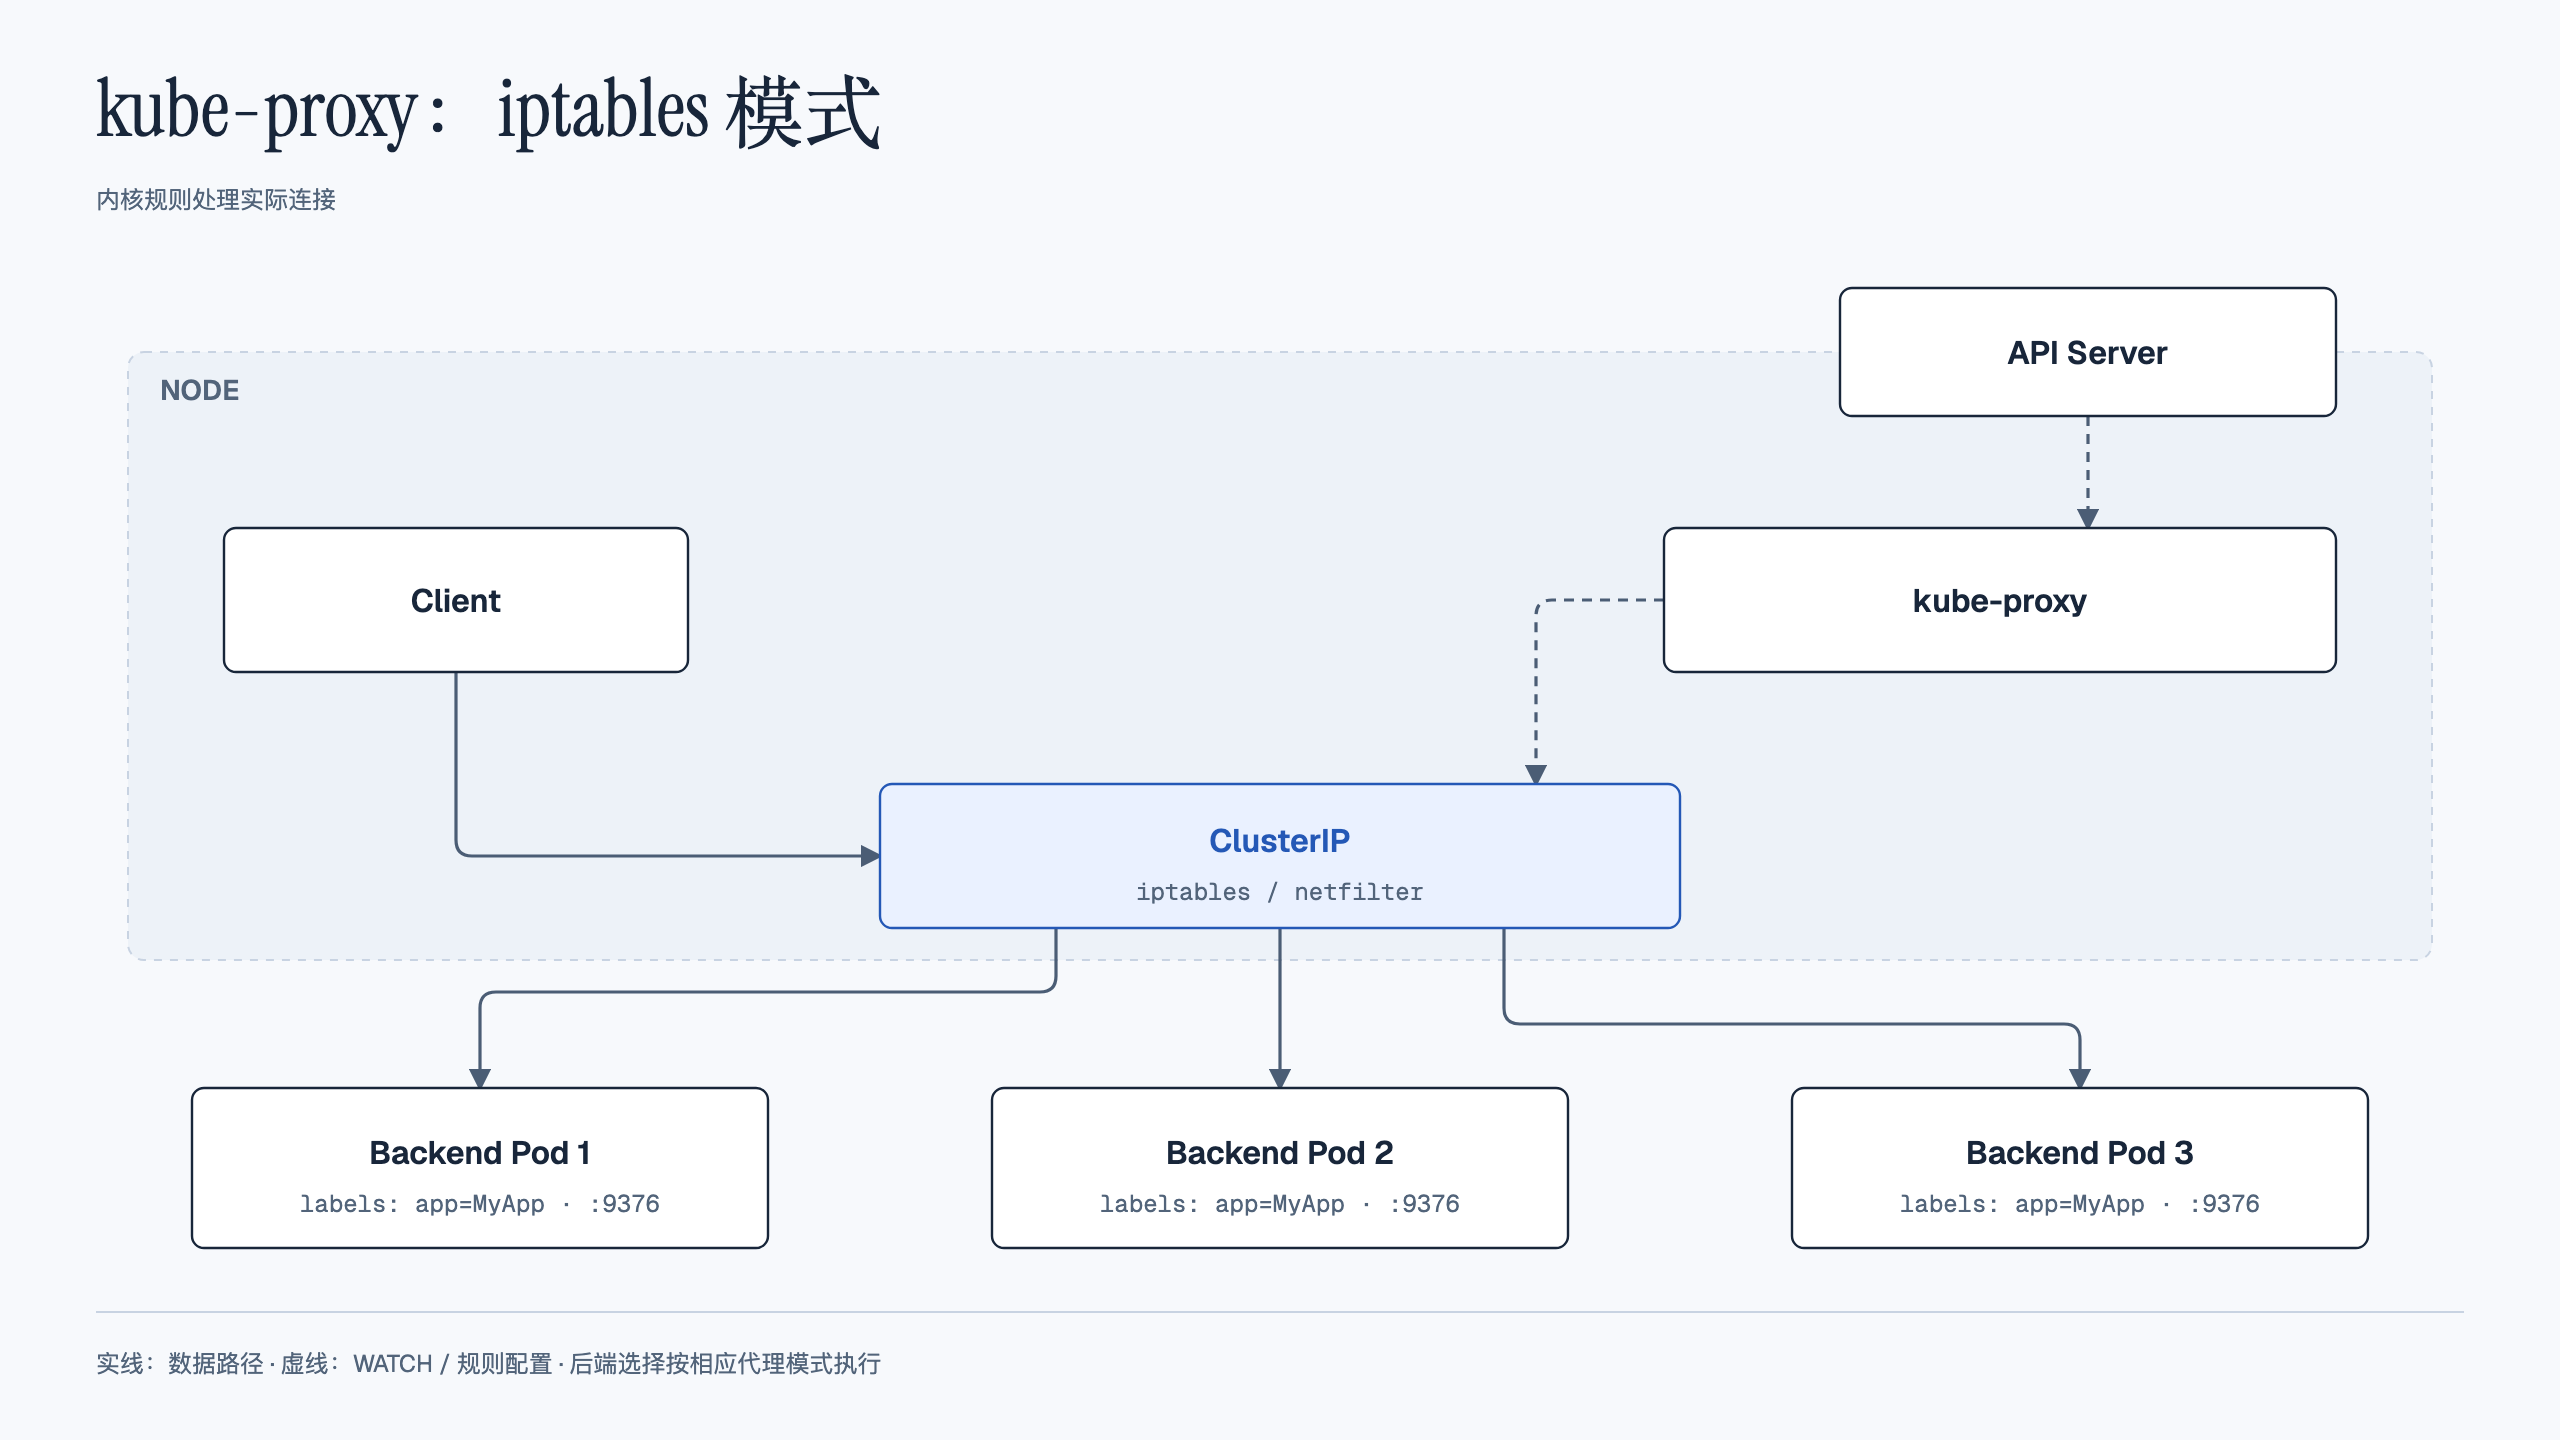
iptables 是配置 Linux netfilter 规则的工具,支持数据包过滤和地址转换。在 iptables 代理模式下,kube-proxy 观察 Service 和 EndpointSlice 的变化,并更新节点规则;后续流量由内核处理。
每个 Service 及其后端对应一组规则。新连接匹配 Service 规则后,会被转换到某个 Pod 地址,后续报文沿用连接跟踪记录,无需 kube-proxy 进程逐个代理。
工作流程:
- 当 Service 被创建或更新时, kube-proxy 会读取 Service 和 EndpointSlice 对象的信息,并生成相应的 iptables 规则
- 这些 iptables 规则配置到内核的 netfilter 处理链中,匹配并转发目标为 Service IP 地址的流量
- 当客户端访问 Service 的 IP 地址时, iptables 规则通常为新连接随机选择一个可用后端 Pod,连接跟踪维持后续报文的映射
与 userspace 相比,内核转发减少了代理开销,也便于结合节点规则排障。不过,大量 Service 和后端仍会增加规则规模与同步成本。Kubernetes v1.28 起的增量更新已改善规则同步,评估性能时需要结合实际版本和负载。
iptables 不负责应用层失败重试。连接失败、HTTP 错误码与业务重试策略,仍需要客户端或七层代理处理。
现代 Linux 集群还可以使用 nftables 后端。它在 Kubernetes v1.29 引入,并在 v1.33 达到稳定状态;iptables、IPVS 和 nftables 的兼容性与行为差异应对照官方代理模式说明。不要仅根据一段旧版本压测就切换集群数据平面。
IPVS(存量集群)
IPVS(IP Virtual Server)是 Linux 内核中的四层负载均衡机制。kube-proxy 观察 Service 和 EndpointSlice,并据此维护 IPVS 规则。
IPVS 通过哈希表等结构改善了早期大规模 Service 的查找和同步效率,也提供多种连接调度算法。但“超过 4000 个 Service 就一定显著更快”没有普适性,仍取决于内核、版本、后端规模和负载。
与为每个匹配条件组织 iptables 链不同,IPVS 使用专门的连接调度和查找结构。它仍可能借助 iptables 完成源地址转换等功能,不能把切换 IPVS 理解为节点上不再需要任何 iptables 规则。
工作流程:
- 当 Service 被创建或更新时,kube-proxy 会读取 Service 和 EndpointSlice 对象的信息,并配置IPVS 负载均衡策略
- IPVS 负载均衡器会根据配置的调度算法(如轮询、最少连接等)将请求转发到后端的一个或多个 Pod 上
- 当客户端访问 Service 的 IP 地址时,请求会直接被 IPVS 处理并转发到后端 Pod
IPVS 的多种调度算法便于适配不同连接分布,但其实现与 Kubernetes Service 语义之间也存在差异。性能、规则同步和行为兼容性需要一起评估。
IPVS 算法用于选择连接后端,排查存量集群时常见以下名称:
| 算法 | 含义与边界 |
|---|---|
rr | 轮询,默认算法;不感知应用 CPU、内存或请求耗时 |
lc | 最少连接,优先选择活动连接较少的后端;连接少不一定代表业务负载低 |
sh | 源地址哈希,相同源地址倾向选择同一后端;不能替代应用会话设计 |
dh | 目的地址哈希,根据目标地址选择后端 |
nq | 优先选择空闲后端,全部忙时回退到 sed |
sed | 根据连接数和固定权重估算期望延迟,并非测量真实响应时间 |
例如某节点上的 Pod 响应变慢,轮询仍可能继续分配连接;换成 lc 也不能保证解决 CPU 过载,尤其在 HTTP 长连接复用时。应同时检查就绪探针、资源瓶颈、请求分布和连接生命周期,而非统一推荐某个算法。
IPVS 模式从 Kubernetes v1.35 起弃用。新部署或迁移应评估 nftables;旧内核不满足要求时也可考虑已改善的 iptables。下面的 IPVS 配置操作用于存量系统实验,不能视为当前生产默认推荐。
nftables
nftables 通过内核规则选择后端,减少大规模规则同步和查找开销。使用前需要检查节点内核、nft 工具、CNI 与网络策略组件的兼容性。官方文档要求 Linux 内核至少 5.13,并提醒 NodePort 地址、主机防火墙和连接跟踪等行为可能与 iptables 模式不同。它的上线应经过实验验证和迁移计划。
负载分发策略
默认情况下,由数据平面的算法为新连接选择后端,例如 iptables 模式的随机选择、IPVS 的轮询。若业务需要按客户端地址保持亲和性,可在 Service 的 spec 中配置 sessionAffinity: ClientIP。
ClientIP 亲和性会让相同客户端 IP 的新连接在有效期内倾向于同一个后端;超时或后端变化时仍可能重选。经过 NAT 后,多个真实用户可能共用一个源 IP,因此它不能替代应用登录态或共享会话存储。
更改 Service 代理模式(旧版本实验)
以下操作会影响整个集群的 Service 转发,仅用于支持 IPVS 的实验环境。先备份 ConfigMap、确认内核模块与回滚方法;托管集群应使用平台支持的配置入口。
# 查看当前的代理模式:
curl 127.0.0.1:10249/proxyMode
# 示例返回:iptables
# 更改 proxy 的代理模式为 ipvs:
kubectl edit cm kube-proxy -n kube-system
# mode更改成"ipvs"
# 二进制安装方式配置文件在每个机器上
#重启 kube-proxy 生效(二进制安装方式使用 systemctl restart kube-proxy):
kubectl rollout restart daemonset/kube-proxy -n kube-system
kubectl rollout status daemonset/kube-proxy -n kube-system
# 再次查看代理模式:
curl 127.0.0.1:10249/proxyMode
# 示例返回:ipvs
更改 IPVS 调度算法(旧版本实验)
# 在机器上查看 ipvs 规则:
yum install ipvsadm -y
ipvsadm -ln
输出示例:
IP Virtual Server version 1.2.1 (size=4096)
Prot LocalAddress:Port Scheduler Flags
-> RemoteAddress:Port Forward Weight ActiveConn InActConn
TCP 172.16.32.128:32000 rr
-> 172.16.85.217:8443 Masq 1 0 0
TCP 172.16.32.128:32001 rr
-> 192.168.181.141:80 Masq 1 0 0
确认实验目标后,修改调度算法并再次查看:
# 实验中将代理算法改为最少连接:
kubectl edit cm kube-proxy -n kube-system
# 把ipvs.scheduler字段改成"lc"
# 重启 Proxy:
kubectl rollout restart daemonset/kube-proxy -n kube-system
kubectl rollout status daemonset/kube-proxy -n kube-system
# 查看 ipvs 算法:
ipvsadm -ln
IP Virtual Server version 1.2.1 (size=4096)
Prot LocalAddress:Port Scheduler Flags
-> RemoteAddress:Port Forward Weight ActiveConn InActConn
TCP 172.16.32.128:32000 lc
-> 172.16.85.217:8443 Masq 1 0 0
TCP 172.16.32.128:32001 lc
-> 192.168.181.141:80 Masq 1 0 0完整实验:旧集群从 iptables 切换到 IPVS
这一节演示 kubeadm 与传统 Linux 节点的准备流程,适用于维护仍使用 IPVS 的实验集群。由于该模式自 v1.35 起弃用,新集群应先评估受支持的 nftables 或 iptables 方案。切换会影响节点转发,应在维护窗口内进行,并先验证回退路径。
第一步:选择 kube-proxy 配置
使用 kubeadm 初始化实验集群时,可以在 kubeadm.yaml 多文档配置中定义代理模式:
---
apiVersion: kubeproxy.config.k8s.io/v1alpha1
kind: KubeProxyConfiguration
mode: ipvs
第二步:准备节点工具和内核模块
以下是传统 RPM 系发行版的示例,各节点需检查自身包管理器和可用模块:
#在所有节点上安装以下:
yum install -y ipset ipvsadm
#所有节点加载内核参数
cat << 'EOF' > /etc/sysconfig/modules/ipvs.modules
#!/bin/bash
ipvs_modules=(ip_vs ip_vs_lc ip_vs_wlc ip_vs_rr ip_vs_wrr ip_vs_lblc ip_vs_lblcr ip_vs_dh ip_vs_sh ip_vs_fo ip_vs_nq
ip_vs_sed ip_vs_ftp nf_conntrack)
for kernel_module in ${ipvs_modules[*]}; do
/sbin/modinfo -F filename ${kernel_module} > /dev/null 2>&1
if [ $? -eq 0 ]; then
/sbin/modprobe ${kernel_module}
fi
done
EOF

chmod +x /etc/sysconfig/modules/ipvs.modules
/etc/sysconfig/modules/ipvs.modules
第三步:更新配置并验证转发
已有实验集群通过 ConfigMap 修改模式,并滚动重启 kube-proxy:
kubectl -n kube-system edit cm kube-proxy
#修改mode字段为"ipvs"
# 滚动重启,由 DaemonSet 创建使用新配置的 Pod
kubectl -n kube-system rollout restart daemonset/kube-proxy
kubectl -n kube-system rollout status daemonset/kube-proxy
# 检查日志及 IPVS 规则;不要清空整个节点的 iptables 表
kubectl -n kube-system logs daemonset/kube-proxy --tail=100
ipvsadm -Ln
#修改ipvs模式之后过5-10分钟测试在k8s创建pod是否可以正常访问网络
kubectl run busybox --image busybox:1.28 --restart=Never --rm -it busybox -- sh
不应通过 iptables -F/-X 清空 filter、nat 表来完成切换:这会同时移除与 kube-proxy 无关的主机防火墙、CNI 或安全规则。规则迁移和清理应按目标 Kubernetes 版本及集群发行版支持的流程执行。上面的模块列表也需按实际内核核对,旧系统中的 nf_conntrack_ipv4 在新内核通常已由 nf_conntrack 替代。
验证时至少覆盖同节点和跨节点 Pod、ClusterIP、DNS、NodePort,以及使用中的出站与外部 LB 路径。若 Service 名称能解析但请求不通,应依次检查 Service 端口和 selector、EndpointSlice 后端与就绪状态、节点转发规则、CNI 路由及网络策略。