Kubernetes 存储入门:从 Volume 到 PV、PVC、CSI 与扩容
容器能够重新启动,数据却未必能够重新生成。用户上传的文件、模型权重、数据库目录和共享文件,各自需要不同的保存时间、访问方式与故障恢复能力。选择存储前,要先回答:数据属于单个容器、一个 Pod、某个节点,还是独立于节点存在?
本文先比较 Pod 内共享目录、本地目录与网络文件系统,再通过 PV/PVC 把应用的存储申请与后端实现分开,最后练习动态供应、StatefulSet 独立卷和容量扩展。各实验是独立方案,镜像、NFS 地址、节点名与 StorageClass 名称均需按实际环境替换;不要把不同案例的地址直接混用。
实验需要一个可用集群与 kubectl。涉及 NFS 时,节点要能访问共享服务器并安装客户端工具;涉及 CSI 时,需要先安装相应驱动。涉及主机与集群变更的命令应在独立实验环境按步骤验证。
哪些数据需要保存
用户文件与业务数据通常不能随 Pod 删除而丢失,模型文件可能适合共享只读或缓存,多个微服务共享的数据则要考虑并发访问。配置可以来自 ConfigMap 或 Secret;日志应按留存要求接入集中采集,不能只依赖一个容器内的文件。
这些数据不一定都使用同一种卷。临时缓存可以随 Pod 销毁,数据库卷需要备份与恢复能力,静态配置还要考虑更新如何传递到应用。
Volume 先解决“目录从哪里来”
Volume 定义在 Pod 的 .spec.volumes 中,再由容器通过 volumeMounts 挂载到各自路径。同一 Pod 的多个容器可以挂载同一 Volume,实现文件共享;卷的数据是否持久,取决于卷类型。
容器崩溃或重启时,Pod 内的卷通常不会因此重建;Pod 被移除时,emptyDir 会清理,本地 hostPath 或外部 NFS 数据则有不同生命周期。不能把“使用 Volume”直接等同于“数据已经持久化”。类型与行为见官方 Volume 说明。
| 层面 | 常见对象或类型 | 解决的问题 |
|---|---|---|
| Pod 卷来源 | emptyDir、hostPath、nfs、persistentVolumeClaim | 容器要挂载什么目录或文件 |
| 持久存储申请 | PV、PVC、StorageClass | 谁提供存储、应用申请多少、如何绑定与回收 |
| 配置投射 | ConfigMap、Secret、Downward API | 把配置或 Pod 信息暴露给容器 |
kubectl explain pods.spec.volumes直接挂载一个 NFS 目录
最直接的方式是在 Pod 中写出服务器与共享路径。下面把共享目录挂到容器的 /cache,适合先观察卷挂载是否成功。服务器必须已经导出该路径,节点也必须具备网络访问和挂载条件:
apiVersion: v1
kind: Pod
metadata:
  name: pod-volume
spec:
  containers:
  - name: container-volume
    image: nginx
    volumeMounts:
    - name: volume-nfs
      mountPath: /cache
  volumes:
  - name: volume-nfs
    nfs:
      server: 192.168.40.180
      path: /data/nfs_pro
emptyDir:生命周期跟随 Pod 的临时目录
emptyDir 在 Pod 分配到节点时创建,初始为空,路径由 kubelet 管理。同一个 Pod 中的容器可以在不同挂载路径读写它,适合临时计算文件、可丢弃缓存,或让 sidecar 与主容器交换文件。容器重启时数据仍在,Pod 从节点移除后数据会被删除。
默认介质来自节点上 kubelet 根目录所在的文件系统,常见是磁盘;也可以显式使用内存。不要把它用作需要跨 Pod 重建保存的唯一数据副本。
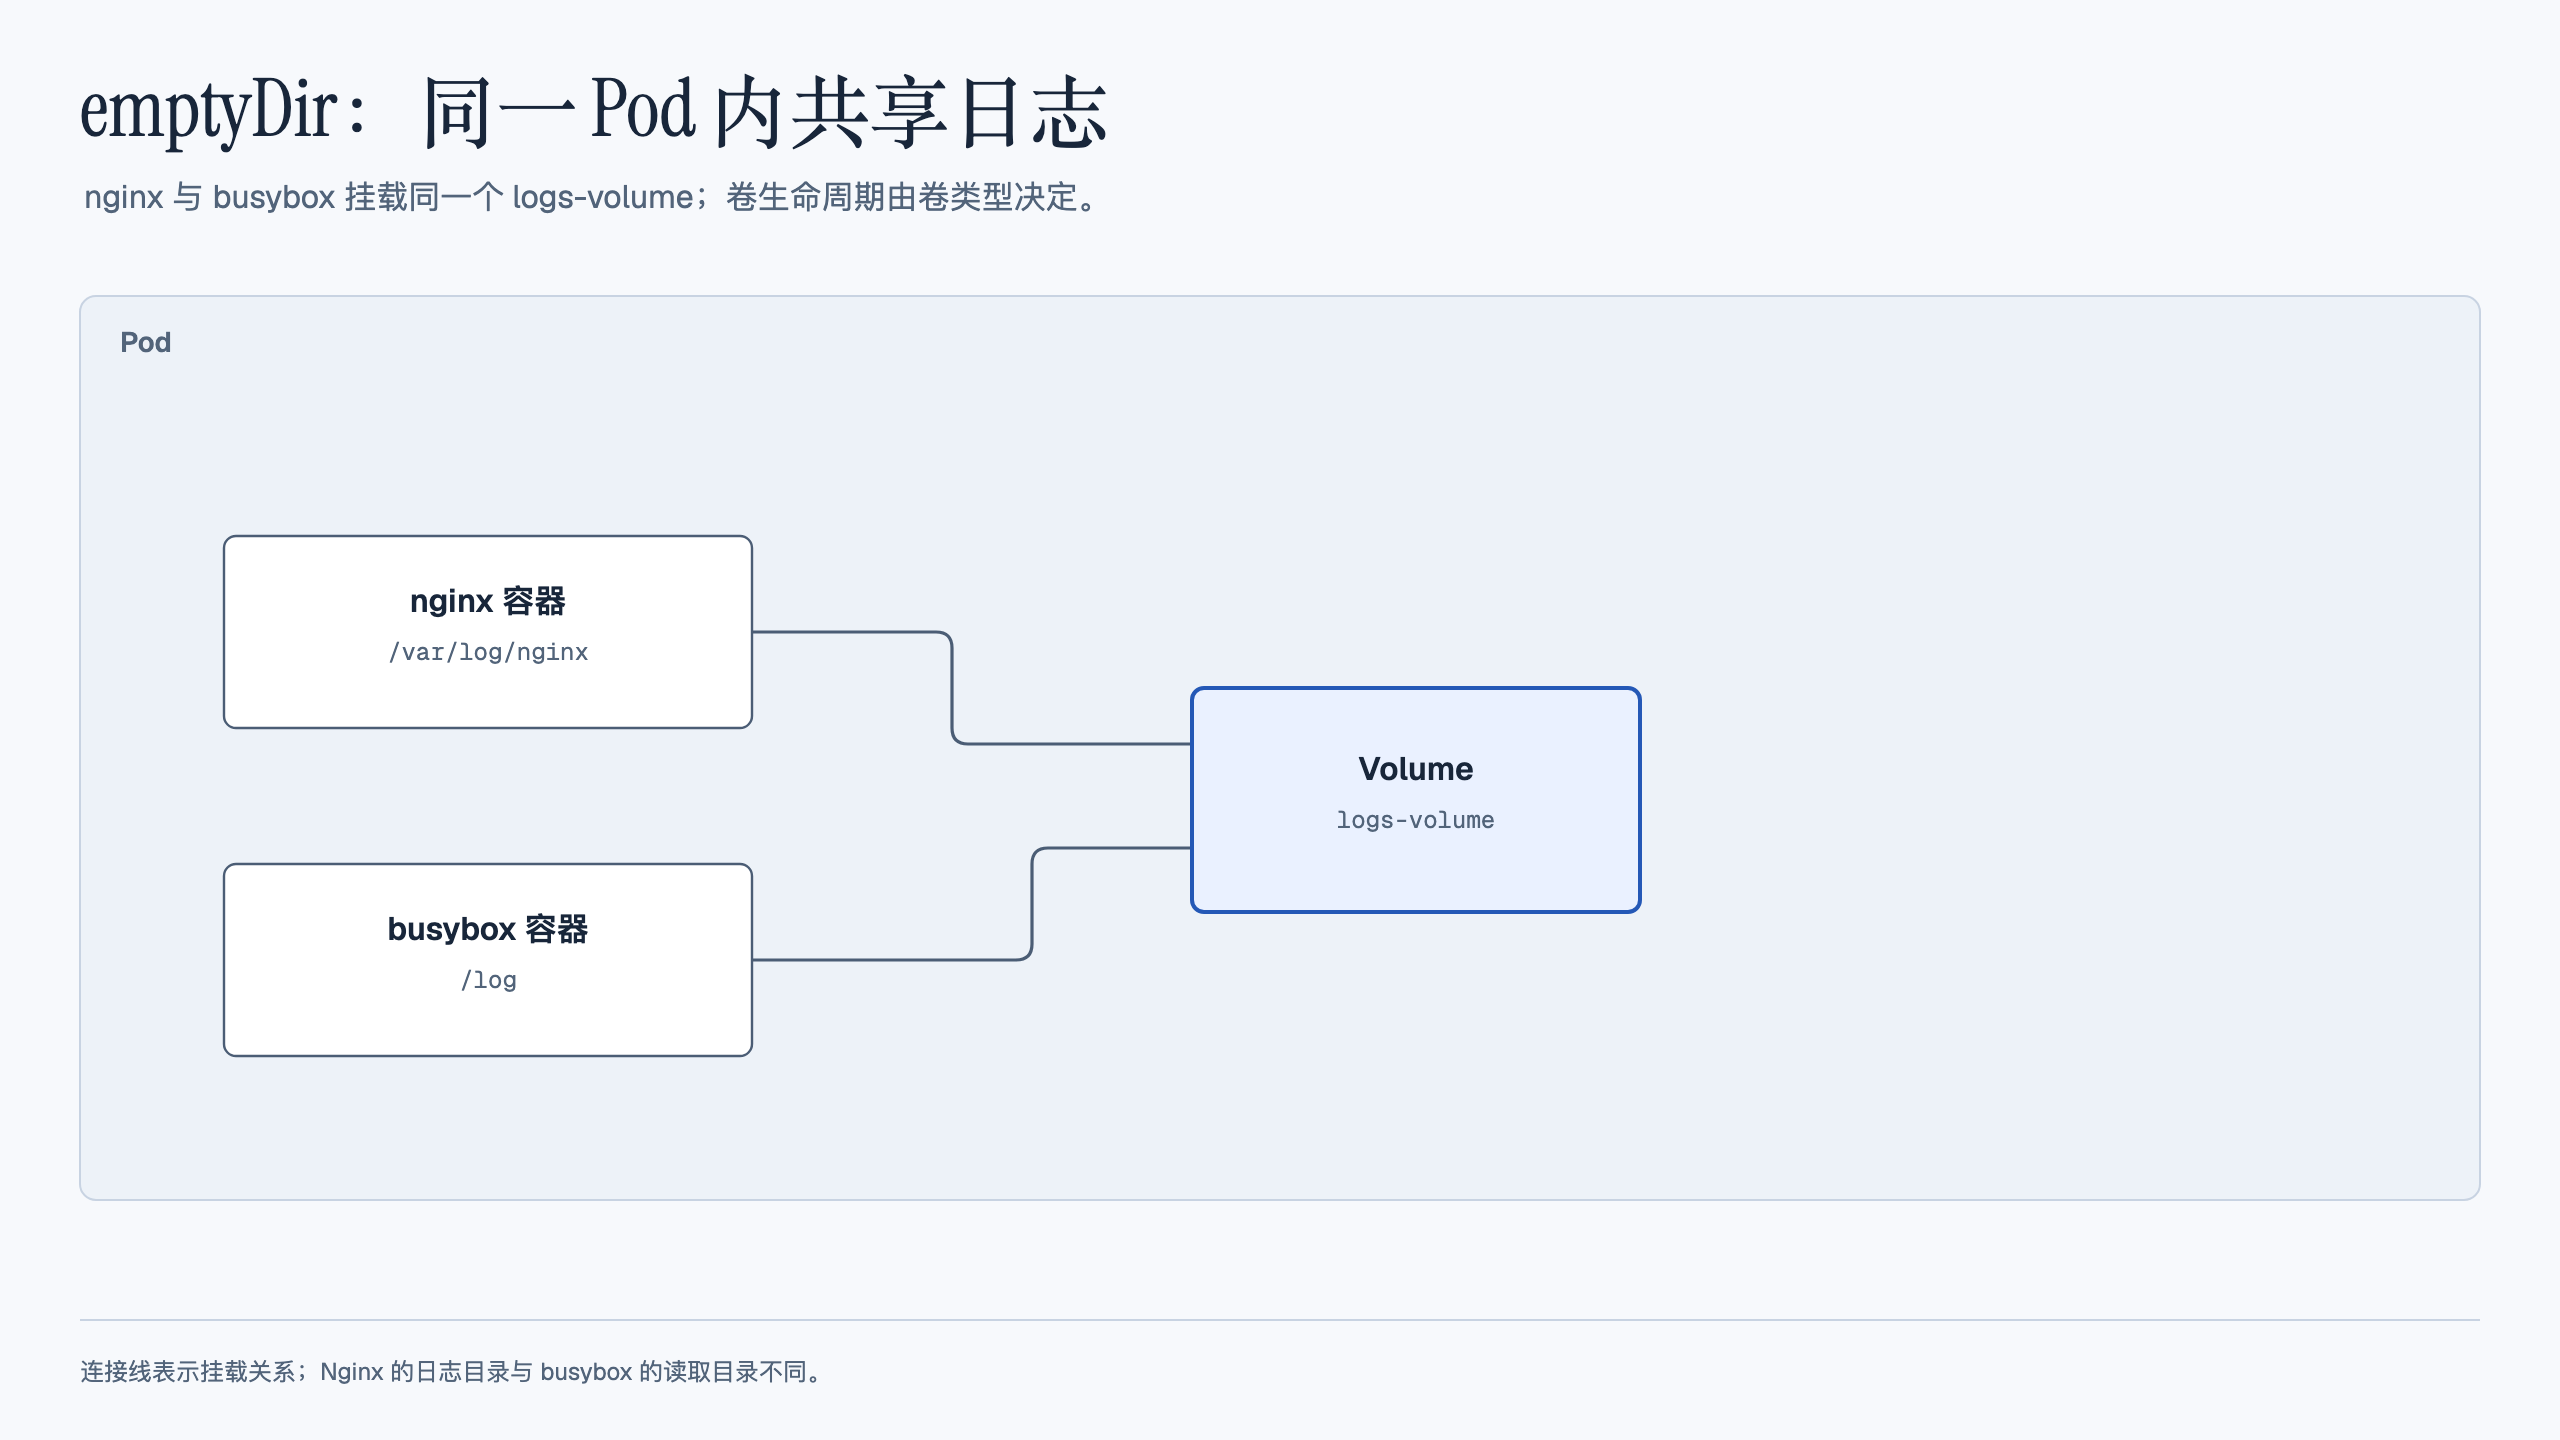
让两个容器共享文件
下面的 Nginx 与 Redis 分别把同一个卷挂到 /opt 和 /mnt。在一边写入文件后,另一边能从自己的挂载路径读取;这只是文件共享,不代表应用数据有一致性或复制协议。示例中的固定旧镜像用于学习挂载结构,实际环境应使用已验证的维护版本。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: emptydir
spec:
  replicas: 1
  selector:
    matchLabels:
      app: emptydir
  template:
    metadata:
      labels:
        app: emptydir
    spec:
      containers:
      - image: nginx:1.15.12
        name: nginx
        volumeMounts:
        - name: share-volume # 挂载了emptyDir volume
          mountPath: /opt
      - image: redis:7.2.5
        name: redis
        volumeMounts:
        - name: share-volume # 挂载了emptyDir volume
          mountPath: /mnt
      volumes: # 这个volume同时给两个容器用
      - name: share-volume
        emptyDir: {}
到节点上观察卷目录
先找到实际 Pod 名称、UID 与所在节点,再登录该节点查看 kubelet 管理目录。下面保留一段历史目录输出,示例 UID 与 volume-cache 名称不等于上面 Deployment 的实时结果;操作时要替换为当前对象的信息。不要手工修改或删除 kubelet 目录中的文件。
# 使用当前实验的实际Pod名称
kubectl get pods -l app=emptydir -o wide
kubectl get pod <pod-name> -o jsonpath='{.metadata.uid}'
#拿到uid,去宿主机上看挂载路径:
tree /var/lib/kubelet/pods/e948ebb2-50f2-4884-a16c-2c0dd7b3f1de

/var/lib/kubelet/pods/e948ebb2-50f2-4884-a16c-2c0dd7b3f1de
├── containers
│   └── container-emptydir
│       └── a247ebdd
├── etc-hosts
├── plugins
│   └── kubernetes.io~empty-dir
│       ├── volume-cache
│       │   └── ready
│       └── wrapped_kube-api-access-kdqtk
│           └── ready
└── volumes
    ├── kubernetes.io~empty-dir
    │   └── volume-cache # 这就是pod emptydir的挂载路径
    └── kubernetes.io~projected
        └── kube-api-access-kdqtk
            ├── ca.crt -> ..data/ca.crt
            ├── namespace -> ..data/namespace
            └── token -> ..data/token

cd /var/lib/kubelet/pods/e948ebb2-50f2-4884-a16c-2c0dd7b3f1de/volumes/kubernetes.io~empty-dir/volume-cache
用 tmpfs 保存临时文件
把 emptyDir.medium 设为 Memory,Kubernetes 会挂载 tmpfs。它适合需要内存文件系统的临时数据,但写入的数据计入写入容器的内存使用,仍可能触发内存限制;配置一个很大的 sizeLimit 并不会提前分配这么多内存,也不会绕过容器内存限制。下面是 Pod 模板片段:
# 使用内存作为EmptyDir,只需要把medium改为Memory即可:
    spec:
      containers:
      - image: nginx:1.15.12
        name: nginx
        volumeMounts:
        - mountPath: /opt
          name: share-volume
      volumes:
      - name: share-volume
        emptyDir:
          medium: Memory
创建Pod,即可在Pod的容器内看到使用tmpfs挂载的/opt目录:
tmpfs tmpfs 3.5G 0 3.5G 0% /opt限制临时目录大小
磁盘与内存型 emptyDir 都可配置 sizeLimit,但生效机制不同。磁盘型属于本地临时存储,kubelet 根据用量与节点压力处理驱逐,通常不是文件系统预先划出一块硬配额;因此 df 不一定显示你声明的大小,也不能依赖超限立即阻止每次写入。内存型还受到 tmpfs 容量、容器内存限制与节点内存的共同约束。
volumes:
- name: share-volume
  emptyDir:
    medium: Memory # 省略该字段则使用默认介质
    sizeLimit: 10Mi
如果 Pod 因临时存储超限被驱逐,通常会出现 Failed/Evicted 状态,不是成功完成任务的 Completed。只有存在 Deployment 等控制器且仍需要副本时,才会创建替代 Pod。将文件日志写入有限的 emptyDir 可以限制占用,但会丢失驱逐后的本地日志,仍需日志轮转与采集,不能把驱逐当作日常日志清理机制。资源行为见本地临时存储管理。
hostPath
hostPath 把宿主机目录、文件或设备挂到容器中。Pod 删除后,该路径的数据通常仍存在,但新 Pod 调度到其他节点时,看到的是另一台机器的同名路径。它适合确实需要节点文件的代理或受控实验,不能提供跨节点的数据恢复。
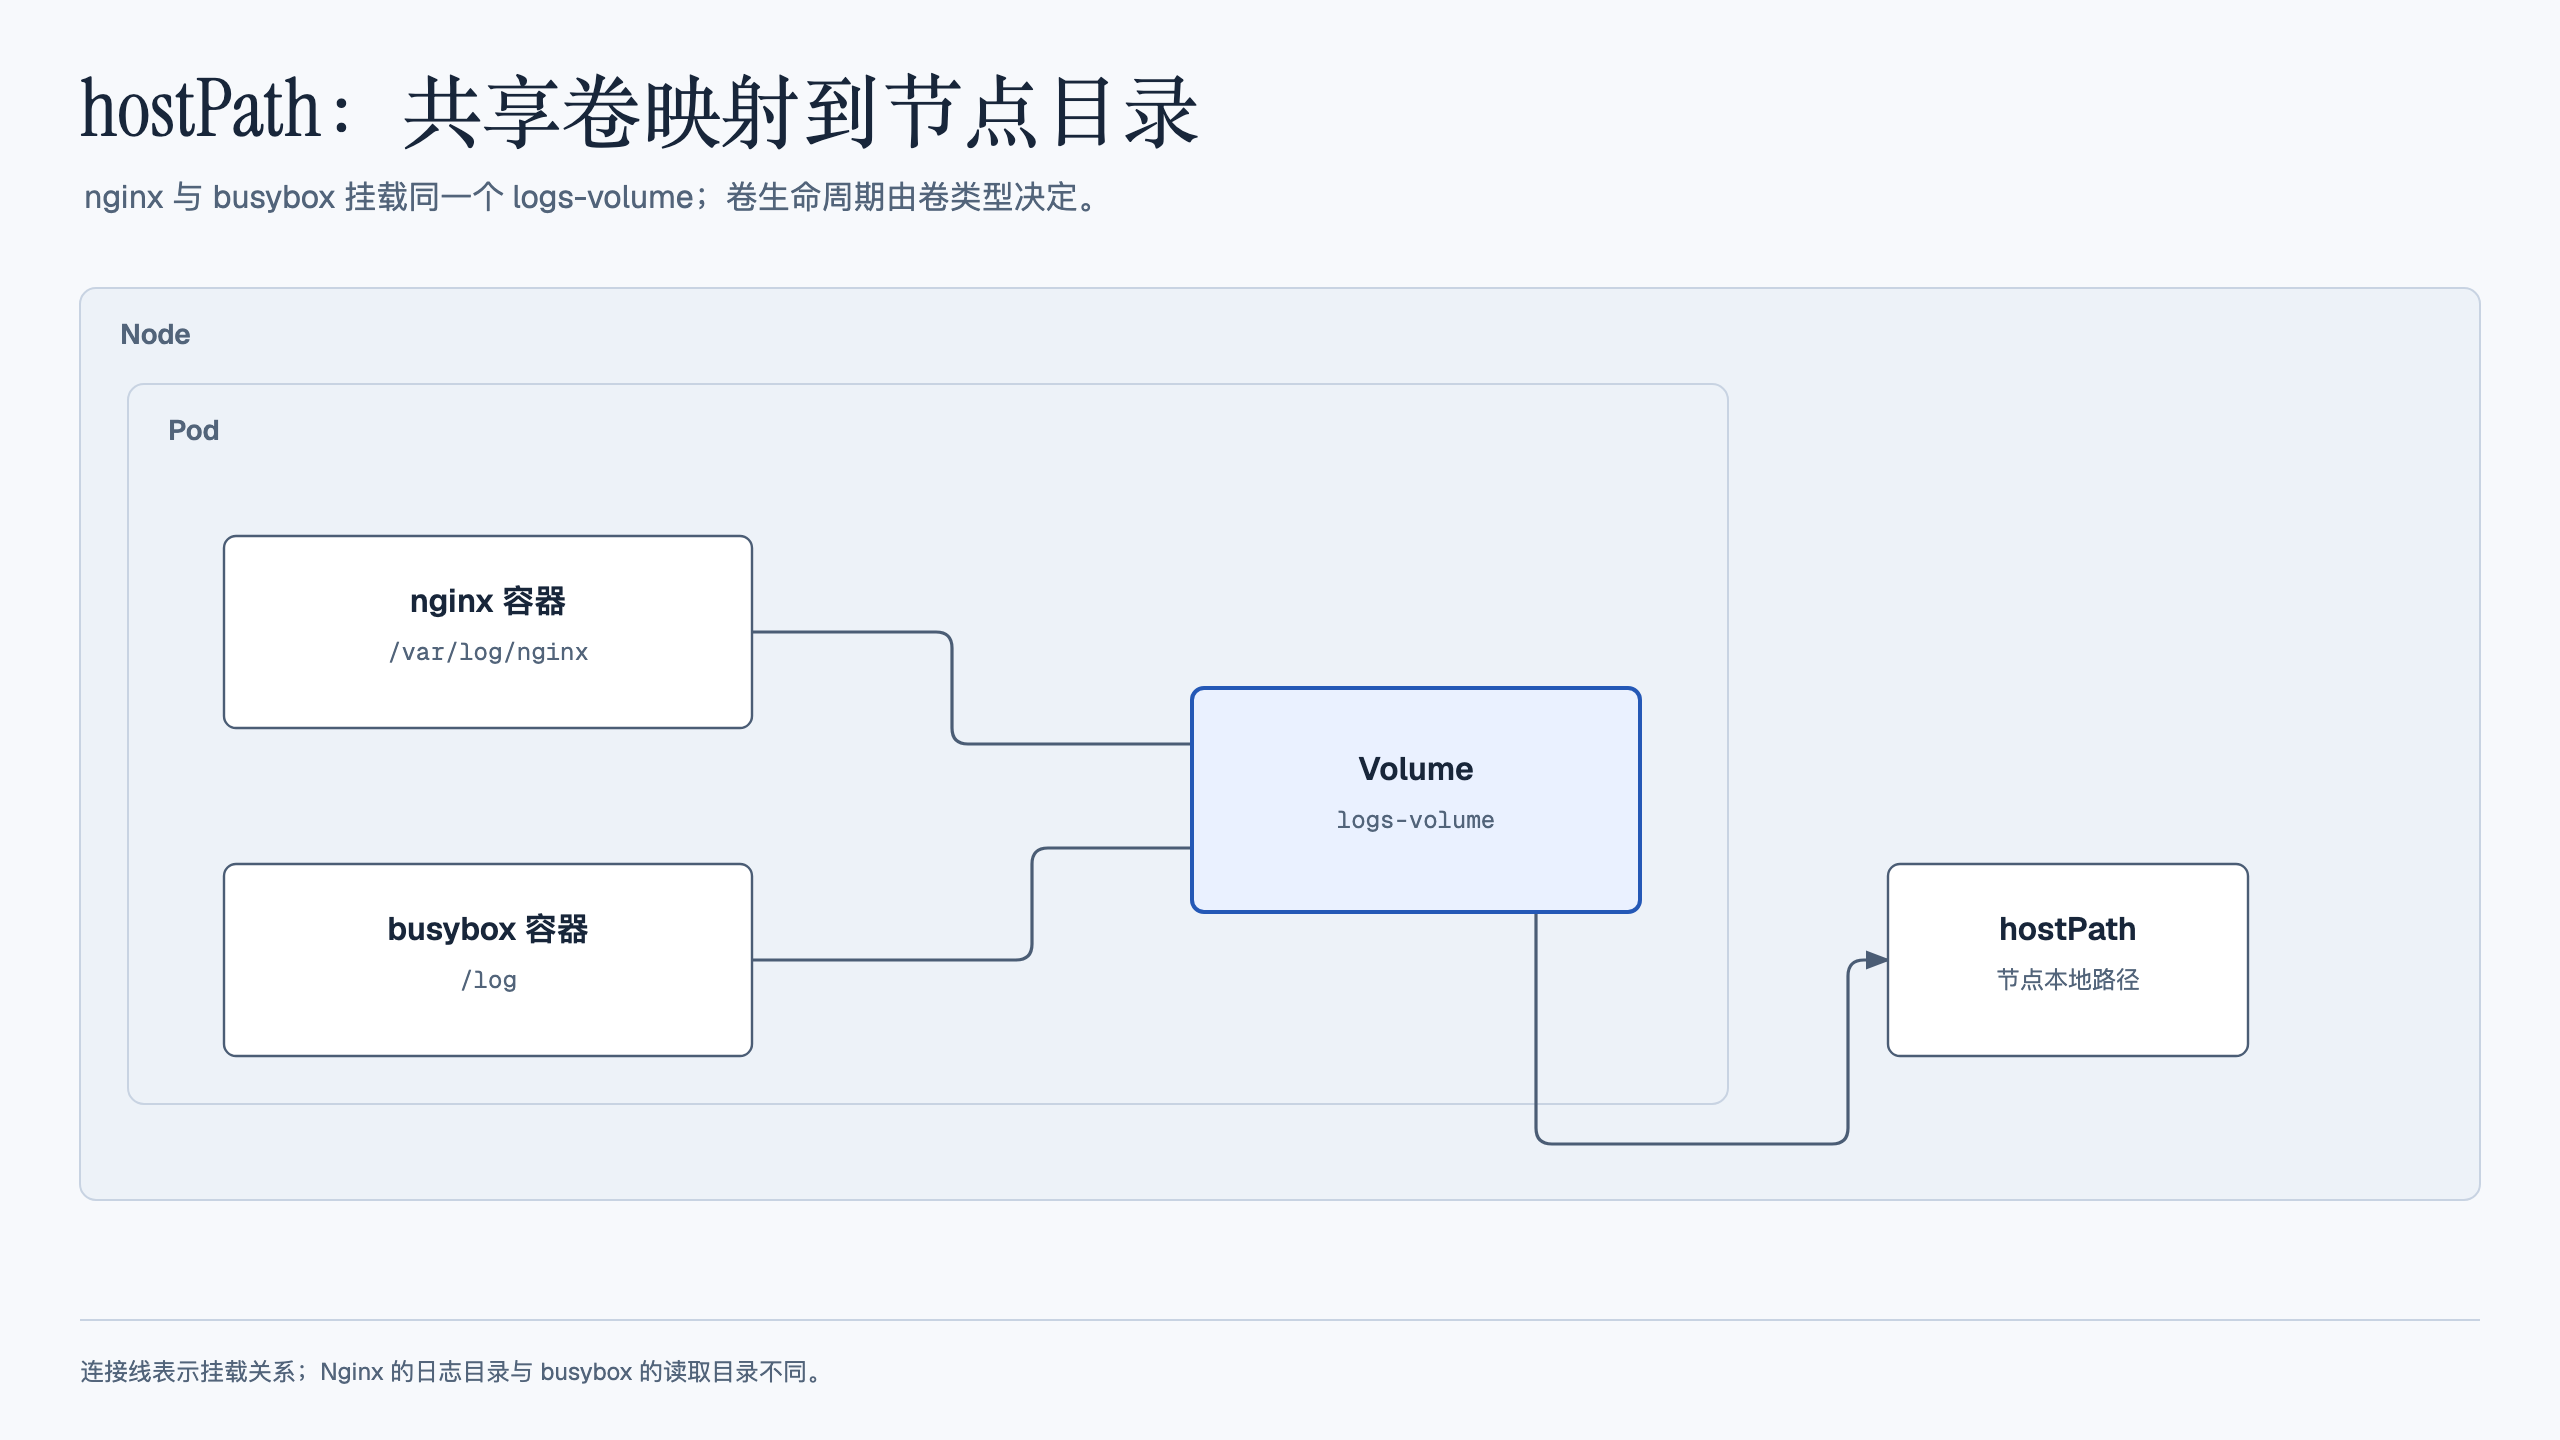
apiVersion: v1
kind: Pod
metadata:
  name: pod-hostpath
spec:
  containers:
  - name: nginx-hostpath
    image: nginx
    volumeMounts:
    - name: volume-cache
      mountPath: /test-nginx
  - name: tomcat-hostpath
    image: tomcat
    volumeMounts:
    - name: volume-cache
      mountPath: /test-tomcat # 容器内目录,可以是不存在的,会自动创建
  volumes:
  - name: volume-cache
    hostPath:
      path: /data # 宿主机目录
      type: DirectoryOrCreate # type的定义:https://kubernetes.io/docs/concepts/storage/volumes/#hostpath
hostPath.type 决定挂载前检查什么:
| 类型 | 要求或创建行为 |
|---|---|
| 空字符串 | 默认不做类型检查 |
DirectoryOrCreate | 缺失时创建目录,通常权限 0755、属主属组跟随 kubelet |
Directory | 目标目录必须已存在 |
File | 目标普通文件必须已存在 |
FileOrCreate | 缺失时创建空文件,通常权限 0644;父目录必须先存在 |
Socket | 目标必须是已存在的 UNIX socket |
CharDevice / BlockDevice | 目标必须是相应设备,仅适用于 Linux |
空 type 不会自动把不存在的文件路径变成普通文件。挂载前应检查目标类型与权限,避免目录、文件用错。hostPath 还可能让容器接触节点敏感文件与运行时 socket,应只开放确实需要的路径,能只读时设置 readOnly: true。需要将节点存储作为应用持久卷使用时,可以评估具有节点亲和性约束的 local PV,边界见hostPath 说明。
local PV:把本地存储与节点绑定
local PV 把本地设备或目录包装成 PV,并通过 nodeAffinity 声明数据在哪个节点。调度器能够把 Pod 的约束与卷所在节点一起考虑,但节点磁盘失效后,它不会自动把数据复制到其他节点。
先创建 StorageClass,使用 kubernetes.io/no-provisioner 表示这里不由通用动态供应器创建卷。WaitForFirstConsumer 在有消费该 PVC 的 Pod 后,结合调度约束选择并绑定卷,而不是等到 Pod 已经运行才绑定。官方local 卷说明介绍了这种配合方式。
#创建local存储类
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: local-storage
provisioner: kubernetes.io/no-provisioner #不需要自动创建PV
volumeBindingMode: WaitForFirstConsumer # 等待消费者并结合调度条件绑定
reclaimPolicy: Retain # 静态PV自身仍应明确设置回收策略
接着创建本地 PV。目录或设备需要先在目标节点准备好,下面的节点名称必须与实际 kubernetes.io/hostname 标签一致:
#创建local类型的PV
apiVersion: v1
kind: PersistentVolume
metadata:
  name: local-storage-pv
  labels:
    app: local-storage-pv
spec:
  capacity:
    storage: 1Gi
  accessModes:
  - ReadWriteOnce
  persistentVolumeReclaimPolicy: Retain
  # PV与PVC使用相同storageClassName,绑定还需满足容量、模式等条件
  storageClassName: local-storage
  #指定的PV对应的本地磁盘的路径
  local:
    path: /var/mnt/nfs
  #并且用nodeAffinity指定这个PV必须运行在某节点上
  nodeAffinity:
    required:
      nodeSelectorTerms:
        - matchExpressions:
            - key: kubernetes.io/hostname
              operator: In
              values:
                - worker1.ocp.example.com
PVC 用同一个 StorageClass,并额外用标签选中目标 PV:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: local-storage-pvc
spec:
  selector:
    matchLabels:
      app: local-storage-pv
  accessModes:
    - ReadWriteOnce
  #这边的storageClassName要与static-pv.yaml匹配,同时selector标签匹配时,才能够与pv进行绑定
  storageClassName: local-storage
  resources:
    requests:
      storage: 1Gi
最后用 Pod 模板引用 PVC。下面保留两个 Grafana 副本的挂载示例,它们会受同一个 local PV 的节点亲和性约束,并非跨节点高可用方案;示例仅挂载 /mnt/local,也没有把 Grafana 的默认数据库目录迁入这个卷。需要保存应用状态时,还要配置应用实际使用的数据路径和并发访问方式。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: grafana-deployment
spec:
  replicas: 2
  selector:
    matchLabels:
      app: grafana
  template:
    metadata:
      labels:
        app: grafana
    spec:
      volumes:
      - name: local-storage-volume
        persistentVolumeClaim:
    #与static-pvc.yaml中metadata-name名称一致,表示pod调用该pvc
          claimName: local-storage-pvc
      containers:
      - name: grafana-container
        image: quay.ocp.example.com/ocp4/custom/grafana:8.2.0
        resources:
          requests:
            memory: "64Mi"
            cpu: "250m"
          limits:
            memory: "128Mi"
            cpu: "500m"
        volumeMounts:
          - mountPath: /mnt/local
name: local-storage-volume如果本地路径较多,可以用项目维护的local static provisioner发现和管理 PV。它不是通用的远端磁盘动态供应器,也不会让本地数据具备自动复制能力。
NFS/NAS:让多个节点访问同一文件系统
如果 Pod 需要在不同节点访问同一批文件,可以使用 NFS 等网络文件系统。NAS 是网络附加存储的类别,NFS 是一种访问协议;云 NAS 可能提供 NFS 或 SMB/CIFS 等接口,不能把两者完全等同。
下面先准备一台 NFS 服务器,再让节点挂载、最后让 Pod 挂载。Pod 迁到其他节点时,只要网络、权限与服务端可用,就能访问同一个共享目录;服务端本身仍需要高可用与备份设计。
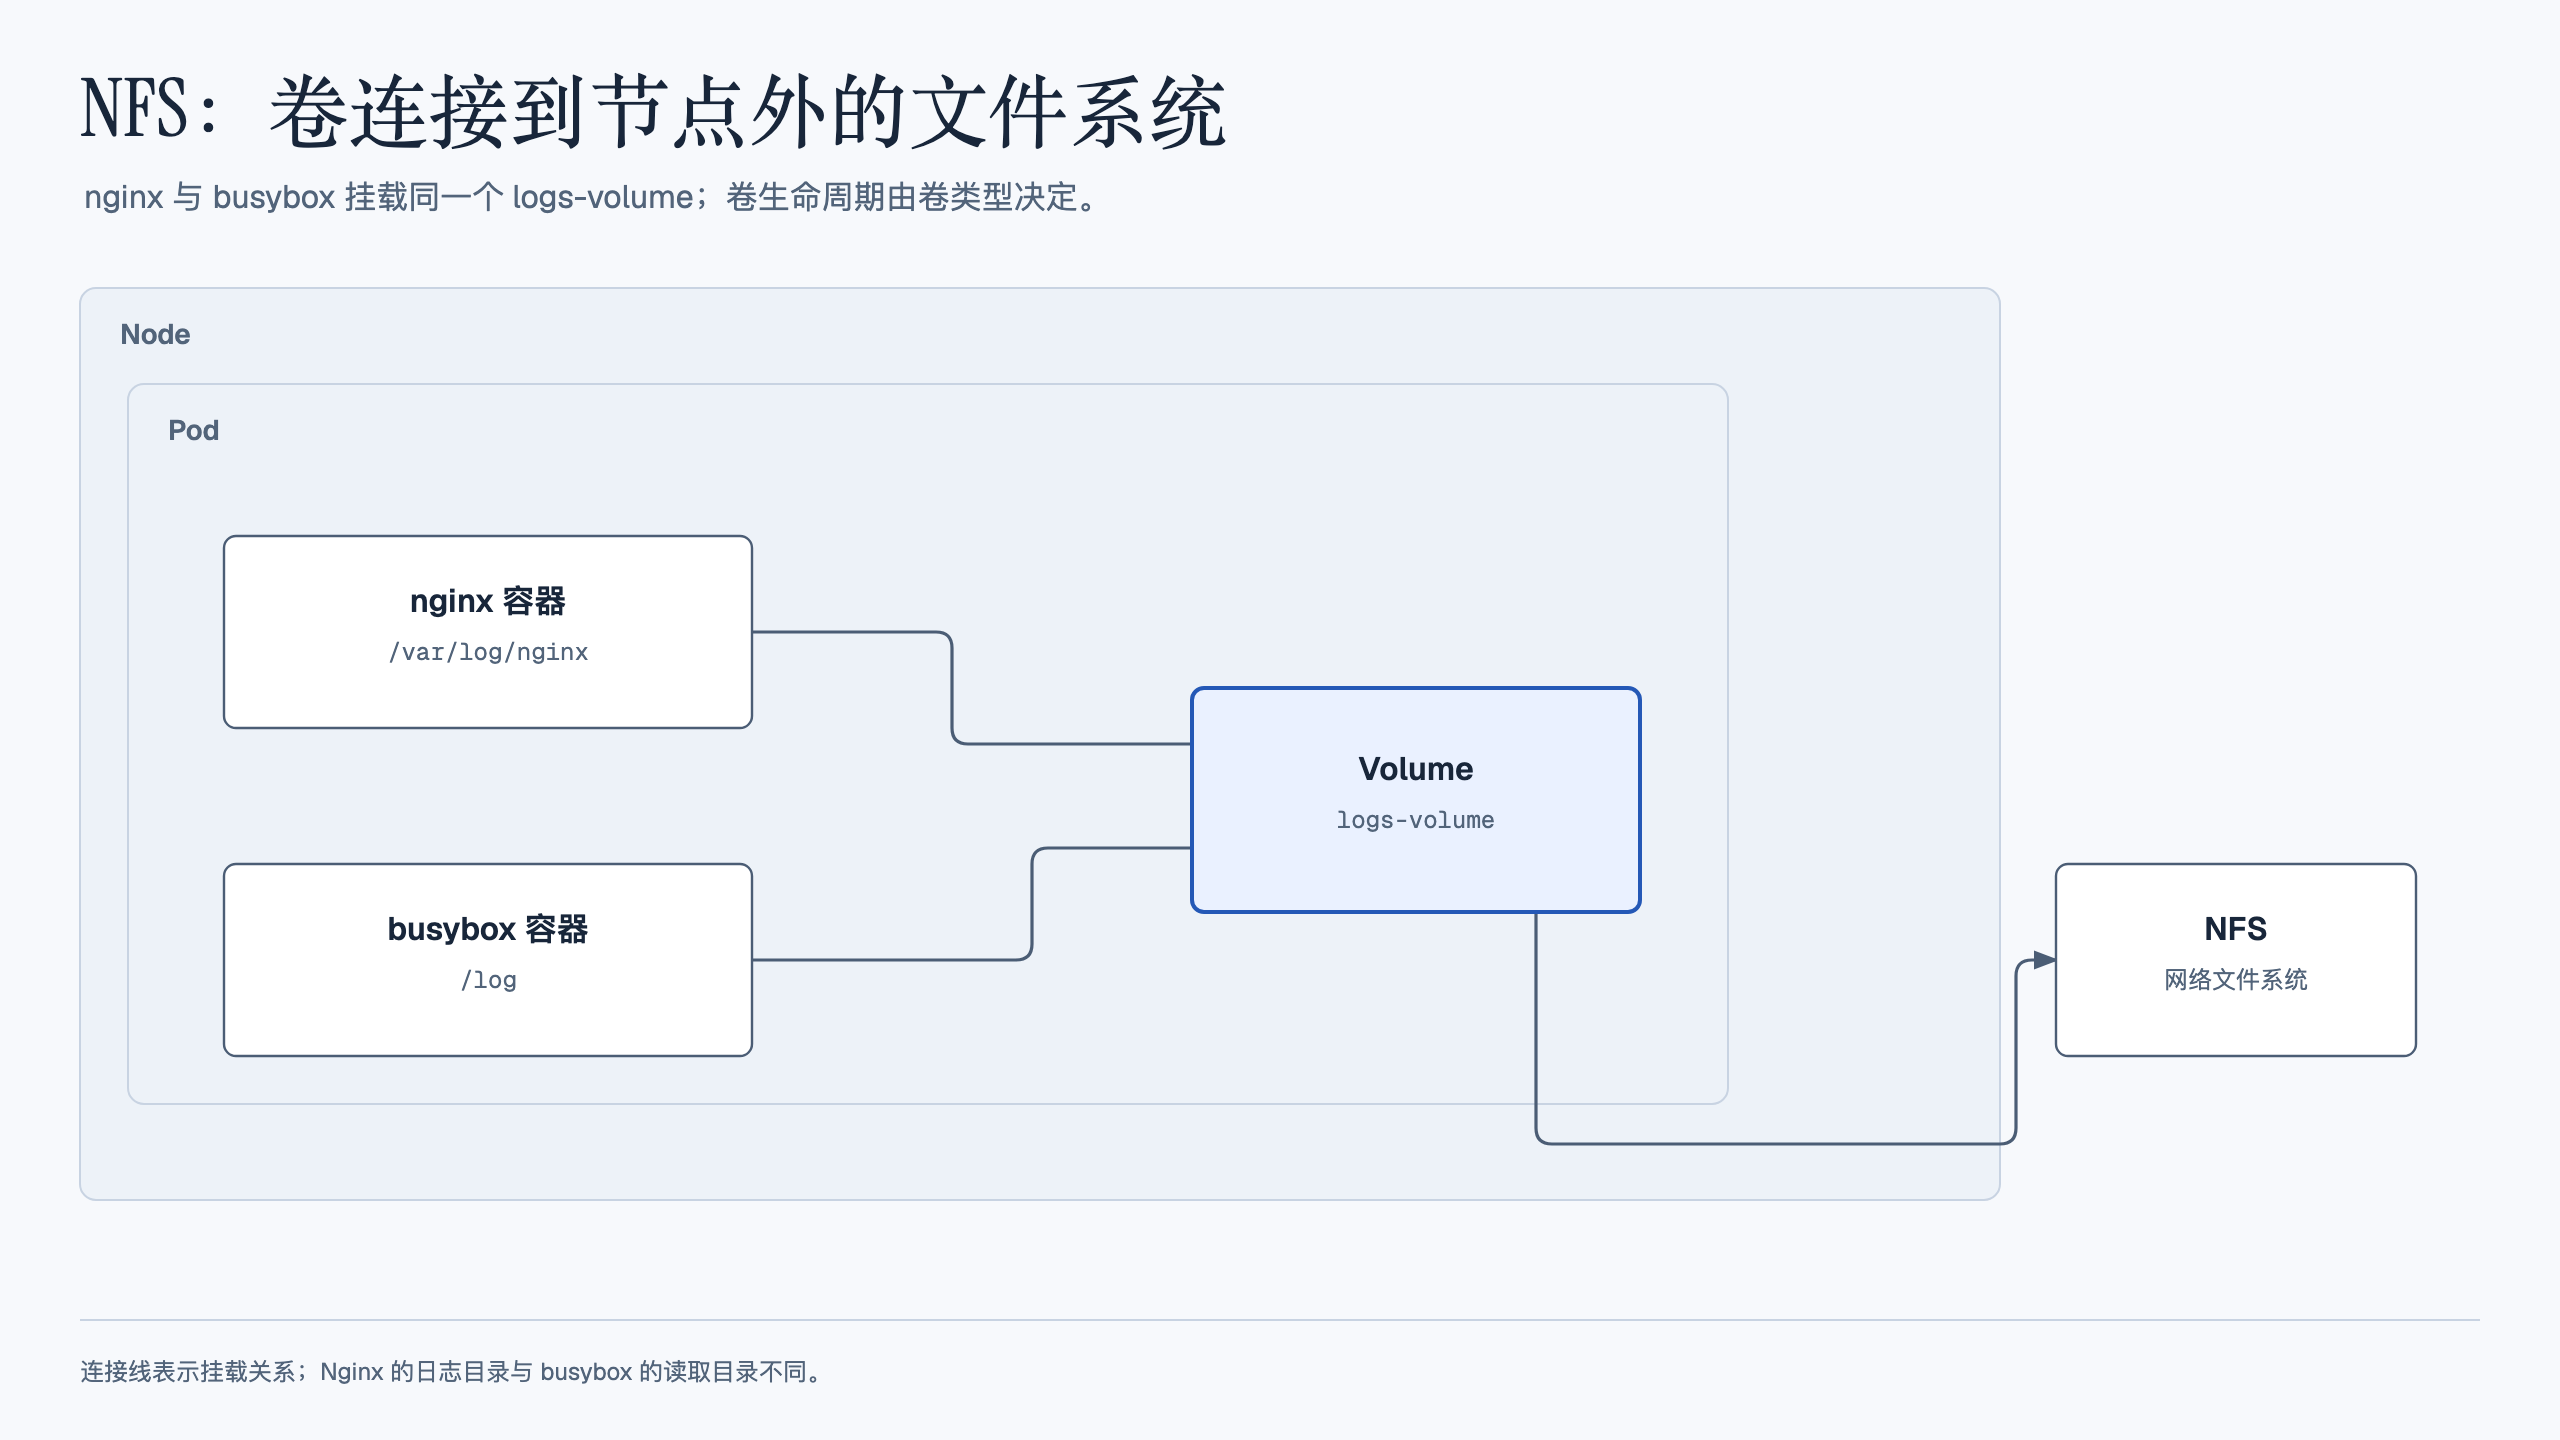
先理解 UID、GID 与导出权限
在常见的 AUTH_SYS(也称 AUTH_UNIX)模式下,客户端通过 RPC 传递数字 UID/GID,服务端按文件权限判断访问。两边的用户名称相同不代表数字 ID 一定相同,反过来也一样。NFS 还支持其他安全机制,严格身份认证不能只依赖客户端自报 UID。
| 导出选项 | 行为 |
|---|---|
root_squash | 默认把客户端 UID/GID 0 映射为匿名身份 |
no_root_squash | 关闭 root 映射,客户端 root 可能以服务端 root 身份操作共享目录 |
all_squash | 把所有 UID/GID 映射为匿名身份 |
no_all_squash | 默认不把所有用户统一映射,不表示“找不到同名用户就自动映射” |
anonuid / anongid | 指定匿名 UID/GID;默认通常为 65534,用户名依发行版而定 |
选项含义见 Linux NFS 的exports 手册。下面的 no_root_squash 用于受控教学环境;共享目录应限制到实际节点网段,生产需按账号、目录与网络边界重新设计权限。
在 NFS 服务器准备共享目录
CentOS/Rocky 与 Ubuntu 的软件包和服务名不同,选择对应命令即可。下面的 /etc/exports 行是配置内容,不是 shell 命令:
# 安装nfs服务端
# centos\rocky
yum install nfs-utils -y
# ubuntu
apt install nfs-kernel-server -y

# 创建共享目录,实际使用中建议对不同用途的nfs目录分别创建子目录分开挂载,便于管理。
mkdir /data/volumes -pv

# 启动nfs服务
# centos\rockylinux中
sudo systemctl enable --now rpcbind nfs-server
# ubuntu中
systemctl enable --now nfs-kernel-server

# 配置nfs服务端export
vim /etc/exports
/data/volumes 192.168.40.0/24(rw,sync,no_subtree_check,no_root_squash)
# rw 该主机对该共享目录有读写权限
# no_root_squash 登入 NFS 主机使用分享目录的使用者,如果是 root 的话,那么对于这个分享的目录来说,他就具有 root 的权限。根用户在 NFS 客户端上拥有和服务器上相同的权限。

# 加载NFS配置生效
exportfs -arv
在工作节点先测试挂载
节点需要 NFS 客户端工具,kubelet 才能完成对应挂载。即使不做手工测试,也要准备这些依赖。缺少工具时,常见事件包含下面的信息:
mount: /var/lib/kubelet/pods/.../volumes/kubernetes.io~nfs/nfs-volume: bad option; for several filesystems (e.g. nfs, cifs) you might need a /sbin/mount. helper program.下面将 192.168.40.4 作为本段 NFS 服务器地址,使用时替换为自己的服务器:
# CentOS、Rocky系列
yum install nfs-utils -y
# Ubuntu系列
apt install nfs-common -y

mkdir /nfs-test
mount -t nfs 192.168.40.4:/data/volumes /nfs-test/
df -Th  | grep nfs-test
# 卸载挂载
umount /nfs-test
再测试 Pod 挂载
apiVersion: apps/v1
kind: Deployment
metadata:
  name: dep-nfs
spec:
  replicas: 1
  selector:
    matchLabels:
      storage: nfs
  template:
    metadata:
      labels:
        storage: nfs
    spec:
      containers:
      - name: test-nfs
        image: nginx
        volumeMounts:
        - name: test-nginx-volume
          mountPath: /usr/share/nginx/html
      volumes:
      - name: test-nginx-volume
        nfs:
          server: 192.168.40.4
          path: /data/volumes
NFS 可以让多个 Pod 挂载同一目录,但并发写入规则需要由应用负责。服务器宕机通常先导致访问中断,并不等于磁盘上的数据必然丢失;数据持久性取决于服务端存储、写入确认、备份与故障类型。CephFS 等分布式文件系统可以提供另一种故障域设计,也需要评估运维成本,不能仅凭“分布式”三个字推定不会丢数据。
Downward API:投射的是 Pod 信息
Downward API 可以通过环境变量或卷文件,把部分 Pod 元数据暴露给容器。环境变量适合启动时读取的名称、命名空间与 status.podIP 等信息;卷文件适合支持文件方式的字段,例如标签与注解。两种方式支持的字段并不完全相同,不能把 Pod IP 当成任意可投射文件的字段。
读取方便与否取决于应用。环境变量通常不会随 Pod 字段变化自动更新;投射文件可以更新,应用还需重新读取。字段边界见Downward API。
用 PV/PVC 分开存储提供者与使用者
直接写 NFS 地址能挂载目录,但每个应用都需要知道服务器、路径与权限,也缺少统一的申请、绑定和回收界面。PV/PVC 把这些职责分开:管理员或供应器提供 PV,应用通过 PVC 申请容量、访问模式和存储类别,再在 Pod 中引用该 PVC。
只读挂载、卷生命周期、独占访问、容量需求与 StatefulSet 各副本独立数据目录,都可以围绕这套 API 配置。但 PVC 声明 10Gi 不等于所有后端都会自动建立 10Gi 硬配额,RWO 也不表示全局只能有一个 Pod 挂载。后面将分别解释这些边界。
PV 是集群范围的存储资源
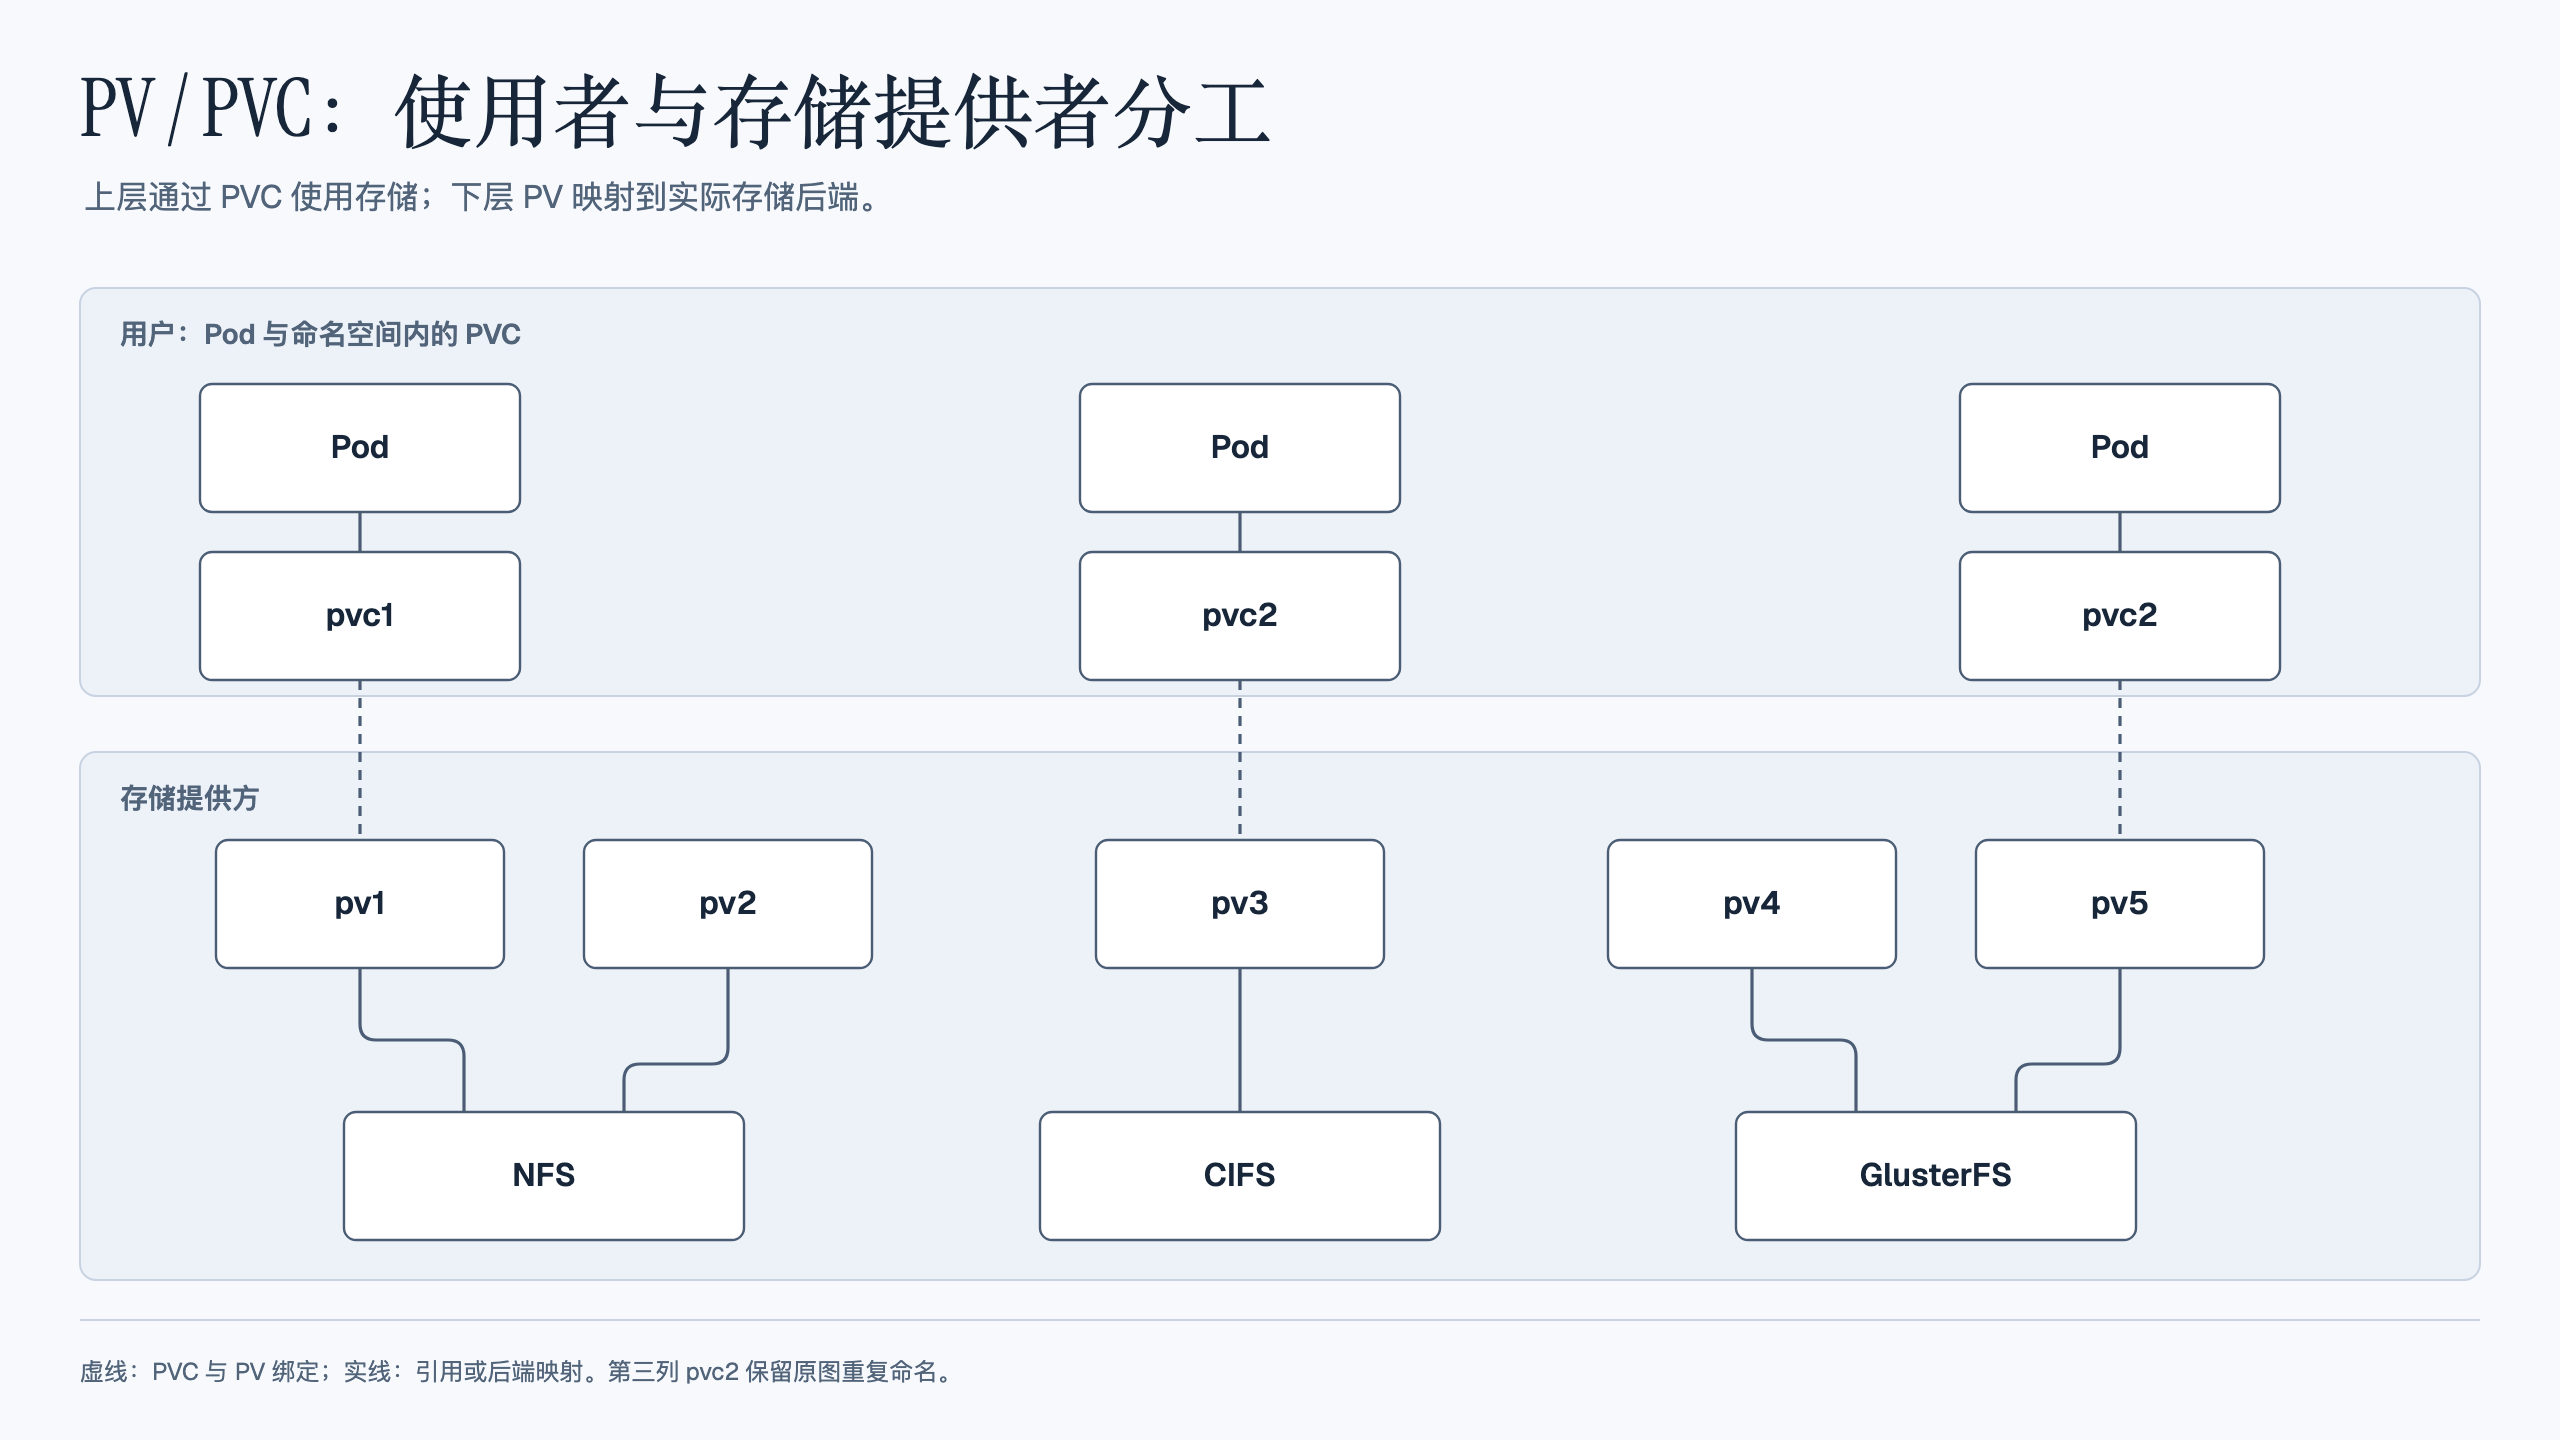
PersistentVolume(PV)描述一份存储及其能力,可以是本地卷、共享文件系统或块存储。PV 的生命周期独立于单个 Pod。它是集群范围资源,不属于 Namespace,也不等于“Node 级别资源”;例如一个 NFS PV 可供不同节点访问。
静态供应时,管理员提前创建 PV。动态供应时,PVC 选择 StorageClass,供应器按需准备后端存储与 PV。StorageClass 必须与实际可用的供应器配合,只有名称并不能完成创建。生命周期见持久卷官方说明。
PVC 是命名空间内的存储申请
PersistentVolumeClaim(PVC)请求容量、访问模式、存储类别等条件。它不是底层存储本身,而是与一个 PV 绑定的申请对象。Pod 和被引用的 PVC 必须在同一命名空间;一个 PV 同一时刻只能绑定一个 PVC,但符合访问条件时,多个 Pod 可以引用同一个 PVC。
匹配不只比较 storageClassName,还要比较容量、访问模式、卷模式、选择器以及是否已被占用等条件。没有可用匹配,也没有成功的动态供应时,PVC 会保持 Pending;使用 WaitForFirstConsumer 时,等待消费 Pod 可能是正常状态。
下面保留旧 Ceph RBD in-tree 配置,用于阅读历史集群与理解 PV/PVC 的对应关系。它不能直接作为现代 Kubernetes 的 Ceph 部署方法:旧的 rbd 卷插件已在 Kubernetes 1.31 移除,见官方移除说明,现代集群应部署 Ceph CSI,再按其文档配置。示例中的 accessModes 与 resources 必须采用 API 规定的复数拼写。
---
# PV
apiVersion: v1
kind: PersistentVolume
metadata:
  name: ceph-rbd-pv
spec:
  storageClassName: ceph-fast # 静态匹配时PV/PVC必须使用相同类别,仍需满足其他匹配条件
  accessModes:
  - ReadWriteOnce
  capacity:
    storage: 3Gi
  rbd:
    monitors:
    - 192.168.40.180:6789
    - 192.168.40.181:6789
    - 192.168.40.182:6789
    pool: rbd
    image: ceph-rnd-pv-test
    user: admin
    secretRef:
      name: ceph-secret
    fsType: ext4
    readOnly: false
---
# PVC
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: ceph-rbd-pvc
spec:
  storageClassName: ceph-fast # 需要保证PVC的这个字段和PV一致才能被匹配
  accessModes:
  - ReadWriteOnce # 挂载模式也需要也要匹配,PVC的是PV的子集即可,
  resources:
    requests:
      storage: 3Gi # PVC的申请存储需要<=PV配置的存储大小
Pod 模板只需要引用 PVC 名称,下面是 .spec 中的片段,不是第三份完整对象:
volumes:
- name: data
  persistentVolumeClaim:
    claimName: ceph-rbd-pvc
静态使用流程可以分为三步:先准备实际存储并创建描述它的 PV,再创建满足匹配条件的 PVC,最后在 Pod 中引用 PVC。动态供应则由 StorageClass 与供应器补上准备卷的过程。Pod 创建前无需手工指定最终 PV 名称,但要确认 PVC 能按预期绑定。
静态 PV/PVC 实验
HostPath PV
kind: PersistentVolume
apiVersion: v1
metadata:
  name: task-pv-volume
  labels:
    type: local
spec:
  storageClassName: hostpath
  volumeMode: Filesystem # Filesystem挂载文件系统;Block向容器暴露原始块设备
  capacity:
    storage: 10Gi # 这里声明匹配容量,hostPath/NFS目录不会自动得到硬配额
  accessModes:
  - ReadWriteOnce
  hostPath:
    path: "/mnt/data"
NFS PV
#master-01创建nfs共享目录
mkdir /data/volume_test/v{1,2,3,4,5,6,7,8,9,10} -p
#配置nfs共享宿主机上的/data/volume_test/v1..v10目录
cat /etc/exports
/data/volumes 192.168.40.0/24(rw,no_root_squash)
/data/volume_test/v1 192.168.40.0/24(rw,no_root_squash)
/data/volume_test/v2 192.168.40.0/24(rw,no_root_squash)
/data/volume_test/v3 192.168.40.0/24(rw,no_root_squash)
/data/volume_test/v4 192.168.40.0/24(rw,no_root_squash)
/data/volume_test/v5 192.168.40.0/24(rw,no_root_squash)
/data/volume_test/v6 192.168.40.0/24(rw,no_root_squash)
/data/volume_test/v7 192.168.40.0/24(rw,no_root_squash)
/data/volume_test/v8 192.168.40.0/24(rw,no_root_squash)
/data/volume_test/v9 192.168.40.0/24(rw,no_root_squash)
/data/volume_test/v10 192.168.40.0/24(rw,no_root_squash)
# 如需批量编辑,请在vim中替换为实际节点网段;不要直接开放给全部客户端
#重新加载配置,使配置生效
exportfs -arv
为三个目录分别创建 PV,示范三种访问模式。下列是无存储类的静态卷:
apiVersion: v1
kind: PersistentVolume
metadata:
  name: pv-nfs-v1
  labels:
    app: v1
spec:
  storageClassName: ""
  nfs:
    server: 192.168.40.4
    path: /data/volume_test/v1
  accessModes:
  - ReadWriteOnce #<[]string> 的字段就要这么写
  capacity:
    storage: 1Gi
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: pv-nfs-v2
  labels:
    app: v2
spec:
  storageClassName: ""
  nfs:
    server: 192.168.40.4
    path: /data/volume_test/v2
  accessModes:
  - ReadOnlyMany
  capacity:
    storage: 1Gi
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: pv-nfs-v3
  labels:
    app: v3
spec:
  storageClassName: ""
  nfs:
    server: 192.168.40.4
    path: /data/volume_test/v3
  accessModes:
  - ReadWriteMany
  capacity:
    storage: 1Gi
PVC 用标签匹配对应 PV。显式写 storageClassName: "",避免被默认 StorageClass 接管:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: pvc-nfs-v1
spec:
  storageClassName: ""
  accessModes:
  - ReadWriteOnce #跟目标PV保持一致
  selector:
    matchLabels:
      app: v1 #找到目标PV的label
  resources:
    requests:
      storage: 1Gi
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: pvc-nfs-v2
spec:
  storageClassName: ""
  accessModes:
  - ReadOnlyMany  #跟目标PV保持一致
  selector:
    matchLabels:
      app: v2 #找到目标PV的label
  resources:
    requests:
      storage: 1Gi
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: pvc-nfs-v3
spec:
  storageClassName: ""
  accessModes:
  - ReadWriteMany #跟目标PV保持一致
  selector:
    matchLabels:
      app: v3 #找到目标PV的label
  resources:
    requests:
      storage: 1Gi
最后用 Deployment 挂载只读示例 PVC。只读语义还需要在挂载处明确声明,不应仅凭 PV 的访问模式判断写保护:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: dep-pvc-nfs-test
spec:
  replicas: 3
  selector:
    matchLabels:
      storage: pvc
  template:
    metadata:
      labels:
        storage: pvc
    spec:
      containers:
      - name: test-pvc
        image: nginx
        volumeMounts:
        - name: nginx-html
          mountPath: /usr/share/nginx/html
          readOnly: true
      volumes:
      - name: nginx-html
        persistentVolumeClaim:
          claimName: pvc-nfs-v2
          readOnly: true
访问模式限制什么
访问模式用于 PV/PVC 匹配,也会按驱动能力影响可挂载节点或 Pod。后端是否支持某种模式,需要查对应驱动;不支持时不能仅修改 YAML 使其生效。官方定义见PV 访问模式。
| 模式 | 缩写 | 含义 |
|---|---|---|
ReadWriteOnce | RWO | 单节点读写,同一节点上多个 Pod 仍可能访问同一个卷 |
ReadOnlyMany | ROX | 多节点只读访问能力,不能单独替代挂载层和服务端的写保护配置 |
ReadWriteMany | RWX | 多节点读写,应用仍需处理并发写入与锁 |
ReadWriteOncePod | RWOP | 将卷约束为集群中一个 Pod 使用,只支持符合要求的 CSI 卷 |
RWOP 在 Kubernetes 1.29 达到稳定,较早版本的可用性与 CSI sidecar 版本需要另外核对。需要只读时应显式设置 readOnly: true 并检查服务端权限;RWO、ROX、RWX 不是通用的文件写保护开关。当前没有对应的通用 ReadOnlyOncePod 模式。
回收从 PVC 删除后开始
Pod 删除或容器重启,通常不会解除 PVC 与 PV 的绑定。只有 PVC 被删除并释放绑定后,才进入由 .spec.persistentVolumeReclaimPolicy 决定的回收流程。StatefulSet 还可能按自己的 PVC 保留策略删除 PVC,因此两层生命周期需要分开看。
| 策略 | 卷释放后的行为 | 应用前需要确认 |
|---|---|---|
Retain | 保留 PV 与底层数据,通常进入 Released,等待人工处理 | 新 PVC 不会自动接管旧绑定,管理员需核对数据与 claimRef 后再复用 |
Delete | 支持该策略的供应器删除 PV 和对应后端存储 | 是否确实允许删除数据,是否有可恢复备份 |
Recycle | 旧式基础清理后复用,已弃用 | 新方案应使用动态供应与明确回收流程 |
动态 PV 通常继承 StorageClass 的策略,StorageClass 未指定时默认 Delete;已存在 PV 应检查自身实际字段,后来修改 StorageClass 不会自动改写历史 PV。Retain 也不是备份,磁盘损坏、应用误写和外部删除仍可能造成损失。
PVC 仍被 Pod 使用时,存储保护机制可能延迟其删除;不要为了消除 Terminating 就直接移除 finalizer。需要复用 Retain 卷时,可按管理员流程处理旧对象与绑定,不能把“删除 PV 再重建”当作所有后端都安全的通用操作。
Pending 时先判断卡在哪一层
| 现象 | 常见原因 | 首先查看 |
|---|---|---|
| PVC Pending | 容量不足、存储类不匹配、访问模式或卷模式不匹配、PV 已占用 | kubectl describe pvc <名称> 的事件 |
| PVC 等待消费者 | StorageClass 使用 WaitForFirstConsumer | 是否已创建消费 Pod,Pod 的调度条件能否满足 |
| 动态供应失败 | 供应器未安装、RBAC/配额/存储参数不正确 | PVC 事件与供应器日志 |
| Pod Pending | PVC 不存在、跨命名空间引用、卷的节点/可用区与调度冲突 | Pod 事件、PVC 状态与 PV nodeAffinity |
| Pod ContainerCreating | 挂载工具缺失、网络、权限或附加卷失败 | kubelet/CSI 事件与节点侧挂载错误 |
动态供应:让 StorageClass 选择供应器
静态 PV 适合已有卷和小规模实验;请求增多后,为每个 PVC 手工准备目录、PV 和回收记录会增加维护成本。动态供应由外部控制器根据 PVC 创建后端卷与 PV,应用只需选择所需存储类别。
StorageClass 保存供应参数
StorageClass 包含 provisioner、驱动相关 parameters、reclaimPolicy、volumeBindingMode 等字段。卷容量通常来自 PVC 请求,性能等级、介质、服务端地址等参数则按供应器定义。它不是 Kubernetes 自动理解任意参数的通用模板。字段可对照StorageClass 官方说明。
CSI 与外部 provisioner 的关系
CSI(Container Storage Interface)是存储系统与容器平台集成的标准接口。Kubernetes 可以同时安装多个 CSI 驱动,再由 StorageClass 的 provisioner 选择相应驱动。CSI 控制器与节点插件分别参与供应、附加、挂载、扩容等工作,具体能力由驱动实现。
动态供应不只存在 CSI 一种实现。下面先看在已有 NFS 目录中分配子目录的 external provisioner,再看标准 NFS CSI 驱动。它们是替代方案,不需要在同一实验中同时部署。
NFS 子目录供应器:复用已有共享目录
nfs-subdir-external-provisioner 在现有 NFS 共享目录下为 PVC 创建子目录,并创建相应 NFS PV。它承接了早期 nfs-client-provisioner 的用途,不是 CSI 驱动,也不会自动提供每个子目录的容量配额。
下面采用手写清单展示完整关系:先准备客户端与共享目录,再配置专用 ServiceAccount、供应器 RBAC、Deployment 和 StorageClass。教学环境中的 no_root_squash 应限制在可信节点网段,不能直接向任意客户端开放。
# 上传nfs-client的自动装载程序,称之为provisioner,这个程序会使用我们已经配置好的NFS服务器自动创建持久卷,也就是自动帮我们创建PV
# 所有节点需要预先安装nfs-utils
yum install nfs-utils
#给nfs-provisioner配置空间
mkdir /data/nfs_pro -p
echo "/data/nfs_pro 192.168.40.0/24(rw,no_root_squash)" >> /etc/exports #注:这里如果配置可访问的网段,要写宿主机网段而非pod网段,因为pv本质是挂载到宿主机上再挂载到pod上。
exportfs -arv---
#创建sa,给provisioner来用
#serviceaccount是为了方便Pod里面的进程调用Kubernetes API或其他外部服务而设计的。
apiVersion: v1
kind: ServiceAccount
metadata:
name: nfs-provisioner
---
kind: ClusterRole
apiVersion: rbac.authorization.k8s.io/v1
metadata:
name: nfs-provisioner-runner
rules:
- apiGroups: [""]
resources: ["nodes"]
verbs: ["get", "list", "watch"]
- apiGroups: [""]
resources: ["persistentvolumes"]
verbs: ["get", "list", "watch", "create", "delete"]
- apiGroups: [""]
resources: ["persistentvolumeclaims"]
verbs: ["get", "list", "watch", "update"]
- apiGroups: ["storage.k8s.io"]
resources: ["storageclasses"]
verbs: ["get", "list", "watch"]
- apiGroups: [""]
resources: ["events"]
verbs: ["create", "update", "patch"]
---
kind: ClusterRoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
name: run-nfs-provisioner
subjects:
- kind: ServiceAccount
name: nfs-provisioner
# replace with namespace where provisioner is deployed
namespace: default
roleRef:
kind: ClusterRole
name: nfs-provisioner-runner
apiGroup: rbac.authorization.k8s.io
---
kind: Role
apiVersion: rbac.authorization.k8s.io/v1
metadata:
name: leader-locking-nfs-provisioner
# replace with namespace where provisioner is deployed
namespace: default
rules:
- apiGroups: [""]
resources: ["endpoints"]
verbs: ["get", "list", "watch", "create", "update", "patch"]
---
kind: RoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
name: leader-locking-nfs-provisioner
# replace with namespace where provisioner is deployed
namespace: default
subjects:
- kind: ServiceAccount
name: nfs-provisioner
# replace with namespace where provisioner is deployed
namespace: default
roleRef:
kind: Role
name: leader-locking-nfs-provisioner
apiGroup: rbac.authorization.k8s.io
---
kind: Deployment
apiVersion: apps/v1
metadata:
name: nfs-provisioner
spec:
selector:
matchLabels:
app: nfs-provisioner
replicas: 1
strategy:
type: Recreate
template:
metadata:
labels:
app: nfs-provisioner
spec:
serviceAccountName: nfs-provisioner
containers:
- name: nfs-provisioner
image: registry.cn-beijing.aliyuncs.com/mydlq/nfs-subdir-external-provisioner:v4.0.0
imagePullPolicy: IfNotPresent
volumeMounts:
- name: nfs-client-root
mountPath: /persistentvolumes
env:
- name: PROVISIONER_NAME
value: rm1.com/nfs
- name: NFS_SERVER
value: 192.168.40.180
- name: NFS_PATH
value: /data/nfs_pro/
volumes:
- name: nfs-client-root
nfs:
server: 192.168.40.180
path: /data/nfs_pro/
---
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
name: sc-nfs
provisioner: rm1.com/nfs#创建pvc,引用sc
kind: PersistentVolumeClaim
apiVersion: v1
metadata:
name: pvc-sc-nfs
spec:
accessModes:
- ReadWriteMany
resources:
requests:
storage: 1Gi
storageClassName: sc-nfs
---
#创建pod,挂载pvc
apiVersion: apps/v1
kind: Deployment
metadata:
name: dep-pvc-nfs-test
spec:
replicas: 3
selector:
matchLabels:
storage: pvc
template:
metadata:
labels:
storage: pvc
spec:
containers:
- name: test-pvc
image: nginx
volumeMounts:
- name: nginx-html
mountPath: /usr/share/nginx/html
volumes:
- name: nginx-html
persistentVolumeClaim:
claimName: pvc-sc-nfs供应器的 PROVISIONER_NAME 必须与 StorageClass 的 provisioner 完全一致。上面的清单使用 default 命名空间,如果改用其他命名空间,需要同步修改 ServiceAccount、RoleBinding 和 ClusterRoleBinding 中的 subject。RBAC 采用项目发布的供应器权限清单对应权限,避免把 cluster-admin 直接授予供应器。
NFS CSI:用标准接口提供 NFS 卷
NFS CSI 驱动同样需要已有 NFS 服务器。下面保留 v4.11.0 的本地安装方式作为版本化实验,执行前要先取得该版本仓库,检查与 Kubernetes 的兼容性及镜像来源。第三方镜像代理会改变供应链与可用性,只有确有需要并信任其内容时才替换:
cd csi-driver-nfs/
sed -i "s#registry.k8s.io#k8s.m.daocloud.io#g" deploy/v4.11.0/*.yaml
./deploy/install-driver.sh v4.11.0 local
创建存储类
server 与 share 指向已存在的 NFS 共享。默认删除行为会删除动态卷目录,需要保留时可配置驱动支持的参数与 PV 回收策略;具体以NFS CSI 参数文档为准。NFS 子目录通常不会因为 PVC 请求 10Gi 就具备独立硬配额。
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: nfs-csi
provisioner: nfs.csi.k8s.io
parameters:
  server: 192.168.40.180
  share: /data/nfs_pro # 指定主目录,会自动在里面创建子目录作为每个PV
  # csi.storage.k8s.io/provisioner-secret is only needed for providing mountOptions in DeleteVolume
  # csi.storage.k8s.io/provisioner-secret-name: "mount-options"
  # csi.storage.k8s.io/provisioner-secret-namespace: "default"
reclaimPolicy: Delete
volumeBindingMode: Immediate
mountOptions:
  - nfsvers=4.1
挂载测试
# PVC
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: pvc-nfs-dynamic
spec:
  accessModes:
    - ReadWriteMany
  resources:
    requests:
      storage: 10Gi
  storageClassName: nfs-csi
# pod
---
kind: Pod
apiVersion: v1
metadata:
  name: nginx-nfs
spec:
  containers:
    - image: mcr.microsoft.com/oss/nginx/nginx:1.19.5
      name: nginx-nfs
      command:
        - "/bin/bash"
        - "-c"
        - set -euo pipefail; while true; do echo $(date) >> /mnt/nfs/outfile; sleep 1; done
      volumeMounts:
        - name: persistent-storage
          mountPath: "/mnt/nfs"
          readOnly: false
  volumes:
    - name: persistent-storage
      persistentVolumeClaim:
        claimName: pvc-nfs-dynamic
NFS/NAS 的性能和高可用能力取决于具体服务、网络与存储实现。数据库、缓存、消息队列要核对同步写入、fsync、锁、延迟与故障恢复要求,不应仅凭 PVC 能绑定就认定后端适用。可选择符合要求的块存储、共享文件系统或托管服务;是否放在 Kubernetes 中,应与应用支持方式和团队运维能力一起评估。
默认 StorageClass 与显式空字符串
PVC 省略 storageClassName 时,可以使用默认 StorageClass;显式设置为 "" 则表示不请求存储类,适合前面的无类别静态 PV 实验。集群暂时没有默认类时,省略字段的 PVC 也可能在以后补设默认类后获得存储类,不能把省略字段与空字符串视作相同配置。
可以通过注解设置或取消默认类。通常应保持一个明确的默认类;多默认类并存时,控制平面会使用最近创建的默认 StorageClass,容易让申请结果偏离预期。规则见默认 StorageClass。
kubectl patch storageclass ceph-rbd-storage -p '{"metadata":{"annotations":{"storageclass.kubernetes.io/is-default-class":"true"}}}'
kubectl patch storageclass sc-nfs -p '{"metadata":{"annotations":{"storageclass.kubernetes.io/is-default-class":"false"}}}'
下面省略存储类字段,由默认类供应。它是完整 YAML,保存为文件后再 apply:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: test-default-sc
  namespace: default
spec:
  accessModes:
  - ReadWriteOnce
  resources:
    requests:
      storage: 10Gi
StatefulSet 为每个序号创建独立 PVC
StatefulSet 的 volumeClaimTemplates 位于 .spec 下,会为每个模板和 Pod 序号创建 PVC。这里用三副本 RabbitMQ 展示完整的存储关联:Pod 0、1、2 各有一份数据卷,同一序号重建后继续使用相应 PVC。更多身份与保留策略见 14-k8s基础-statefulset.md。
下面是 RabbitMQ 3.13.6 的历史版本化实验,不是当前生产版本推荐。先创建 public-service 命名空间,并在启动 StatefulSet 前准备下方 ConfigMap、Secret、RBAC 与 Service,确认 nfs-csi 已能供应卷。第三方镜像、共享存储以及占位凭据都需要按环境验证和替换。生产部署可优先评估 RabbitMQ 官方 Operator。
RabbitMQ 3.13 的集群发现说明要求关注逐 Pod DNS、启动顺序和探针依赖:这里使用 Parallel 避免等待成员就绪造成循环依赖,Headless Service 发布未就绪成员地址用于发现,普通客户端入口仍按就绪状态选择后端。
StatefulSet:独立数据卷与成员名称
kind: StatefulSet
apiVersion: apps/v1
metadata:
  labels:
    app: rmq-cluster
  name: rmq-cluster
  namespace: public-service
spec:
  replicas: 3
  podManagementPolicy: Parallel
  selector:
    matchLabels:
      app: rmq-cluster
  serviceName: rmq-cluster
  template:
    metadata:
      labels:
        app: rmq-cluster
    spec:
      containers:
      - args:
        - -c
        - |
          set -eu
          cp -v /etc/rabbitmq/rabbitmq.conf "$RABBITMQ_CONFIG_FILE"
          exec docker-entrypoint.sh rabbitmq-server
        command:
        - sh
        env:
        - name: RABBITMQ_DEFAULT_USER
          valueFrom:
            secretKeyRef:
              key: username
              name: rmq-cluster-secret
        - name: RABBITMQ_DEFAULT_PASS
          valueFrom:
            secretKeyRef:
              key: password
              name: rmq-cluster-secret
        - name: RABBITMQ_ERLANG_COOKIE
          valueFrom:
            secretKeyRef:
              key: cookie
              name: rmq-cluster-secret
        - name: K8S_SERVICE_NAME
          value: rmq-cluster
        - name: POD_IP
          valueFrom:
            fieldRef:
              fieldPath: status.podIP
        - name: POD_NAME
          valueFrom:
            fieldRef:
              fieldPath: metadata.name
        - name: POD_NAMESPACE
          valueFrom:
            fieldRef:
              fieldPath: metadata.namespace
        - name: RABBITMQ_USE_LONGNAME
          value: "true"
        - name: RABBITMQ_NODENAME
          value: rabbit@$(POD_NAME).rmq-cluster.$(POD_NAMESPACE).svc.cluster.local
        - name: RABBITMQ_CONFIG_FILE
          value: /var/lib/rabbitmq/rabbitmq.conf
        image: registry.cn-beijing.aliyuncs.com/dotbalo/rabbitmq:3.13.6-management-alpine
        imagePullPolicy: IfNotPresent
        livenessProbe:
          exec:
            command:
            - rabbitmq-diagnostics
            - ping
          initialDelaySeconds: 30
          timeoutSeconds: 10
        name: rabbitmq
        ports:
        - containerPort: 15672
          name: http
          protocol: TCP
        - containerPort: 5672
          name: amqp
          protocol: TCP
        readinessProbe:
          exec:
            command:
            - rabbitmq-diagnostics
            - ping
          initialDelaySeconds: 10
          timeoutSeconds: 10
        volumeMounts:
        - mountPath: /etc/rabbitmq
          name: config-volume
          readOnly: true
        - mountPath: /var/lib/rabbitmq
          name: rabbitmq-storage
          readOnly: false
      serviceAccountName: rmq-cluster
      terminationGracePeriodSeconds: 30
      volumes:
      - configMap:
          items:
          - key: rabbitmq.conf
            path: rabbitmq.conf
          - key: enabled_plugins
            path: enabled_plugins
          name: rmq-cluster-config
        name: config-volume
  volumeClaimTemplates:
  - metadata:
      name: rabbitmq-storage
    spec:
      accessModes:
      - ReadWriteOnce
      storageClassName: "nfs-csi"
      resources:
        requests:
          storage: 4Gi
Headless Service:供成员发现
kind: Service
apiVersion: v1
metadata:
  labels:
    app: rmq-cluster
  name: rmq-cluster
  namespace: public-service
spec:
  clusterIP: None
  publishNotReadyAddresses: true
  ports:
  - name: amqp
    port: 5672
    targetPort: 5672
  selector:
    app: rmq-cluster
NodePort Service:供客户端访问
kind: Service
apiVersion: v1
metadata:
  labels:
    app: rmq-cluster
    type: NodePort
  name: rmq-cluster-balancer
  namespace: public-service
spec:
  ports:
  - name: http
    port: 15672
    protocol: TCP
    targetPort: 15672
  - name: amqp
    port: 5672
    protocol: TCP
    targetPort: 5672
  selector:
    app: rmq-cluster
  type: NodePort
这个实验用 rabbitmq-diagnostics ping 做基本健康检查,便于观察成员发现与启动。ping 成功不等于所有队列和应用读写已经就绪;生产客户端入口需要结合拓扑选择更合适的检查,避免把仍在同步的节点过早接入业务。
ConfigMap:启用发现插件
账号与密码由 Secret 引用的环境变量传入,不在配置文件中再写一套固定值。下面保留 3.13 时代的发现与分区配置;autoheal、队列位置策略等均有应用级取舍,升级 RabbitMQ 时需要按目标版本检查,不能直接把配置迁入新版本。
kind: ConfigMap
apiVersion: v1
metadata:
  name: rmq-cluster-config
  namespace: public-service
  labels:
    addonmanager.kubernetes.io/mode: Reconcile
data:
    enabled_plugins: |
      [rabbitmq_management,rabbitmq_peer_discovery_k8s].
    rabbitmq.conf: |
      loopback_users.guest = false

      ## Clustering
      cluster_formation.peer_discovery_backend = rabbit_peer_discovery_k8s
      cluster_formation.k8s.host = kubernetes.default.svc.cluster.local
      cluster_formation.k8s.address_type = hostname
      #################################################
      # public-service is rabbitmq-cluster's namespace#
      #################################################
      cluster_formation.k8s.hostname_suffix = .rmq-cluster.public-service.svc.cluster.local
      cluster_formation.node_cleanup.interval = 10
      cluster_formation.node_cleanup.only_log_warning = true
      cluster_partition_handling = autoheal
      ## queue master locator
      queue_master_locator=min-masters
Secret:启动账号与 Erlang cookie
这些是占位值,应用前必须替换为受控凭据,并确保各成员使用同一个安全生成的 cookie。Secret 的 Base64/明文输入方式不等于存储加密;读取权限与集群静态加密需要另外配置。
kind: Secret
apiVersion: v1
metadata:
  name: rmq-cluster-secret
  namespace: public-service
stringData:
  cookie: ERLANG_COOKIE
  password: RABBITMQ_PASS
  url: amqp://RABBITMQ_USER:RABBITMQ_PASS@rmq-cluster-balancer
  username: RABBITMQ_USER
type: Opaque
RBAC:读取本命名空间的成员端点
apiVersion: v1
kind: ServiceAccount
metadata:
  name: rmq-cluster
  namespace: public-service
---
kind: Role
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rmq-cluster
  namespace: public-service
rules:
  - apiGroups:
      - ""
    resources:
      - endpoints
    verbs:
      - get
---
kind: RoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rmq-cluster
  namespace: public-service
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: Role
  name: rmq-cluster
subjects:
- kind: ServiceAccount
  name: rmq-cluster
  namespace: public-service
PVC 扩容:从申请变更到文件系统可用
使用率告警、No space left on device、持续增长的数据量,都会触发容量评估。但“把 PVC 从 10Gi 改成 20Gi”只提交了新申请,是否能够扩容、是否在线完成,还取决于 StorageClass、CSI 驱动、后端容量和文件系统。
Kubernetes 支持符合条件的卷扩容,不支持把已经分配的底层卷原地缩小。NFS 子目录的容量声明还可能只是 API 元数据,不能与独立块设备的实际扩盘等同。一般规则见持久卷扩容说明。
先检查当前容量、存储类与驱动能力
先确认 PVC 已绑定、当前申请与实际容量是什么,再确定 StorageClass:
kubectl get pvc <pvc-name> -n <namespace>
kubectl get pvc <pvc-name> -n <namespace> -o jsonpath='{.spec.storageClassName}'
kubectl get storageclass <sc-name> -o yaml
StorageClass 需要允许扩容:
allowVolumeExpansion: true如果驱动确实支持而存储类未开启,可以按变更流程修改 StorageClass:
kubectl edit storageclass <sc-name>修改该字段不需要重启集群,但它不会赋予驱动原本没有的功能。必须同时确认驱动支持 controller/node expansion、对应文件系统可扩展,后端有足够空间与配额;有些驱动只能离线扩容。初学实验可以选一份非关键测试卷,先验证同一驱动版本的行为。
提交新的容量请求
下面两种方式选择其一。示例把请求改成 20Gi,实际数值必须大于当前容量,并符合后端限制:
kubectl patch pvc <pvc-name> -n <namespace> -p '{"spec":{"resources":{"requests":{"storage":"20Gi"}}}}'或编辑 .spec.resources.requests.storage:
kubectl edit pvc <pvc-name> -n <namespace>终端显示 patched 只说明 API 接受了请求,不代表后端和文件系统已经扩完。不要先手工把 PV 的 capacity 改大;这可能让控制平面误认为后端已扩容,从而跳过实际扩容操作。
同时看控制器进度与容器内结果
对常见文件系统块卷,流程包含后端卷扩容和节点上的文件系统扩容。支持在线扩容的驱动与文件系统可以在 Pod 运行时完成;其他组合可能需要按驱动流程重新挂载或安排停机。原始块设备则没有相同的文件系统扩展步骤。
kubectl describe pvc <pvc-name> -n <namespace>
kubectl exec <pod-name> -n <namespace> -- df -h
FileSystemResizePending 表示节点侧文件系统还需处理,不能一概理解为“必须重启”。先检查驱动、kubelet 事件和当前挂载状态,再决定是否按维护流程重启。文件系统容量变大后,还要检查实际写入和应用自身的空间识别;NFS 的 df 可能显示整个共享文件系统容量,不能据此证明每个 PVC 具有独立配额。
缩小请求不等于缩小已有卷
下面是普通已完成分配的 PVC 缩容反例:
kubectl patch pvc my-pvc -p '{"spec":{"resources":{"requests":{"storage":"5Gi"}}}}'
# 如果5Gi小于已经分配的容量,会被API拒绝;具体错误信息因版本而异
需要实际回收空间时,可以保留现有容量等待后续使用,或创建较小的新 PVC,执行应用支持的数据迁移、校验与切换。迁移前要确认使用量、索引、日志和增长余量都能放下,切换与旧卷删除应分别评估。不能直接缩文件系统或手工编辑 PV 数值来伪装缩容。
扩容申请写错后如何恢复
如果把目标值写得超过后端能力,扩容可能持续重试。RecoverVolumeExpansionFailure 在 Kubernetes 1.32/1.33 为默认开启的 Beta,1.34 达到稳定;更早环境要核对开关、控制平面、kubelet 和 external-resizer 的版本,不能把 1.34 当作此前完全不可恢复的分界。
该机制允许把尚未完成的过大申请修正为较小值,但新值仍必须大于已经实际分配的容量,不能让已完成扩容的卷变小。行为与兼容要求见扩容失败恢复说明和特性门控记录。
例如原卷为 10Ti,误申请 1000Ti 且后端尚未完成扩展,评估后可尝试修正为 100Ti:
kubectl patch pvc myclaim -p '{"spec":{"resources":{"requests":{"storage":"100Ti"}}}}'Kubernetes 容量使用 T、Ti、G、Gi 等 Quantity 单位,不能把 TB 当成通用合法后缀。若后端已扩到大于新申请的容量,不能用这个方法收缩。
查看当前版本报告的扩容状态:
kubectl get pvc myclaim -o jsonpath='{.status.allocatedResourceStatuses.storage}'
kubectl get pvc myclaim -o jsonpath='{.status.allocatedResources.storage}'
API 字段是复数 allocatedResourceStatuses。常见状态涉及控制器扩容中、等待节点扩容、节点扩容中或失败;不同版本可能报告不同失败状态名,应同时查看事件和驱动错误。当前 API 的状态定义可对照PVC API。
| 状态类别 | 含义 | 接下来查看什么 |
|---|---|---|
ControllerResizeInProgress | 控制器开始处理后端扩容 | external-resizer 和后端操作进度 |
NodeResizePending | 控制器阶段结束,还需节点处理 | kubelet、CSI node 插件、挂载条件 |
NodeResizeInProgress | 节点正在处理扩容 | 节点日志与文件系统结果 |
| 失败或不可行状态 | 请求无法完成,或存在需干预的错误 | PVC 事件、驱动返回、配额和后端限制 |
状态为空可能表示没有进行中的扩容操作,但不能单凭这一点确认业务可写。旧版本或不支持自动恢复的组合,需要管理员按官方恢复流程处理绑定和回收保护,不能直接删除 PVC 或改写容量来试错。
生产环境如何留出容量缓冲
备份与可恢复验证应在扩容前完成,数据库尤其要注意一致性备份。告警阈值应结合增长速度、扩容耗时和运维响应时间设置;例如把 80% 设为预警、90% 设为紧急,可以作为起点,但不适合作为所有存储的固定标准。若数据每月增长 20%,或已用容量乘 1.5 仍覆盖不了申请周期,就需要更早扩容或更大的余量。
容量看板还应同时观察 PVC 使用量、后端剩余量、IOPS、吞吐和延迟。卷变大有时还会改变性能与计费,不能只看 Gi 数值。
| 场景 | 可以评估的存储 | 关键检查 |
|---|---|---|
| MySQL、PostgreSQL、etcd 等数据库 | 符合应用要求的块存储或托管方案,例如云盘、分布式块存储 | IOPS、延迟、写入持久性、故障恢复和扩容支持 |
| 大文件共享与文件日志 | 支持 RWX 的共享文件系统,如 NFS/NAS、CephFS | 并发语义、配额、服务端容量与可用性 |
| 可重新生成的非关键数据 | 普通云盘、本地缓存等 | 恢复成本、节点故障影响与价格 |
常见问题速查
| 现象 | 可能原因 | 排查方向 |
|---|---|---|
| patch 后容量没变化 | 存储类未允许扩容、驱动不支持、后端处理未完成 | 检查 PVC 事件、StorageClass、驱动与后端能力 |
事件出现 VolumeResizeFailed | 配额、后端限制、驱动错误或卷类型不支持 | 根据具体错误处理;静态 PV 不必然不能扩容,不要直接修改 PV 容量 |
FileSystemResizePending 持续存在 | 节点侧处理尚未完成、挂载条件不满足或驱动要求离线 | 先检查 kubelet/CSI 日志,再按驱动流程维护 Pod |
| 需要更小的卷 | Kubernetes 不支持已有卷原地缩小 | 新建 PVC,执行经过验证的数据迁移与切换 |
| 过大的扩容申请卡住 | 后端无法满足,或恢复机制版本不兼容 | 在支持条件下修正尚未完成的请求;其余情况由管理员按恢复流程处理 |