StatefulSet:为有状态应用保留身份、存储和更新顺序
一个无状态 Web 服务的三个副本,通常可以相互替换;数据库或消息队列的三个成员却可能各自拥有数据、成员编号和恢复过程。删除一个容器后重新启动,并不等于可以把它当成一个全新成员加入集群。
StatefulSet 为 Pod 保留稳定名称、序号和存储关联,帮助应用重新找到原来的身份。它不会自动实现数据库复制、选主或一致性。本文先通过 Nginx 学习这些 Kubernetes 机制,再讨论更新、回滚,以及整体重建时容易混淆的边界。
基础实验需要可用集群、kubectl、集群 DNS,以及已安装供应器的 StorageClass。后半部分的 Recreate 是单独的 Alpha 功能,不能假设所有支持 StatefulSet 的集群都能使用。
什么样的状态需要稳定身份
无状态副本不在本机保存不可替代的业务状态,通常可在满足资源、网络等条件的节点间替换。有状态应用可能需要独立数据目录、成员身份、稳定地址或启动依赖,但并非每一种有状态应用都同时要求这几项。
| 需求 | StatefulSet 提供的机制 | 应用仍需负责的工作 |
|---|---|---|
| 成员编号不随重建改变 | 默认从 0 开始的 Pod 序号与固定名称 | 把名称映射到应用成员、角色与拓扑 |
| 成员重建后仍能被找到 | Headless Service 管理的稳定 DNS 名称 | 连接重试、DNS 缓存与成员重新加入 |
| 各副本使用独立存储 | volumeClaimTemplates 为各序号创建 PVC | 数据复制、日志恢复、校验与备份 |
| 创建、缩容或更新有顺序 | Pod 管理策略与更新策略 | 探针反映真实就绪状态,处理应用级依赖 |
MySQL、ZooKeeper、MongoDB、Elasticsearch、Redis、Kafka 等都可能借助 StatefulSet 部署,但仅有一份 StatefulSet YAML 并不能组成健康集群。成熟的 Operator 可以封装部分应用运维流程,Helm 可以复用部署模板;是否支持扩缩容、重平衡和安全升级,仍应检查具体项目的能力。机制本身见StatefulSet 官方说明。
先部署 Headless Service 与两个 Pod
StatefulSet 的 .spec.serviceName 指向负责网络身份的 Service。按标准使用方式,先创建相应 Headless Service,也就是 clusterIP: None,再创建 StatefulSet。Service 提供 DNS 域,并不负责管理 StatefulSet 的生命周期。
下面使用已存在的 sc-nfs StorageClass。若沿用前一篇的 NFS CSI 实验,应把示例中的 sc-nfs 换成实际创建的 nfs-csi。volumeClaimTemplates 创建的是 PVC,PV 能否动态创建取决于该 StorageClass 对应供应器;也可由管理员预先准备匹配的 PV。这个 Nginx 例子只演示独立数据目录,没有自动生成站点内容。
apiVersion: v1
kind: Service
metadata:
  name: svc-sts-nginx
  labels:
    app: nginx
spec:
  selector:
    app: nginx
  clusterIP: None
  ports:
  - name: web
    port: 80
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: sts-web
spec:
  replicas: 2
  selector:
    matchLabels:
      app: nginx
  serviceName: svc-sts-nginx
  volumeClaimTemplates:
  - metadata:
      name: www
    spec:
      storageClassName: sc-nfs
      accessModes:
      - ReadWriteOnce
      resources:
        requests:
          storage: 1Gi
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginx
        imagePullPolicy: IfNotPresent
        ports:
        - name: web
          containerPort: 80
        volumeMounts:
        - name: www
          mountPath: /usr/share/nginx/html
将清单保存为 sts-web.yaml,创建后分别观察 Pod、PVC 和发布状态:
kubectl apply -f sts-web.yaml
kubectl get service svc-sts-nginx
kubectl get statefulset sts-web
kubectl get pods,pvc
kubectl rollout status statefulset/sts-web
image: nginx 用于演示结构,生产环境应改为经过验证的固定版本或摘要。PVC 挂到站点目录后会覆盖镜像中该路径原有内容的可见性,空卷不会自动复制镜像内的首页;验证 HTTP 内容前,需要准备测试文件。
从主机名理解稳定网络身份
这个 StatefulSet 创建 sts-web-0、sts-web-1 两个 Pod。它们重建后可恢复相同名称,但 Pod UID 与 IP 可能变化。默认集群域为 cluster.local 时,完整 DNS 名称的格式是:
<pod名称>.<service名称>.<namespace>.svc.cluster.local
sts-web-0.svc-sts-nginx.default.svc.cluster.local
实际集群域可以定制。先查看容器中的主机名:
for i in 0 1; do kubectl exec sts-web-$i -- sh -c 'hostname'; doneHeadless Service 返回后端地址
普通 ClusterIP Service 的名称通常解析为 Service IP,再由数据平面的规则转发到后端。带选择器的 Headless Service 没有 ClusterIP,DNS 查询可以直接返回符合条件的 Pod 地址。查询 Service 的 A/AAAA 记录返回地址,并不是一次返回每个 Pod 的 FQDN 与 IP 对照表。
在集群内具有 DNS 工具的容器中执行:
nslookup svc-sts-nginx.default.svc.cluster.local示例输出如下,DNS 服务器地址和 Pod IP 以实际环境为准:
Server:         10.0.0.10
Address:        10.0.0.10:53

Name:   svc-sts-nginx.default.svc.cluster.local
Address: 10.244.1.9
Name:   svc-sts-nginx.default.svc.cluster.local
Address: 10.244.1.8
也可用 dig 指定 DNS 服务器与记录类型。@ 指定服务器,-t A 查询 IPv4 地址记录:
dig -t A svc-sts-nginx.default.svc.cluster.local @10.0.0.10稳定的逐 Pod DNS 身份依赖正确的 hostname/subdomain 与 Headless Service 配合,不只 StatefulSet 才能具备类似 DNS 记录。不能把普通 ClusterIP Service 的域名与逐 Pod 域名混为一谈,详细规则见Pod 与 Service 的 DNS。
默认情况下,未就绪 Pod 通常不会作为正常服务后端发布;需要成员在就绪前互相发现时,应按应用要求评估 publishNotReadyAddresses,同时避免让普通业务流量过早进入。DNS 还可能有负缓存,Pod 已创建并不保证此前查询失败的客户端马上得到新地址。外部访问可另建 Service 或网关,不必改变负责稳定身份的 Headless Service。
每个序号如何找到自己的卷
例如数据库主从成员通常要使用独立数据目录。volumeClaimTemplates 按 <模板名>-<StatefulSet名>-<序号> 生成 PVC:本例对应 www-sts-web-0 和 www-sts-web-1,各自绑定一个 PV。删除并重建同一序号的 Pod 时,它会继续使用相应 PVC。
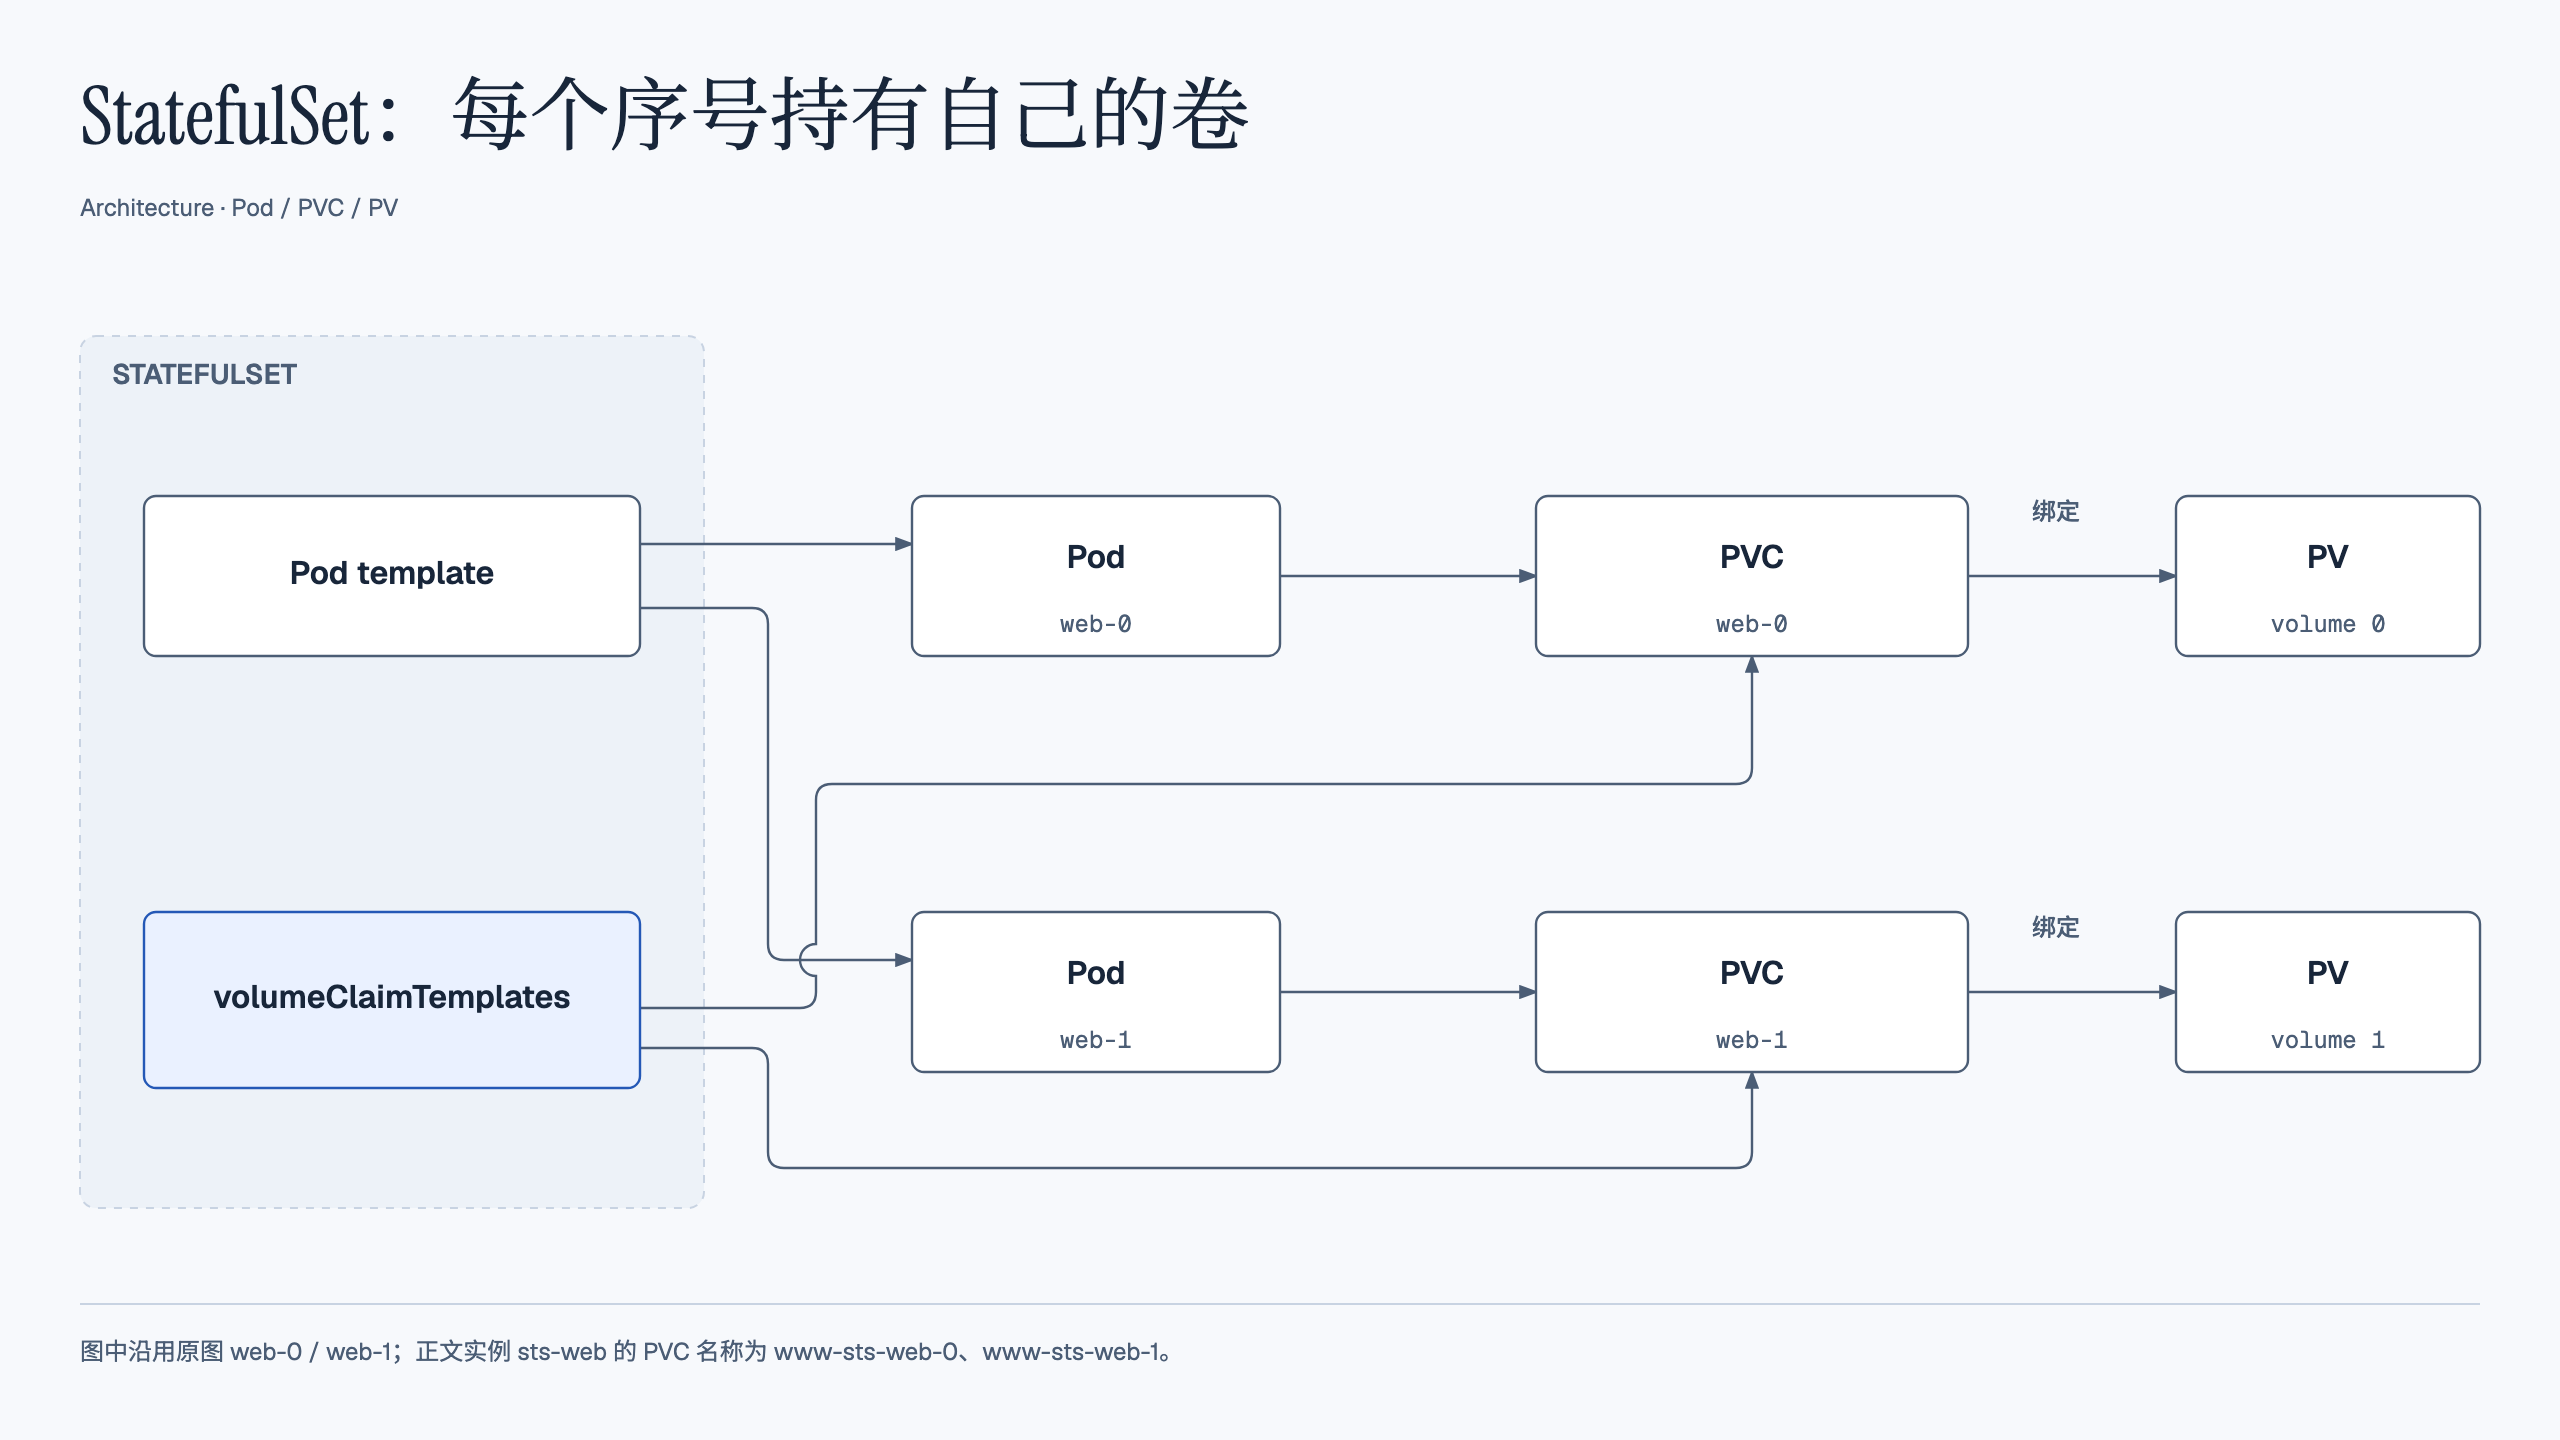
Deployment 也可以挂 PVC,多个 Pod 是否共享一个卷,取决于模板引用和访问模式;它不会自动让数据同步。StatefulSet 同样允许 Pod 共享额外卷,但存储模板的常见用途,是让每个序号各持有一份稳定存储。访问模式和回收策略可结合 13-k8s基础-storage.md 阅读。
扩缩容与 Pod 管理策略
默认 OrderedReady 策略按序号从低到高创建 Pod,并等待前一个 Running、Ready 后继续。缩容按高到低终止,等待前一个退出后再继续。因此 readiness 应反映应用是否足以让下一个成员继续加入。
kubectl scale statefulset/sts-web --replicas=3
kubectl get pods -l app=nginx -w
修改声明式 YAML 中的 replicas 再 apply 也能扩缩容。直接删除整个 StatefulSet 不保证按序终止 Pod;需要有序退出时,应在评估应用影响后先按缩容流程处理。PVC 是否随缩容或删除而清理,取决于保留策略,后文会专门说明。
如果应用只需要身份和独立存储,没有按序启动依赖,可以考虑 .spec.podManagementPolicy: Parallel。它允许扩缩容并行推进,不等待每个 Pod 先就绪或完全退出。滚动更新还受 maxUnavailable 等配置约束:默认预算下通常仍逐个更新;支持并启用相应特性的版本,在 Parallel 且预算大于 1 时可以并发替换。不要简单把 Parallel 理解成所有更新一定同时完成。
滚动更新:从最高序号开始替换
默认策略 RollingUpdate 从高序号到低序号删除并重建 Pod,通常等待新 Pod 就绪后再处理前一个。OnDelete 则不主动替换已有 Pod,只有删除旧 Pod 后,控制器才按新模板创建对应 Pod。
StatefulSet 不像 Deployment 那样通过 surge 先创建同名的新副本。更新会替换该序号的 Pod,再复用对应 PVC;是否能及时卸载、附加和挂载,还取决于存储驱动。
kubectl explain statefulset.spec.updateStrategy用 partition 限定更新范围
下面是完整的分区示例:两个副本、partition: 1,提交新模板后只更新序号 1,序号 0 保持历史模板。若设为 2,则这两个副本都不会因新模板自动更新;确认后把分区降为 0,才会放开全部序号。
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: sts-web
spec:
  replicas: 2
  selector:
    matchLabels:
      app: nginx
  serviceName: svc-sts-nginx
  updateStrategy:
    type: RollingUpdate
    rollingUpdate:
      partition: 1
  volumeClaimTemplates:
  - metadata:
      name: www
    spec:
      storageClassName: sc-nfs
      accessModes:
      - ReadWriteOnce
      resources:
        requests:
          storage: 1Gi
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginx
        imagePullPolicy: IfNotPresent
        ports:
        - name: web
          containerPort: 80
        volumeMounts:
        - name: www
          mountPath: /usr/share/nginx/html
这里没有更换镜像,因此单独提交该清单只说明策略配置,真正观察更新还需配合经过验证的模板变化。
StatefulSet 的 rollingUpdate.maxUnavailable 与 Deployment 不同,不能设为 0,默认是 1,百分比向上取整。官方将其标为 Kubernetes 1.35 起的 Beta 功能,具体效果还受 podManagementPolicy 与目标版本约束;上面的基础示例不依赖这个可选字段。字段定义见StatefulSet API。
回滚还要检查应用兼容性
StatefulSet 用 ControllerRevision 保存修订历史,可以查看并回退 Pod 模板:
kubectl rollout status statefulset/sts-web
kubectl rollout history statefulset/sts-web
kubectl rollout undo statefulset/sts-web --to-revision=1
选择回滚还是向前修复,取决于旧版本能否读取当前数据。回退镜像不会回退 PVC 内容、数据库 schema 或外部配置。默认有序更新还可能在坏版本 Pod 无法就绪时卡住;恢复旧模板后,可能需要按官方强制回滚说明处理已采用坏配置的 Pod。删除前必须确认集群成员与存储状态,不能把它作为无条件操作。
完整站点实验:把存储类也连接起来
下面给出另一套独立站点清单,使用新的 sts-site 名称,避免与前面的 sts-web 存储模板冲突。它假设 NFS CSI 驱动已经安装,192.168.40.180:/data/nfs_pro 是已配置好的共享目录。StorageClass 的 provisioner 必须对应真实驱动,写一个任意名称不会自动创建供应器。
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: nfs-web
provisioner: nfs.csi.k8s.io
parameters:
  server: 192.168.40.180
  share: /data/nfs_pro
reclaimPolicy: Retain
volumeBindingMode: Immediate
---
apiVersion: v1
kind: Service
metadata:
  name: svc-sts-site
  namespace: default
spec:
  clusterIP: None
  selector:
    app: sts-site
  ports:
  - name: www
    port: 80
    protocol: TCP
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: sts-site
  namespace: default
  labels:
    app: sts-site
spec:
  replicas: 2
  selector:
    matchLabels:
      app: sts-site
  serviceName: svc-sts-site
  template:
    metadata:
      labels:
        app: sts-site
    spec:
      containers:
      - name: nginx
        image: nginx
        imagePullPolicy: IfNotPresent
        ports:
        - name: www
          containerPort: 80
          protocol: TCP
        volumeMounts:
        - name: storage-web
          mountPath: /usr/share/nginx/html
  volumeClaimTemplates:
  - metadata:
      name: storage-web
    spec:
      accessModes: ["ReadWriteOnce"]
      storageClassName: nfs-web
      resources:
        requests:
          storage: 1Gi
两份 PVC 的 Bound 状态、Pod 名称和挂载关系应分别观察。两个 Nginx 虽使用同一镜像,站点目录属于不同 PVC;在其中一份卷写入首页,不会自动复制到另一份。数据库复制也是应用层能力,StatefulSet 的稳定身份只提供了组织这些成员的基础。
Recreate 更新策略(Kubernetes 1.37 Alpha)
当应用不允许两个版本共存时,逐个替换也可能不适用。Kubernetes 为 StatefulSet 增加了整体重建策略,但它有明确的版本与开关条件。下面同时保留一篇 2026 年 8 月 24 日技术文章中的事故与迁移记录,帮助区分实际 API 行为、作者观察和未证实的因果关系。
官方文档将 Recreate 标为 Kubernetes 1.37 起的 Alpha 功能,默认关闭;使用前需要在 kube-apiserver 和 kube-controller-manager 启用 StatefulSetRecreateStrategy。原记录把它称为 GA,这一点与官方状态不符。版本号本身不能证明集群已经启用,需同时检查配置与实际行为。状态见官方 Recreate 说明。
另外,rollingUpdate 只适用于 RollingUpdate。切换成 Recreate 时需要清除它,不能用 partition 限制整体重建范围。后面的原配置反例专门用于解释这个区别,不能直接执行部署。
为什么需要整体重建
有状态应用升级时,除了 Pod 能否启动,还要检查集群成员关系、数据格式和客户端连接。逐个替换 Pod 会让不同序号的副本暂时运行不同版本;如果应用不支持这种混合运行,升级就可能出现兼容性问题。
作者记录过一个三节点 etcd 类共识集群的故障:序号 1 的新 Pod 已启动但尚未加入集群,序号 0 的旧 Pod 随后被删除,短暂只剩一个健康节点,发生重新选主和快照重建,P99 写入延迟升至秒级。这是原文的事故描述,未提供配置和探针信息,不能据此判断所有共识集群都应改用整体重建。
三种更新策略的区别如下。Recreate 为可选功能,默认更新策略仍是 RollingUpdate。参见 StatefulSet API。
| 策略 | 修改 Pod 模板后的行为 | 适用条件 |
|---|---|---|
RollingUpdate | 自动逐个删除并重建 Pod;默认从高序号向低序号更新 | 应用允许新旧版本在不同副本上短暂共存;可用 partition 分阶段更新 |
OnDelete | 不主动更新已有 Pod;删除 Pod 后,控制器才按更新后的模板重建 | 更新节奏由人工或外部自动化控制 |
Recreate | 删除全部 Pod,等它们完全终止后,再创建新版本 Pod | 应用不能同时运行两个版本,并能接受整体停机;需启用 Alpha 特性门控 |
Recreate 的删除阶段不受 podManagementPolicy 影响,全部 Pod 会一起进入删除流程。创建阶段则遵循该字段:OrderedReady 从序号 0 开始,逐个等待 Running 和 Ready;Parallel 并行创建全部 Pod。它不能保证所有 Pod 在同一瞬间退出,也不保证应用数据格式自动兼容。见官方 Recreate 说明。
这里的重建会替换 Pod 实例,保留的是 StatefulSet 的稳定身份与存储映射。是否接受停机,应由应用的升级要求和业务恢复目标决定。原文认为“一致性优于可用性”,并主张共识或主从服务默认采用 Recreate;这是作者的取舍,不能直接作为所有有状态应用的默认配置。
配置示例与启用条件
以下示例用于对照配置约束,其中 Recreate 与 rollingUpdate.partition 的组合会被当前 StatefulSet API 校验拒绝。它没有提供实际 Service、存储和 Redis 集群配置,不能作为完整部署清单使用。
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: redis-cluster
spec:
  serviceName: redis-cluster
  selector:
    matchLabels:
      app: redis-cluster
  replicas: 3
  podManagementPolicy: OrderedReady
  updateStrategy:
    type: Recreate
    rollingUpdate:
      partition: 0   # 反例:Recreate不允许配置rollingUpdate或partition
  template:
    metadata:
      labels:
        app: redis-cluster
    spec:
      containers:
      - name: redis
        image: redis:7.4
正确的字段组合可以写成下面的片段,需合入完整 StatefulSet。启用特性门控后,Recreate 不配置 rollingUpdate,这里同时显式保留 PVC:
spec:
  podManagementPolicy: OrderedReady
  updateStrategy:
    type: Recreate
  persistentVolumeClaimRetentionPolicy:
    whenDeleted: Retain
    whenScaled: Retain
两个控制面组件都需要启用以下参数;配置方式按集群安装方式处理:
--feature-gates=StatefulSetRecreateStrategy=true从已有 RollingUpdate 配置切换时,需要同时清除 rollingUpdate。以下是根据 API 约束补充的策略切换命令,前提是集群已经支持并启用该特性,且 StatefulSet 没有被 Operator 回写策略:
kubectl patch sts redis-cluster --type=merge -p '{"spec":{"updateStrategy":{"type":"Recreate","rollingUpdate":null}}}'随后通过现有清单修改 spec.template 中的镜像或配置,观察旧 Pod 是否全部终止后才创建新 Pod。仅切换策略或调整分区,不等于提交了新的 Pod 模板。首次使用应在非核心环境演练;API 接受配置之后,还要核对控制器实际执行的删除、创建顺序。启用条件参见 KEP-3541。
Pod、PVC 与 PV 的生命周期
通过 volumeClaimTemplates 创建的 PVC,名称为 <模板名>-<sts名>-<序号>,例如 data-redis-cluster-0。同一序号的 Pod 重建后,使用原有 PVC 是 StatefulSet 的预期行为;删除 Pod 并不等于删除 PVC,也不等于清空历史数据。
需要分清两层策略:
| 配置 | 控制的对象和时机 | Retain 的含义 |
|---|---|---|
StatefulSet 的 persistentVolumeClaimRetentionPolicy.whenDeleted / whenScaled | 删除 StatefulSet 或缩容时,是否删除模板生成的 PVC | 保留 PVC;两项默认均为 Retain |
PV 的 persistentVolumeReclaimPolicy,动态创建时继承 StorageClass 的 reclaimPolicy | PVC 删除、PV 被释放后的底层存储处置 | 保留 PV 与底层数据,供后续人工处理 |
第一层用于 StatefulSet 删除和缩容,不把正常更新时的 Pod 替换变成 PVC 删除。第二层在 PVC 被删除后才涉及卷回收;StorageClass 为 Delete 不能单独解释“删 Pod 导致 PVC 被回收”。检查已有卷时,应检查实际 PV 的回收策略。参见官方 PVC 保留策略和官方 PV 回收说明。
原文建议核心数据使用 Retain 并定期快照。可将它作为数据保护方案评估,但 Retain 不能阻止 PVC 对象被删除,也不能替代备份或恢复演练。删除 StatefulSet 前仍需核对 PVC 保留策略、ownerReferences 和级联删除方式。
原文还把 Deployment 的存储概括为临时卷,这个说法过于绝对:Deployment 也可以挂载 PVC。StatefulSet 的特点是为各序号维持稳定身份,并通过存储模板管理相应 PVC。
分区灰度:使用 RollingUpdate
partition 以序号为阈值划分更新范围,不能按业务指标自动放行。以下分区更新步骤应在 type: RollingUpdate 下使用;Recreate 没有分区灰度入口。默认从 0 编号时,3 副本的 partition: 2 会把更新限制在序号 2,较低序号仍运行旧版本。
第一步:先更新最高序号 Pod
先确认策略为 RollingUpdate,再在提交新 Pod 模板前设定分区。原文使用 replicas-1,即 3 副本设为 2,然后观察新 Pod 能否加入集群、数据是否符合预期:
kubectl patch sts redis-cluster --type=merge -p '{"spec":{"updateStrategy":{"type":"RollingUpdate","rollingUpdate":{"partition":2}}}}'
kubectl rollout status sts/redis-cluster --timeout=120s
这些命令设置分区并等待 rollout,不包含镜像或模板更新;需要配合实际的模板变更。rollout 成功也不等于应用数据一致性验证完成。
第二步:检查后逐步放开
原文基础流程是在检查通过后把 partition 降为 0:
kubectl patch sts redis-cluster -p '{"spec":{"updateStrategy":{"rollingUpdate":{"partition":0}}}}'
kubectl rollout status sts/redis-cluster --timeout=300s
作者还描述了一种三阶段流程:先更新最高序号,执行自动化校验,包括按应用的数据布局比对数据哈希、检查集群成员;人工确认后降到中间序号;最后降为 0。各阶段之间至少观察 10 分钟,监控 P99 延迟和错误率。原文称采用该流程后半年没有事故,这一效果尚未复现验证。对默认编号的 3 副本而言,分区可以依次为 2、1、0;这仍然允许不同副本暂时运行不同版本。
第三步:检查 PVC 与应用状态
原文的检查命令如下,同样可用于重建后的检查:
# 检查 PVC 是否还在(Recreate 不应删卷)
kubectl get pvc -l app=redis-cluster
# 检查集群成员与数据
kubectl exec redis-cluster-0 -- redis-cli cluster info
kubectl get pvc -l app=redis-cluster 只会列出带该标签的 PVC,需确认存储模板实际设置了标签。redis-cli cluster info 可以检查集群状态,不能单独证明全部数据完整;还应按应用需要核对成员、持久化恢复和数据校验结果。
如果应用要求整个 StatefulSet 内的新旧版本完全不共存,应评估 Recreate 的停机窗口、Operator 提供的维护流程,或独立 StatefulSet 的切换方案。不能同时把同一更新过程描述为“分区逐个更新”和“全程没有新旧版本并存”。
11 个故障案例:分别检查控制器、存储和流量
以下故障和处理方式由作者报告,未提供完整环境、事件和日志;涉及 Recreate、存储删除或流量行为的结论,需要结合前面的核验说明阅读。
1. 未灰度就整体停机
作者称首次直接设置 type: Recreate,3 个 Pod 同时被删除,服务中断,恢复用了 5 分钟;之后要求先用 partition 灰度。核验说明:Recreate 本来就是全量重建,partition 不能限制它的更新范围。先灰度需要选择 RollingUpdate 或另行设计验证环境,整体重建则要预留停机窗口。
2. PVC 丢失
作者将一次重建后的 PVC 清理和历史数据丢失归因于 StorageClass 设置了 Delete,处理方式是改为 Retain 并定期快照。核验说明:这个原因链缺少 PVC 如何被删除的证据;需检查 PVC 保留策略、ownerReferences 和其他删除操作,不能只凭 StorageClass 的回收策略归因。
3. 并行启动破坏依赖顺序
作者称使用 podManagementPolicy: Parallel 后,从节点先于主节点启动,出现选主异常,改回 OrderedReady 后稳定。存在启动依赖时,应保留适合该应用的顺序;Parallel 不保证节点按序就绪。
4. 进程已启动,数据尚未就绪
容器进程启动后,数据仍在加载。原文称 readiness 探针缺失导致流量过早进入,补充探针后才解决。探针需要反映应用可接收请求的状态,而不仅是进程存活。
5. 初始化依赖失败
原文把这一项称为“有状态 sidecar 顺序依赖”,实际描述的是 init 容器拉取配置失败,并称主容器持续 CrashLoop;作者将配置加载改成异步重试后恢复。核验说明:普通 init 容器需成功完成后,应用容器才会启动。应根据容器状态和日志区分初始化失败与应用启动失败,不能由这段描述确认主容器的失败路径。见官方 init 容器说明。
6. 客户端仍使用旧地址
作者称 DNS 缓存使客户端短期内继续连接旧 Endpoint,处理方式是配合 readiness 控制服务端就绪状态,并在客户端增加连接重试。整体重建也不能替代客户端的断线恢复逻辑。
7. Operator 覆盖手工配置
作者称数据库 Operator 固定使用 RollingUpdate,手工修改的策略被回写。最后采用该 Operator 自身的维护窗口和暂停副本流程。由 Operator 管理的 StatefulSet,应先确认其支持的升级方式。
8. 回滚再次停机
原文称新版本出现问题后,回滚又触发了一次整体重建;后续为关键服务建立独立 StatefulSet 的蓝绿切换方案,减少对重建回滚的依赖。这是作者的处理方案,仍需按应用核对数据同步、切换和恢复条件。
9. 误删 StatefulSet 后丢失 PVC
作者称执行 kubectl delete sts 时未加 --cascade=false,PVC 随之回收,并建议使用 --cascade=orphan 或确认卷回收策略。核验说明:删除 StatefulSet 并不必然删除 PVC,默认 PVC 保留策略为 Retain;是否回收需检查实际保留策略和 ownerReferences。--cascade=orphan 与 PV 的 Retain 控制不同对象,不能把其中一项当成完整的数据保护保证。
10. 把重建当成清空节点
作者称手动删除序号 2 的 Pod 后,新 Pod 复用了序号和旧 PVC,出现其所称的“数据串台”。核验说明:复用同序号的 PVC 是正常行为,删除 Pod 不会自动改变序号或重置数据。若目标是清空节点或重新分配数据,应走应用明确支持的流程。
11. 未就绪 Pod 收到请求
原文称新 Pod 已 Running、readiness 尚未通过,EndpointSlice 已更新并收到流量,建议加强 readiness、客户端连接重试和控制器同步检查。核验说明:EndpointSlice 中出现地址不等于它已是可接收流量的后端,需检查 conditions.ready、实际流量路径以及 Service 的 publishNotReadyAddresses;该字段为 true 时,端点的 ready 会被视为 true。见官方 EndpointSlice 条件说明。
原文 Redis Cluster 迁移案例与适用边界
作者给出一个包含 redis-cluster-0/1/2 的三节点 Redis Cluster 案例。原文称默认更新按 0→1→2 进行,混合版本期间因槽位迁移出现 MOVED 重定向增多,客户端错误率短时翻倍。核验说明:默认 RollingUpdate 的顺序是从高序号到低序号,3 副本对应 2→1→0。
案例的流程如下:
-
把策略改为 Recreate,并将
partition设为 2。作者称只有 2 号 Pod 重建,随后用redis-cli cluster nodes检查拓扑、比对数据哈希,再观察 5 分钟客户端错误率;同时称离线节点的槽位由 0、1 号节点接管。 -
将分区降为 1,重建 1 号并重复校验。作者称这一阶段短暂只有 0、2 号在线,且没有新旧版本并存带来的槽位冲突。
-
将分区降为 0,最后重建 0 号。作者称迁移在低峰完成,全程没有新旧混跑,客户端报错峰值比过去低约 70%。
案例不能作为当前 Recreate 的操作依据
上述分区过程不符合 Recreate 的 API 约束和全量重建语义;若实际使用的是 RollingUpdate 分区灰度,低序号旧版本与高序号新版本会暂时共存。原文未提供主从角色、replica 布局、槽位分配和测量依据,无法据此确认槽位接管过程或约 70% 的改善。Redis Cluster 的自动故障转移依赖可提升的 replica 及多数 master 的投票,不能仅凭“三节点”推定另外两个节点会自动接管槽位。见 Redis Cluster 官方规范。
作者列出的迁移前准备仍可作为检查线索:核对卷回收策略并准备最近快照;确认 readiness 反映数据已加载、应用可以工作;在预发环境用相同拓扑演练,记录各阶段耗时。案例中的 5 分钟观察和前面三阶段流程中的至少 10 分钟,是原文不同流程的观察时间,不能作为通用发布阈值。
原文的回滚方案是把镜像 tag 改回旧版,再走分区灰度,并指出整体重建可能再次中断服务;核心服务则考虑独立 StatefulSet 的蓝绿切换。需要分清:修改模板、分区灰度和整体重建是不同步骤,Recreate 不能依靠 partition 完成回滚。
上线前检查
整体重建避免的是同一 StatefulSet 内新旧 Pod 修订版本并存,不能修复应用的数据格式不兼容。按原文建议,应先在预发验证新版本能否读取旧版本写入的数据;必要时先迁移数据格式,再升级应用。
- 确认 Kubernetes 版本及两个控制面组件的
StatefulSetRecreateStrategy配置,先在非核心环境验证实际更新行为。 - 根据应用的混合版本兼容性选择策略:需要分区灰度时使用 RollingUpdate;整体重建时安排业务低峰、停机窗口、前端降级或重试。
- 检查实际 PVC/PV、StorageClass、PVC 保留策略和卷回收策略,准备快照或备份;日常更新通过 Pod 模板变更完成,避免把删除整个 StatefulSet 当作普通升级。
- 验证启动依赖、init/sidecar 的配置加载、readiness 和客户端重试;强依赖顺序的应用应评估 OrderedReady。
- 确认 Operator 不会回写更新策略,核对其维护窗口或暂停副本流程。
- 校验集群成员、持久化恢复和应用数据;灰度流程监控 P99 与错误率,并保留人工放行步骤。
- 演练数据格式迁移和回滚,明确是否需要独立 StatefulSet 的切换方案。
- 对 Pod 删除/创建事件配置告警,持续监控 PVC 状态,确认存储仍在位。
文中的机制说明可用于设计实验;事故记录没有完整配置、事件与测量数据,不能据此保证同一操作会在其他集群产生相同结果。本文示例尚未进行集群运行验证。