K8s API Server:请求链路、认证授权与生产调优
运行 kubectl apply 后,终端可能返回 Unauthorized、Forbidden、Webhook 超时,也可能已经创建对象但迟迟看不到 Pod 就绪。这些现象对应不同阶段:API Server 处理请求和持久化对象,控制器、调度器与 kubelet 再异步推进运行状态。
本文沿着一个对象写入请求解释认证、授权、准入和 Watch,然后讨论扩展 API、容量与排障。阅读前应了解 Pod、Deployment 和 etcd 的基本职责。示例参数、监控阈值和地址用于解释配置,不能直接作为生产调优结论;具体字段和指标应先与自己的 Kubernetes 版本核对。
一、先用故障现象定位处理阶段
API Server 相关故障常见于几个位置:请求连不上时检查入口、TLS 和实例健康;返回 401/403 时区分身份与权限;提示 Webhook 错误时检查准入链路;List 变慢或内存增长时,再分析请求量、对象规模、缓存与 etcd 延迟。
某个控制器频繁执行全量 List、Webhook 不可用、控制平面维护时流量集中到单个实例,都可能造成 API 访问异常。不过 API Server 暂时不可用通常不会立即停止已经运行的业务容器;它首先影响新的调度、控制器调谐和配置变更,业务是否中断取决于应用与控制平面的依赖。
二、API Server 的核心定位
kube-apiserver 为 Kubernetes 资源提供统一 API。kubelet、调度器和控制器通常通过它读写 API 对象,API Server 再访问 etcd。etcd 是存储后端,不是通过 API Server 读取自己状态的客户端;聚合 API 也可能使用独立存储。
从一次资源请求来看,它承担以下职责:
| 职责 | 说明 |
|---|---|
| 认证(Authentication) | 验证请求方身份(谁在操作?) |
| 授权(Authorization) | 校验权限(你有没有资格这样做?) |
| 准入控制(Admission) | 对象变更前的最后一道门(这个操作合规吗?) |
| 序列化/反序列化 | JSON ↔ Protobuf ↔ 内部对象的格式转换 |
| etcd 存储 | 将对象序列化后持久化,并维护 ResourceVersion |
| Watch 机制 | 通过长连接推送增量变更 |
| 聚合层(Aggregation Layer) | 通过 APIService 代理扩展 API Server;CRD 由另一套机制提供 |
三、一个请求的完整生命周期
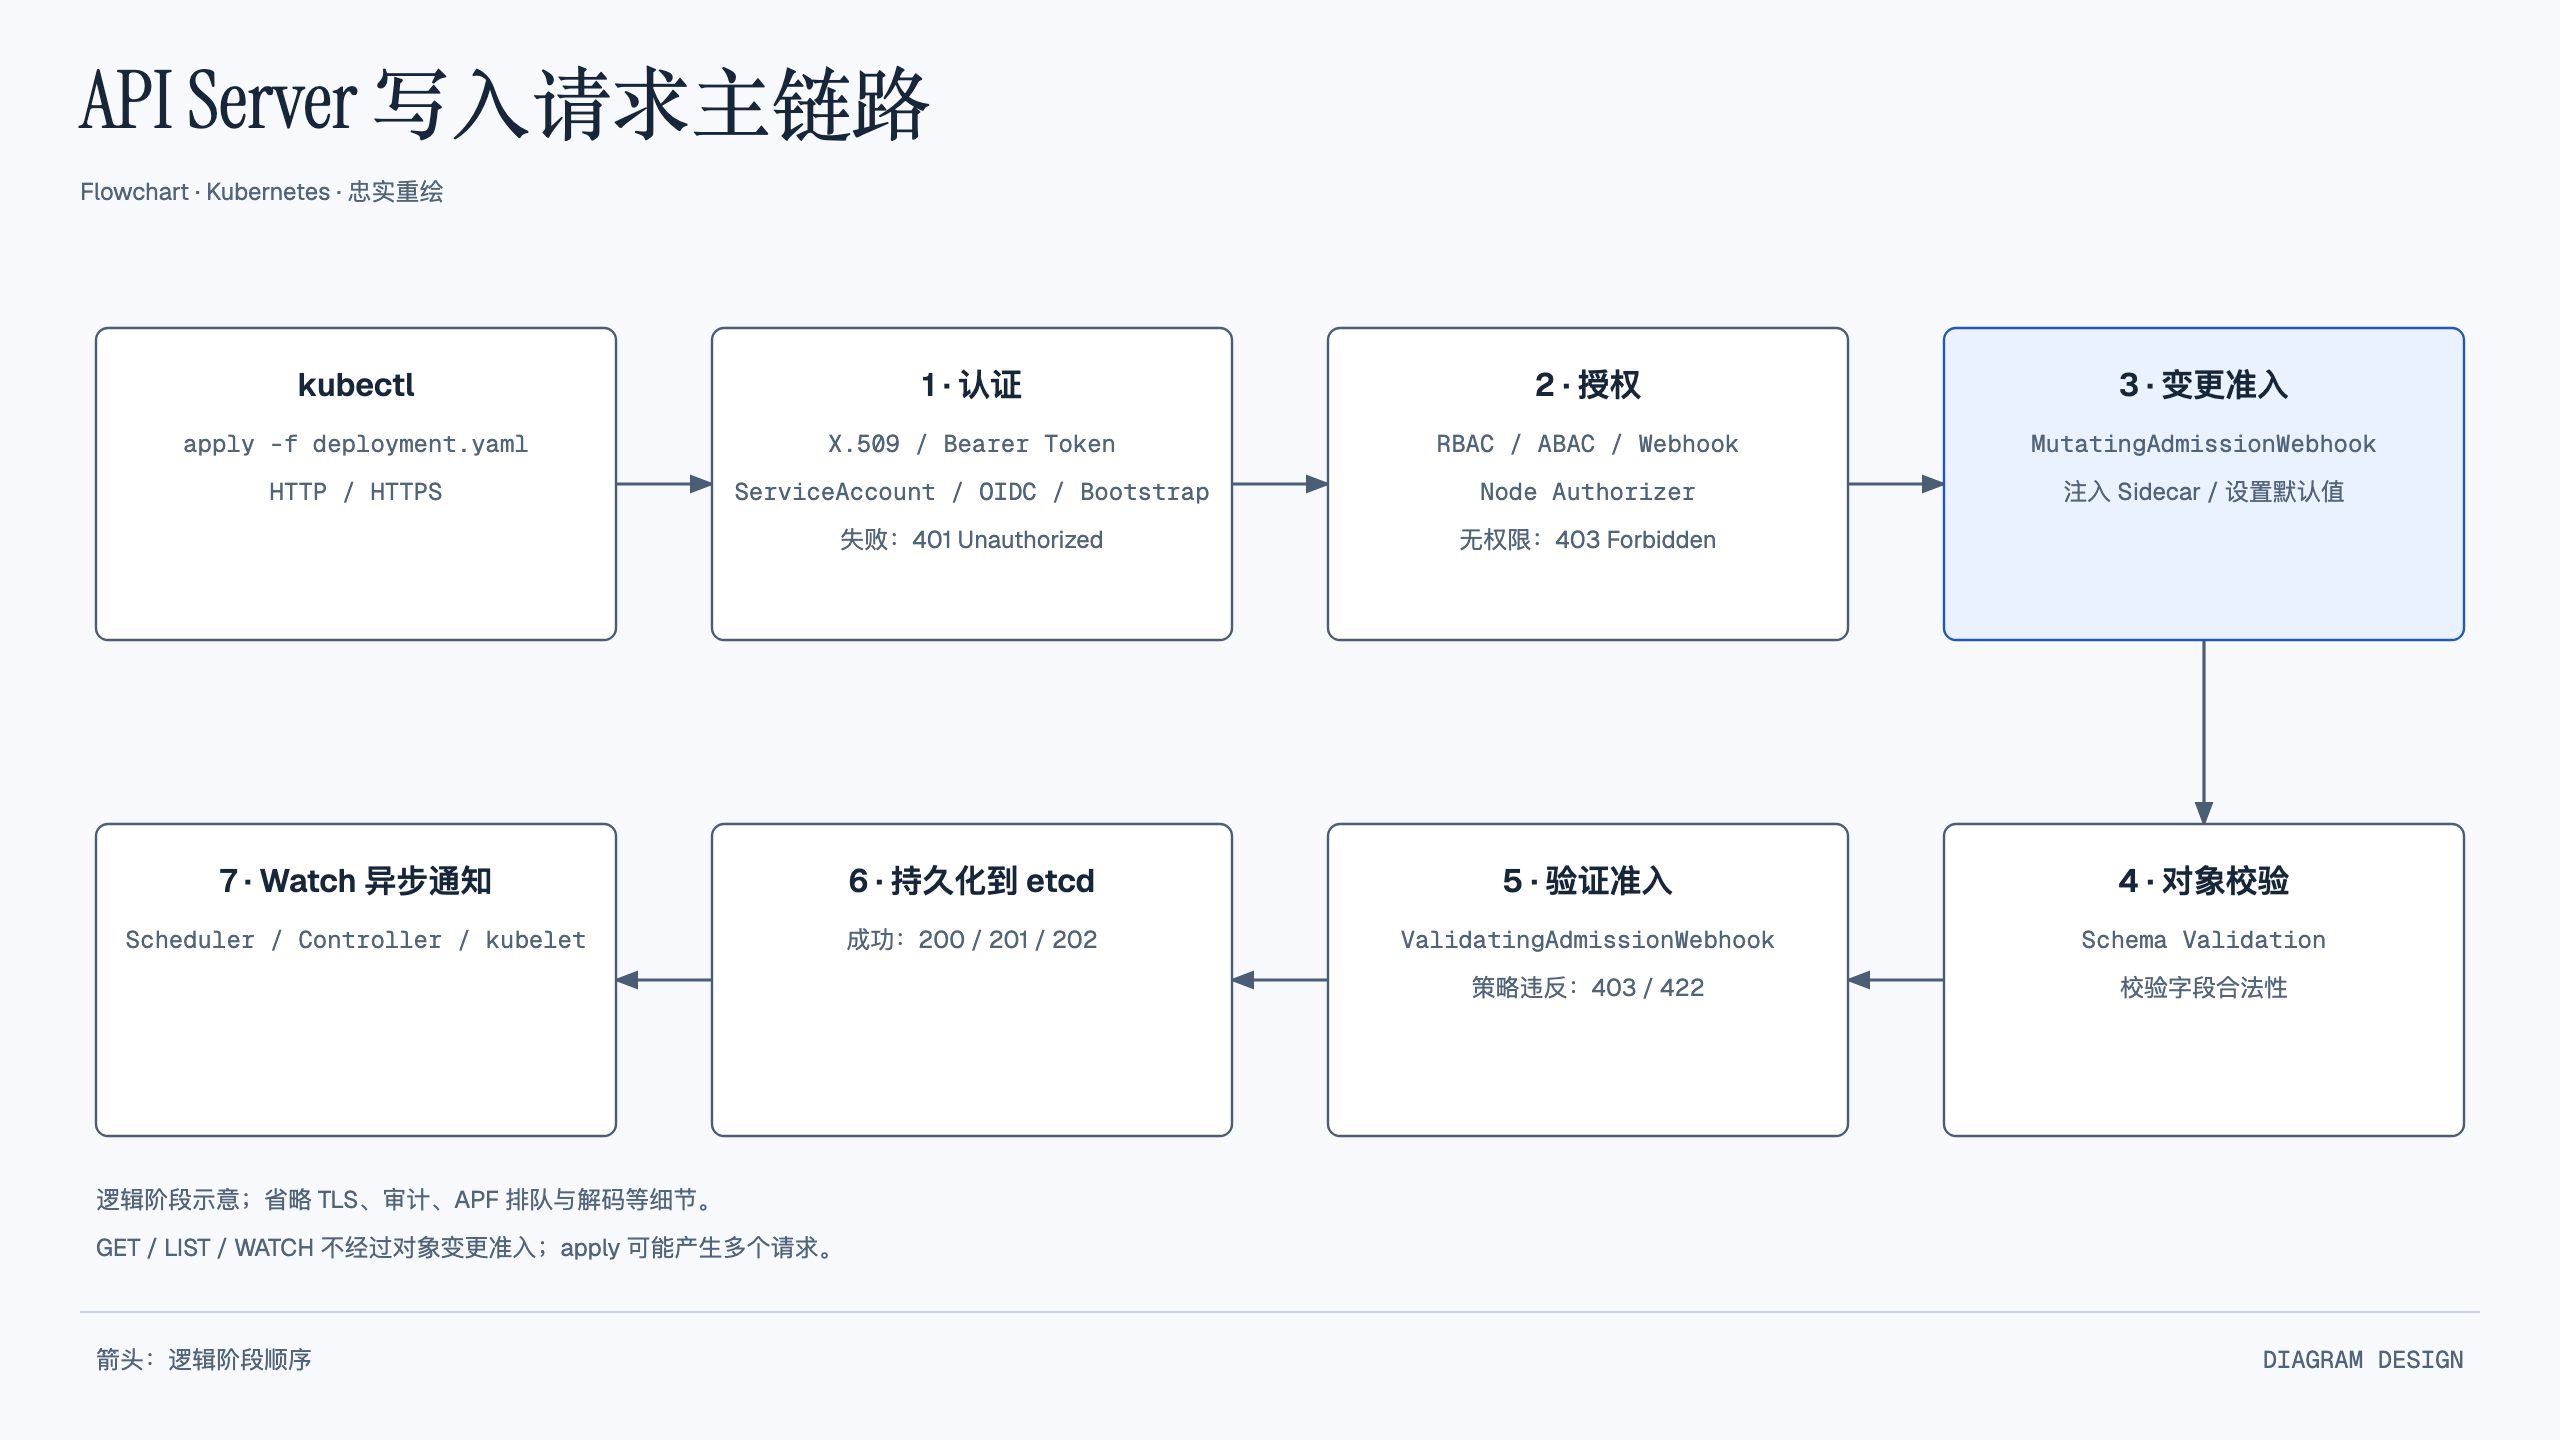
3.1 以写入对象为例梳理主链路
下图省略了 TLS、审计、API Priority and Fairness(APF)排队以及解码/默认值等细节,重点展示写入的逻辑阶段。GET、LIST、WATCH 不经过对象变更准入;apply 也可能产生读取与 PATCH 等多次请求。
3.2 认证:你是谁?
API Server 可以配置多种认证器。成功认证后得到用户名、组等身份信息,后续授权使用这些属性;多个认证器的组合和失败处理由配置决定,不能理解为任意失败凭据都能被其他身份无条件兜底。常见方式如下。
X.509 客户端证书
kubeconfig 可以内嵌客户端证书,也可以引用证书文件或使用 exec 凭据插件。证书认证时,API Server 验证证书链,通常从 CN 提取用户名、O 提取组。kubelet 的 TLS Bootstrap 先使用引导凭据申请证书,后续才以节点证书访问。下面的检查命令只适用于内嵌证书的 kubeconfig。
# 查看 kubectl 当前使用的证书信息
kubectl config view --minify --raw | grep client-certificate-data | \
  awk '{print $2}' | base64 -d | openssl x509 -noout -subject -dates
ServiceAccount Token
Pod 中应用通常通过 ServiceAccount 访问 API。投射式、绑定 Pod 的短期 token 机制在 1.22 稳定,由 kubelet 获取并轮换;1.24 起默认不再自动为每个 ServiceAccount 创建旧式长期 token Secret。可对照官方ServiceAccount 管理说明。
# Pod 内 Token 挂载路径(自动注入)
/var/run/secrets/kubernetes.io/serviceaccount/token

# 验证 Token 有效性
kubectl exec mypod -- sh -c '
  curl --cacert /var/run/secrets/kubernetes.io/serviceaccount/ca.crt \
    -H "Authorization: Bearer $(cat /var/run/secrets/kubernetes.io/serviceaccount/token)" \
    https://kubernetes.default.svc/api/v1/namespaces/default/pods
'
OIDC(OpenID Connect)
OIDC 可用于对接 Dex、Keycloak 或 Microsoft Entra ID 等身份系统。下面是传统启动参数片段,issuer、client ID 与 claims 必须和实际身份提供方匹配,并设置合适的用户名/组前缀避免身份冲突:
# API Server 启动参数
--oidc-issuer-url=https://dex.example.com
--oidc-client-id=kubernetes
--oidc-username-claim=email
--oidc-groups-claim=groups
Webhook Token 认证
将 Token 发送到外部服务验证,适合自定义认证系统。
3.3 授权:你能做什么?
RBAC 根据身份、请求动作、API 组、资源或 URL 判断是否允许访问。一个用户可能同时从多个绑定获得权限,RBAC 规则只有允许项,没有显式拒绝项。
Subject(谁)+ Verb(做什么)+ Resource(对什么)= 是否存在匹配的允许规则
下面分别定义命名空间内 Pod 读取权限与集群 Node 读取权限。定义角色不会自动授权,还需要 RoleBinding 或 ClusterRoleBinding。
# Role:命名空间级权限
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  namespace: production
  name: pod-reader
rules:
- apiGroups: [""]
  resources: ["pods"]
  verbs: ["get", "watch", "list"]
  # resourceNames: ["specific-pod"]  # 可精细到具体资源名

---
# ClusterRole:集群级权限
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  name: node-reader
rules:
- apiGroups: [""]
  resources: ["nodes"]
  verbs: ["get", "list", "watch"]
- nonResourceURLs: ["/healthz", "/metrics"]
  verbs: ["get"]
* 会覆盖相应维度的未来资源或动作,应优先写明确规则。ClusterRole 是规则的集群级定义,用 RoleBinding 引用时仍只作用于绑定所在命名空间内可授权的资源;集群级资源和非资源 URL 则需要 ClusterRoleBinding。
# 检查当前用户是否允许执行某项操作
kubectl auth can-i create deployments --namespace production
kubectl auth can-i '*' '*' --all-namespaces  # 仅检查该宽泛请求,不等于完整权限审计

# 列出某个 ServiceAccount 的所有权限
kubectl auth can-i --list --namespace production \
  --as=system:serviceaccount:production:myapp
3.4 准入控制:检查准备写入的对象
通过认证与授权后,写入请求还需经过准入。变更准入可以修改对象,验证准入检查最终对象并决定是否接受。准入既有内置插件,也有外部 Webhook;并不是每个插件都通过网络回调实现。
典型应用场景:
| 场景 | Webhook 类型 | 操作 |
|---|---|---|
| Istio Sidecar 注入 | Mutating | 自动添加 istio-proxy 容器 |
| OPA/Gatekeeper 策略 | Validating | 拒绝不合规资源 |
| 设置默认 resource limits | Mutating | 填充未指定的 CPU/Memory limits |
| 镜像来源白名单 | Validating | 拒绝使用非私有仓库镜像 |
下面展示验证 Webhook 的注册字段。这里不包含 Webhook Deployment、Service 和 TLS 证书;CA 也必须替换为真实值,不能直接应用占位符。
apiVersion: admissionregistration.k8s.io/v1
kind: ValidatingWebhookConfiguration
metadata:
  name: pod-policy
webhooks:
- name: pod-policy.example.com
  admissionReviewVersions: ["v1"]
  clientConfig:
    service:
      name: policy-webhook
      namespace: kube-system
      path: "/validate-pods"
    caBundle: <base64-encoded-CA>
  rules:
  - apiGroups: [""]
    apiVersions: ["v1"]
    operations: ["CREATE", "UPDATE"]
    resources: ["pods"]
  sideEffects: None
  failurePolicy: Fail  # 匹配请求在调用失败时按此策略处理
  timeoutSeconds: 10
  namespaceSelector:
    matchExpressions:
    - key: webhook-policy
      operator: NotIn
      values: ["disabled"]
    - key: kubernetes.io/metadata.name
      operator: NotIn
      values: ["kube-system"]
failurePolicy: Fail 会拒绝匹配该 Webhook 的请求,影响范围由 rules 和 selectors 决定。只检查 webhook-policy 标签不会自动排除 kube-system,所以配置还使用命名空间名条件限定范围。还需避免拦截 Webhook 自身恢复所需的资源,并评估多副本、超时与故障恢复。Ignore 则会在调用失败时放行匹配请求,意味着暂时失去该项策略检查。
四、用 Watch 持续观察资源变化
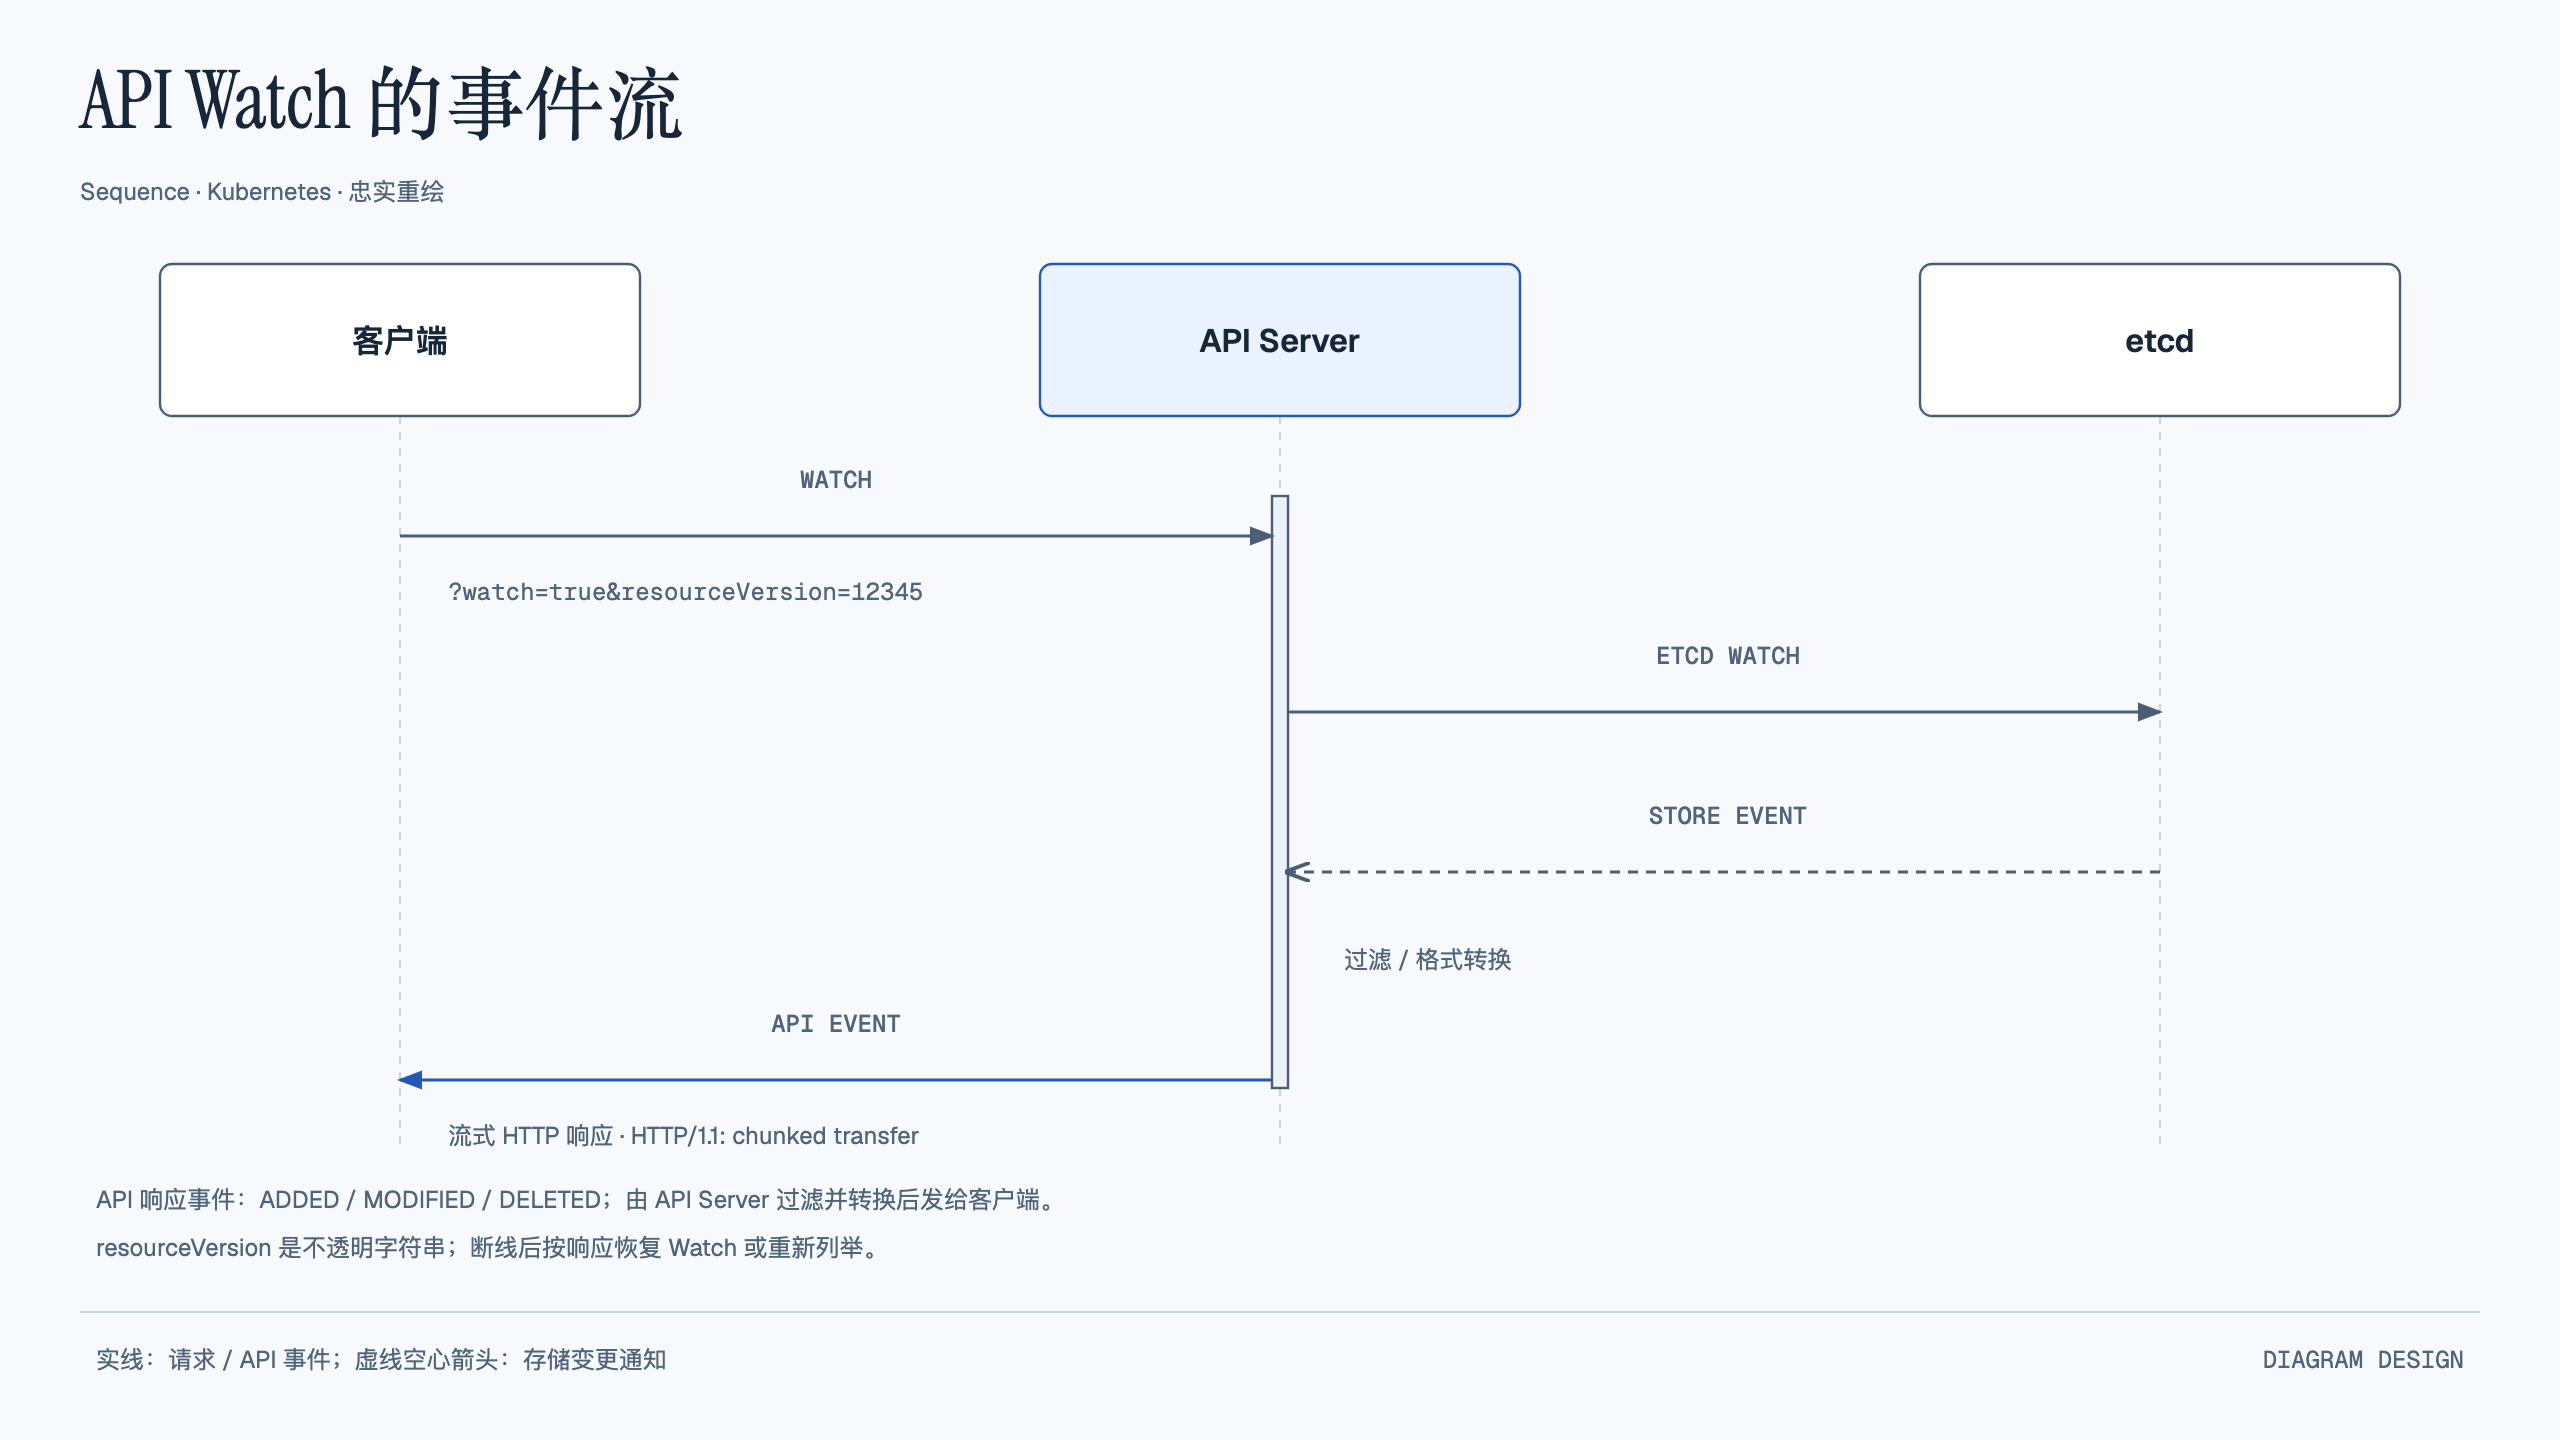
4.1 从初始列表衔接到增量事件
Watch 使用长连接传递资源变更。客户端通常先获取列表与 resourceVersion,再从该版本衔接增量事件;断线或版本过旧时,需要按 API 返回结果恢复连接或重新列举。
实际工作方式:
关键点:
- resourceVersion 是不透明字符串,客户端用于衔接列表和 Watch,不应把它当作所有存储后端都能比较大小的 etcd revision。
- Watch cache 可在 API Server 内缓存资源事件,减少下游连接对 etcd 的压力。是否启用和可用的读取语义与版本、资源及请求参数有关,不是所有资源永远都在缓存中。
- 客户端可请求 BOOKMARK 事件来推进已观察版本,但服务器不保证固定发送周期;它也不能保证永远不需要重新 List。
4.2 让 Informer 维护本地缓存
Controller 开发中最容易犯的错误:
// 反例:每5秒请求全量List,反复传输与解码全部对象;不保证每次直接读etcd
for {
    pods, _ := clientset.CoreV1().Pods("").List(ctx, metav1.ListOptions{})
    process(pods)
    time.Sleep(5 * time.Second)
}

// ✅ 正确:使用 Informer,底层是 List+Watch+本地缓存
factory := informers.NewSharedInformerFactory(clientset, 0)
podInformer := factory.Core().V1().Pods()
podInformer.Informer().AddEventHandler(cache.ResourceEventHandlerFuncs{
    AddFunc:    onAdd,
    UpdateFunc: onUpdate,
    DeleteFunc: onDelete,
})
factory.Start(stopCh)
factory.WaitForCacheSync(stopCh)
上面的代码是结构片段,省略了 clientset、ctx、处理函数和 stopCh 的初始化。实际程序需要处理注册错误,并确认缓存同步成功后再启动依赖缓存的工作线程。SharedInformer 的主要组成如下:
- Reflector:执行 List+Watch,将事件放入 Delta FIFO Queue
- DeltaFIFO Queue:按对象键累积变化,可能重同步或重复通知;业务处理必须幂等
- Indexer(LocalStore):支持本地索引与查询。只有通过 lister/cache 的读取走本地缓存,直接调用 clientset 仍会发送 API 请求
五、API 扩展机制
5.1 CRD(CustomResourceDefinition)
apiVersion: apiextensions.k8s.io/v1
kind: CustomResourceDefinition
metadata:
  name: databases.mycompany.com
spec:
  group: mycompany.com
  versions:
  - name: v1
    served: true
    storage: true
    schema:
      openAPIV3Schema:
        type: object
        properties:
          spec:
            type: object
            required: ["engine", "size"]
            properties:
              engine:
                type: string
                enum: ["mysql", "postgres", "redis"]
              size:
                type: string
                pattern: "^[0-9]+(Gi|Mi)$"
    additionalPrinterColumns:
    - name: Engine
      type: string
      jsonPath: .spec.engine
    - name: Age
      type: date
      jsonPath: .metadata.creationTimestamp
  scope: Namespaced
  names:
    plural: databases
    singular: database
    kind: Database
    shortNames: ["db"]
CRD 注册后,API Server 自动提供下面的通用能力。数据库部署、备份或恢复逻辑仍需由独立 Controller 实现,单独注册此 CRD 不会创建数据库:
- REST CRUD 接口:
/apis/mycompany.com/v1/namespaces/{ns}/databases - Watch 支持
- RBAC 集成
- etcd 持久化
5.2 聚合 API Server(Aggregation Layer)
当 CRD 无法满足需求时(如自定义子资源、特殊存储后端),可部署独立的扩展 API Server:
apiVersion: apiregistration.k8s.io/v1
kind: APIService
metadata:
  name: v1beta1.metrics.k8s.io
spec:
  service:
    name: metrics-server
    namespace: kube-system
    port: 443
  group: metrics.k8s.io
  version: v1beta1
  insecureSkipTLSVerify: false
  caBundle: <base64-CA>
  groupPriorityMinimum: 100
  versionPriority: 100
kubectl top pods 背后就是通过 Aggregation Layer 调用 metrics-server 的。
六、生产环境优化与调优
6.1 先观察请求与排队,再决定是否调参
下面用一组示例参数解释各项控制面设置;数值需要由本集群的负载测试确定。先确认当前二进制支持的参数、APF 配置、请求类型和 etcd 容量,再在压测中评估变化。
# 参数示意;每个 API Server 实例独立生效,须先做负载测试
--max-requests-inflight=800          # 关闭APF时限制非变更请求;启用APF时参与总并发预算
--max-mutating-requests-inflight=400  # 关闭APF时限制变更请求;启用APF时参与总并发预算
--request-timeout=60s                 # 请求超时(默认60s)
--min-request-timeout=1800            # Watch 请求最小超时(默认1800s)
--etcd-compaction-interval=5m         # etcd 压缩间隔
# 历史参数 --target-ram-mb=4096 不在当前参数参考中;不能作为可用调优项添加
API Priority and Fairness(APF)启用时,上面两个 inflight 值相加形成并发预算,再按优先级分配 seats,并不是分别限制读写两个池子。watch 的初始处理也受 APF 影响,执行命令等部分长连接则有例外。只增加预算可能让 etcd 和 Webhook 承受更大压力。参数应以对应版本的 kube-apiserver 参数参考 为准。
下面列出一组粗略的内存估算区间,用于启动容量评估。它不是 Kubernetes 官方按节点数给出的保证,也不应直接作为 requests/limits。对象数、对象大小、Watch 数量、CRD、审计和 List 峰值都可能让相同节点数产生不同用量。
| 集群规模 | 节点数 | API Server 内存建议 |
|---|---|---|
| 小型 | < 50 | 2-4 GB |
| 中型 | 50-500 | 4-8 GB |
| 大型 | 500-3000 | 8-16 GB |
| 超大型 | > 3000 | 16-32 GB |
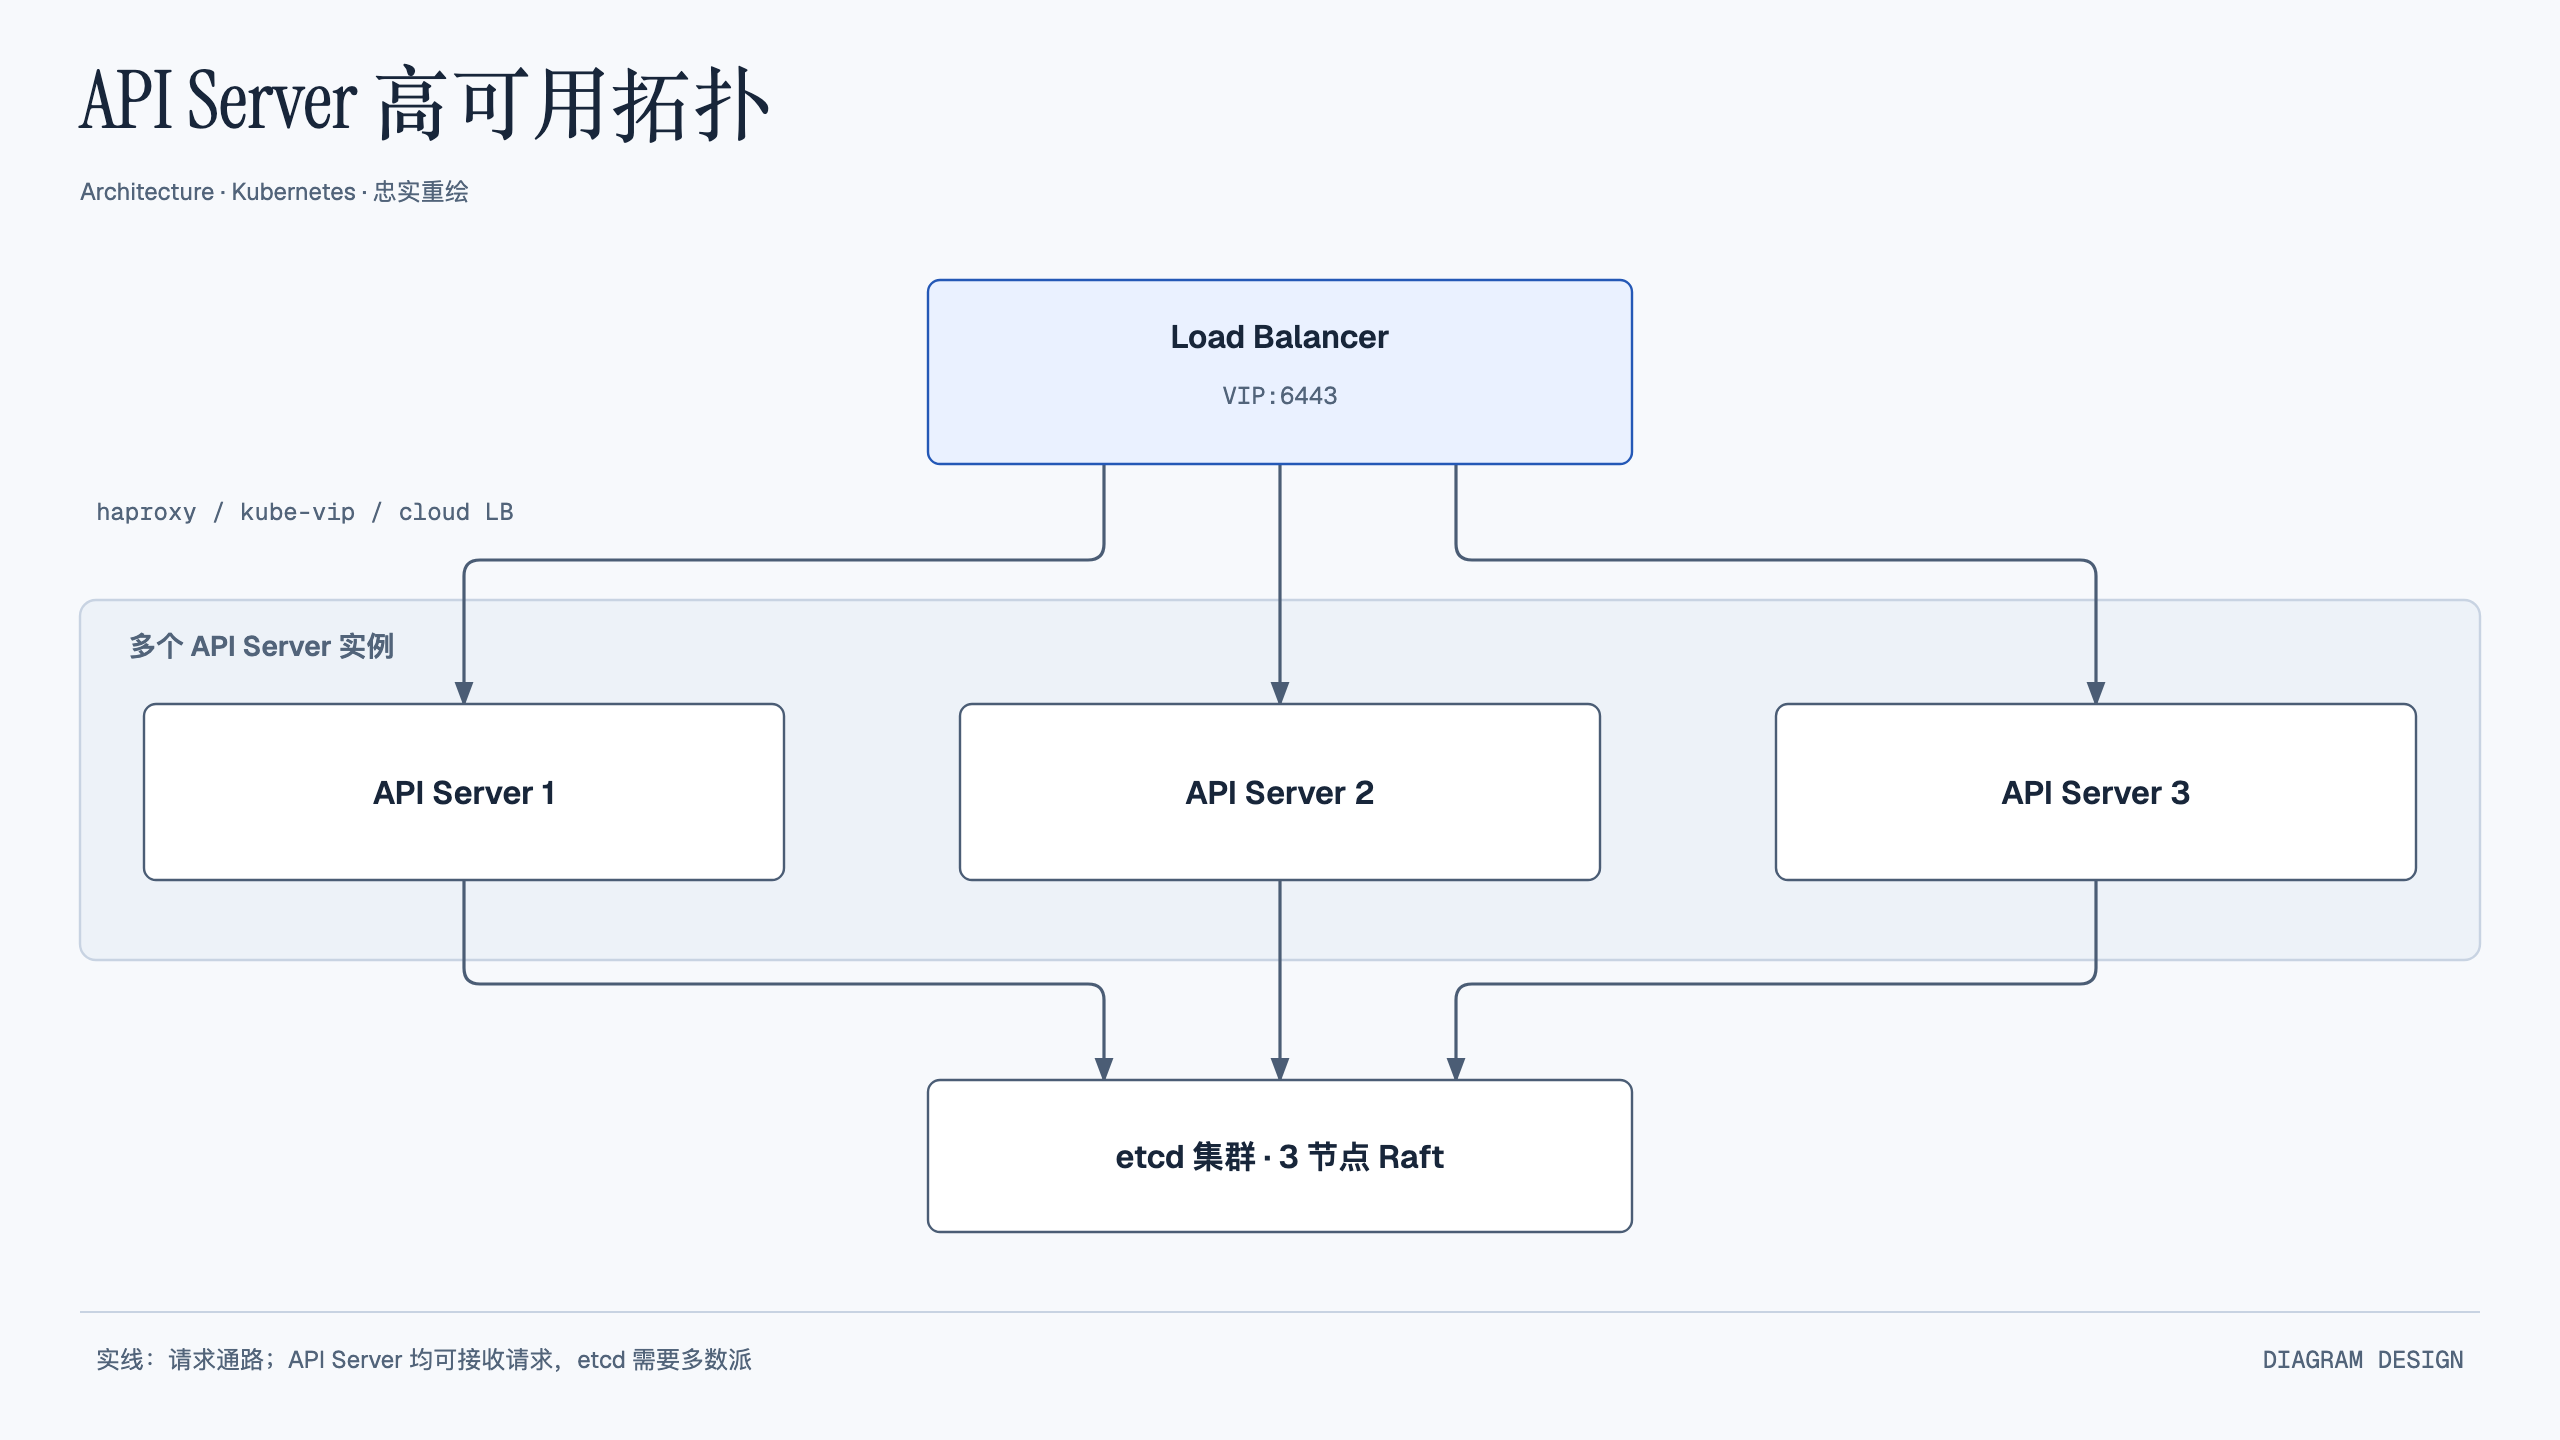
6.2 高可用部署
需要容忍控制平面实例故障时,可部署多个 API Server 并通过负载均衡提供入口。下图以 3 个实例、3 节点 etcd 为例;API Server 无 leader 选举式的单主请求入口,etcd 则需要满足多数派。还需确认负载均衡健康检查、跨故障域分布以及维护期间的剩余容量。
6.3 审计日志配置
审计记录可以回答谁在何时对哪个资源做了什么。启用时需要评估敏感字段、日志留存、存储容量和审计本身的开销。审计策略 按顺序采用第一条匹配规则,规则并不是叠加记录。
# audit-policy.yaml
apiVersion: audit.k8s.io/v1
kind: Policy
rules:
# 忽略 kube-proxy 对指定资源的 watch 噪音
- level: None
  users: ["system:kube-proxy"]
  verbs: ["watch"]
  resources:
  - group: ""
    resources: ["endpoints", "services", "services/status"]

# 忽略认证用户对 API 发现和版本非资源 URL 的 GET;不匹配普通资源读取
- level: None
  userGroups: ["system:authenticated"]
  nonResourceURLs:
  - "/api*"
  - "/version"
  verbs: ["get"]

# 记录所有 Secret/ConfigMap 的写操作(Metadata级别不记录内容)
- level: Metadata
  resources:
  - group: ""
    resources: ["secrets", "configmaps"]
  verbs: ["create", "update", "patch", "delete"]

# Pod/Deployment 变更只记录元数据,避免请求体中的环境变量泄露
# 空 users 不表示“认证失败”;deployments 属于 apps 组
- level: Metadata
  resources:
  - group: ""
    resources: ["pods"]
  - group: apps
    resources: ["deployments"]
  verbs: ["create", "update", "patch", "delete"]

# 其余操作记录元数据
- level: Metadata
  omitStages:
  - RequestReceived
# API Server 启动参数
--audit-log-path=/var/log/kubernetes/audit.log
--audit-policy-file=/etc/kubernetes/audit-policy.yaml
--audit-log-maxage=30
--audit-log-maxbackup=10
--audit-log-maxsize=100静态 Pod 部署还需要把策略文件与日志目录挂载进 API Server,并配置日志采集。认证失败应从审计事件的 responseStatus.code 等字段分析;不能靠 users: [] 在策略中筛选。若确需 Request/RequestResponse 级别,先检查载荷是否含凭据或业务数据。
6.4 用可聚合的指标区分延迟、错误与排队
# API Server 请求延迟(P99)
histogram_quantile(0.99,
  sum by (le, verb, resource) (rate(apiserver_request_duration_seconds_bucket{
    verb!~"WATCH|CONNECT"
  }[5m]))
)

# 请求错误率
sum(rate(apiserver_request_total{code=~"5.."}[5m])) /
sum(rate(apiserver_request_total[5m]))

# etcd 请求延迟
histogram_quantile(0.99,
  sum by (le, operation) (rate(etcd_request_duration_seconds_bucket[5m]))
)

# Watch发送事件速率,不是Controller积压长度
sum(rate(apiserver_watch_events_total[5m]))

# 在途请求与APF排队/执行状态
apiserver_current_inflight_requests
apiserver_flowcontrol_current_inqueue_requests
apiserver_flowcontrol_current_executing_seats
直方图分位数应先按 le 与需要保留的维度聚合,再计算分位数。指标名称与标签随版本变化,先在实际 /metrics 核实,尤其注意 alpha 指标;指标定义可查官方指标参考。以下 5%、3 秒和 1 分钟阈值只是演示,应按基线与 SLO 调整。
groups:
- name: kube-apiserver
  rules:
  - alert: KubeAPIServerHighErrorRate
    expr: |
      sum(rate(apiserver_request_total{code=~"5.."}[5m])) /
      sum(rate(apiserver_request_total[5m])) > 0.05
    for: 5m
    labels:
      severity: critical
    annotations:
      summary: "API Server 错误率超过 5%"

  - alert: KubeAPIServerSlowRequests
    expr: |
      histogram_quantile(0.99,
        sum by (le) (rate(apiserver_request_duration_seconds_bucket{
          verb!~"WATCH|CONNECT",subresource!="log"
        }[5m]))
      ) > 3
    for: 10m
    labels:
      severity: warning
    annotations:
      summary: "API Server P99 延迟超过 3s"

  - alert: KubeAPIServerAPFQueueWait
    expr: |
      histogram_quantile(0.99,
        sum by (le, priority_level) (rate(
          apiserver_flowcontrol_request_wait_duration_seconds_bucket[5m]
        ))
      ) > 1
    for: 5m
    labels:
      severity: warning
    annotations:
      summary: "API Server APF 排队P99超过1秒"
七、将指标与现场证据对应起来
7.1 API Server 无响应时先检查入口与实例
下面路径是 kubeadm 自建控制平面的示例,托管集群通常需要从平台监控或控制平面日志获取证据。若 API Server 已不可用,kubectl logs 也可能失败,此时改用节点上的 crictl logs 等容器运行时工具。
# 1. 检查 etcd 健康状态(API Server 强依赖 etcd)
ETCDCTL_API=3 etcdctl \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key \
  endpoint health

# 2. 检查 API Server 日志
kubectl logs -n kube-system kube-apiserver-$(hostname) --tail=100

# 3. 直接访问 API Server 健康检查
curl -k https://localhost:6443/healthz
curl -k https://localhost:6443/readyz
curl -k https://localhost:6443/livez

# 4. 检查证书是否过期
openssl x509 -in /etc/kubernetes/pki/apiserver.crt -noout -enddate
kubeadm certs check-expiration
7.2 Webhook 故障时先确认匹配范围
下面 patch 会暂时放宽策略,不是只读排障。只有确认故障 Webhook、索引和影响范围,并接受该窗口内策略失效后才使用;保存原配置并在恢复服务后改回。多个 Webhook 条目需分别核实,不能假定问题总在索引 0。
# 现象:所有 Pod 创建失败,报 Webhook 相关错误
# 紧急恢复步骤:

# 1. 找到问题 Webhook
kubectl get validatingwebhookconfigurations
kubectl get mutatingwebhookconfigurations

# 2. 临时禁用(修改 failurePolicy 为 Ignore)
kubectl patch validatingwebhookconfiguration <name> \
  --type='json' \
  -p='[{"op":"replace","path":"/webhooks/0/failurePolicy","value":"Ignore"}]'

# 3. 排查 Webhook 服务
kubectl get pods -n <webhook-namespace>
kubectl logs -n <webhook-namespace> <webhook-pod>
7.3 Watch 数量增长时如何寻找客户端
# 查看当前 Watch 连接数
kubectl get --raw /metrics | grep apiserver_longrunning_requests

# 按指标标签粗看活跃Watch分布;该指标不包含单条请求起始时间
kubectl get --raw /metrics | grep apiserver_longrunning_requests | \
  grep -i watch | head -20

# 检查是否有 Controller 没有正确 Cancel Context
# user-agent通常需要从审计日志或请求日志定位,不在这个Gauge中
八、把排障结果落实到具体请求
认证失败时检查凭据来源与有效期,授权失败时检查身份组、绑定范围和子资源;准入失败则看匹配的插件或 Webhook。对象已经写入但应用未就绪时,继续沿着 Controller、Scheduler 与 kubelet 排查,避免把所有延迟都归因于 API Server。
容量问题需要同时观察请求速率、响应体规模、APF 排队、Webhook 延迟和 etcd 健康。先定位主要消耗者,再验证限制客户端请求、缩小 List 范围或增加控制平面容量的效果。每次变更都保留前后指标与回滚配置,参数值才有可复用的依据。