Kafka:入门、生产配置与 Kubernetes 排障
Kafka 的入门和运维需要连起来理解:Topic、分区和消费组决定数据如何流动,副本和写入确认决定故障时能保住哪些数据,存储、网络与元数据服务则决定集群能否稳定运行。
本文整理这些通用知识,以及旧版 Kafka + ZooKeeper 迁入 Kubernetes 后的排障方法。Strimzi Operator、Helm Chart、KafkaNodePool、TLS、ACL 和 Kafka UI 的部署步骤见 Helm 部署 Strimzi Kafka。
版本范围
Kafka 2.8 引入了早期 KRaft 模式,3.3 起达到生产可用阶段,4.0 起移除了 ZooKeeper 模式。下文 ZooKeeper 章节用于维护仍依赖它的旧集群;KRaft 集群应检查 Controller 仲裁、元数据日志和 Broker 状态,无需部署 ZooKeeper。Kafka 4.0 升级说明
Kafka 入门
解决什么问题
Apache Kafka 是分布式事件流平台,可以发布和订阅事件、持久保存事件,并供实时或后续处理。常见用途包括系统间异步解耦、流量削峰、日志缓冲、数据管道和事件驱动业务,也常与 Flink、Spark 等流处理系统配合使用。Kafka 官方介绍
跨团队、跨系统的数据交互,如果调用量小且需要同步结果,普通 API 往往更直接。需要应对流量波动、下游暂时不可用、独立扩缩容或历史重放时,可以考虑消息系统。选用 Kafka 还要评估消息模型、延迟、顺序要求和运维成本;数据量大并不意味着只有 Kafka 一种选择。
核心术语与数据流
| 术语 | 含义 | 运维时关注什么 |
|---|---|---|
| Event / Record | 一条事件记录,可包含 Key、Value、时间戳等信息 | 序列化格式、大小、业务唯一标识 |
| Topic | 事件的逻辑分类,例如 order-events | 保留策略、分区数、副本数和权限 |
| Partition | Topic 的分区,是有序追加日志 | 并发度、数据分布和单分区顺序 |
| Broker | 保存分区副本、处理生产和消费请求的服务节点 | 磁盘、网络、负载与副本分布 |
| Producer | 向 Topic 写入记录的客户端 | 分区选择、acks、重试和幂等性 |
| Consumer | 从分区拉取记录的客户端 | 处理速度、Offset 提交、错误处理 |
| Consumer Group | 使用同一 group.id 协同消费的一组客户端 | 分区分配、Rebalance 与消费积压 |
| Offset | 记录在某个分区内的位置 | 消费位置、提交位置和可重放范围 |
| Leader / Follower | 分区的主副本与跟随复制的副本 | Leader 分布、复制延迟和故障切换 |
| ISR | In-Sync Replicas,当前保持同步的副本集合,包含 Leader | ISR 是否收缩、是否低于 minISR |
典型数据流是 Producer → Topic 的某个 Partition → Consumer。不同 Partition 可以分布在不同 Broker 上;同一 Partition 的多个副本则分布到不同 Broker,以提供冗余。Kafka 核心概念
Kafka 保证分区内的记录顺序,不提供整个 Topic 的全局顺序。需要按订单、设备等业务对象保序时,应让同一对象的记录进入同一分区,并同时处理生产重试和消费端并发带来的顺序问题。
对于普通 Consumer Group,同一分区同一时刻由组内一个 Consumer 消费。一个 Topic 只有一个分区时,即使启动三个 Consumer,也可能只有一个获得分区;增加副本数不会增加消费并行度。不同消费组可以独立读取同一批记录。这里讨论普通消费组,不包括 Share Group 的共享消费模型。Kafka 设计:消费组
Offset、重复消费与重试
Consumer 的当前位置和已经提交的 Offset 是两回事。提交值通常表示下一条待消费的位置;客户端重启或分区重新分配后,会根据已提交的位置继续读取。记录是否删除由 Topic 保留和清理策略决定,消费成功不会立即删除它。Kafka 消费位置实现
常见重复消费路径包括:
- 业务处理已成功,但提交 Offset 前进程退出;恢复后再次处理同一条记录。
- Offset 提交失败或 Rebalance 后,新 Consumer 从上次成功提交的位置继续消费。
- 人工重置 Offset、应用主动回退位置,或业务层重投同一事件。
- Producer 重试时未启用幂等性,或应用自行再次发送同一业务事件。
生产重试和消费重试需要分别设计。Producer 幂等性用于消除其会话内重试造成的重复写入,不会自动去重应用重发,也不会阻止 Consumer 再次执行业务。消费端仍需利用业务唯一键、数据库约束等方式保证幂等;处理成功后提交 Offset,失败时决定原位重试、重试 Topic 或死信处理。Kafka 内部“消费 → 处理 → 再生产”的事务语义,还需要事务 Producer、消费位置原子提交及相应隔离级别,不能只靠 enable.idempotence=true。KafkaProducer 语义说明
ZooKeeper 与 KRaft
| 模式 | 元数据与协调方式 | 排障重点 |
|---|---|---|
| ZooKeeper 模式 | ZooKeeper 保存部分集群元数据并参与 Broker 注册、控制器选举等协调 | ZooKeeper 仲裁、会话、myid、事务日志与 Broker 连接 |
| KRaft 模式 | Kafka Controller 使用 Raft 元数据仲裁;Broker 处理消息数据 | Controller 多数派、元数据日志、Controller/Broker 通信与节点身份 |
KRaft 的 Controller 仲裁和业务 Topic 的 Leader/Follower 复制是两条不同链路。Controller 有多数派,不等于业务分区的副本都同步。生产规划通常分离 Controller 与 Broker;Controller 数量、Broker 数量、Topic 副本数也需要分别设计。KRaft 部署说明
Kafka 副本同步核心参数
副本数、ISR 与写入确认
| 参数 | 配置位置 | 作用与边界 |
|---|---|---|
| Replication Factor | 创建 Topic 时的 --replication-factor 等设置 | 一个分区的总副本数,包括 Leader;三副本需要至少三个可承载副本的 Broker |
default.replication.factor | Broker | 未明确指定时使用的默认副本数;修改它不会自动增加已有 Topic 的副本 |
min.insync.replicas | Broker 默认值 / Topic 覆盖值 | 使用 acks=all 时,成功确认写入所需的最小 ISR 数,包含 Leader |
acks=1 | Producer | Leader 写入本地日志后即可确认,不等待全部 Follower;Leader 过早故障时可能丢失已确认的记录 |
acks=all(或 -1) | Producer | 等待当前 ISR 中的副本确认;同时受 minISR 下限约束 |
unclean.leader.election.enable | Broker 默认值 / Topic 覆盖值 | 是否允许不满足正常安全选主条件的副本被选为 Leader;开启可能以数据丢失换取可用性 |
acks=all 中的“all”指当前 ISR,不是配置的全部副本,也不是达到 min.insync.replicas 后就立即返回。三副本、minISR 为 2,当前 ISR 有三个时,需要等三个;ISR 缩到两个时,需要等两个;ISR 再缩到一个时,要求 acks=all 的写入不能成功确认。仅把 minISR 改成 2,无法让使用 acks=1 的 Producer 获得同样的确认保证。Topic 配置说明、Producer 配置说明
这些确认也不等于每条消息都在每块盘上完成了一次物理 fsync。Kafka 的可靠性还依赖副本、存储和故障范围;副本不是备份,无法替代针对误删、保留策略错误或整个故障域损坏的恢复方案。
minISR 的可用性取舍
下面以三副本、acks=all、未启用非正常 Leader 选举为前提,只比较 ISR 缩减对继续写入的影响:
| minISR | 成功确认时至少需要的同步副本数 | 从三个 ISR 开始,最多减少多少个仍可满足写入下限 | 代价 |
|---|---|---|---|
| 1 | 1,可能只有 Leader | 2 | 仍可在单副本状态写入,后续该副本丢失时风险较高 |
| 2 | 2 | 1 | 常见的可靠性与写入可用性折中 |
| 3 | 3 | 0 | 任一副本退出 ISR 就会影响写入可用性 |
这不是“允许永久丢失多少份数据”的保证表。minISR 为 3 也不自动赋予端到端强一致或业务 Exactly Once。Kafka 4.x 的 ELR(Eligible Leader Replicas)还扩展了安全选主候选集合;启用后应结合目标版本核查 minISR、选主和配置变更规则。ELR 说明
Kafka 生产避坑:副本同步与云厂商默认配置陷阱
原记录中的事故与可确认的故障模式
原记录描述了一次凌晨故障:Topic 配置了三副本、min.insync.replicas=1,Producer 使用 acks=1;约 1:30,一个 Broker 因磁盘故障离线,之后出现消费异常。记录还提到“三个消费者只有一个在工作”和“其余副本未同步”,但没有附上完整 ISR、选主、消费组分配及数据核对证据,因此这些现象需要分别判断。
| 原记录中的配置 | 值 | 需要核对的含义 |
|---|---|---|
| 分区副本数 | 3 | 说明配置了三个副本,不代表三个始终都在 ISR 中 |
min.insync.replicas | 1 | 即使改用 acks=all,ISR 缩到一个时仍可成功确认写入 |
Producer acks | 1 | Leader 可先确认,不能据此证明 Follower 已复制这条记录 |
从配置可以推导出如下丢失风险:
- Producer 将记录写入 Leader,Leader 在 Follower 复制完成前返回成功。
- Leader 随即故障,缺少该记录的副本接管。
- Producer 认为成功的记录可能没有保留下来。
如果正常选主候选不可用,集群也可能先表现为分区不可用;开启非正常选主则可能选择落后副本并丢失数据。具体发生了哪条路径,仍需检查故障时的副本状态、选主记录和实际数据,不能只凭 minISR 为 1 就认定出现了“数据空洞”。
消费者空闲则应另查 Topic 分区数、组成员、分区分配、Rebalance 和业务处理速度。Consumer 数量与 Broker 副本数量没有一一对应关系。
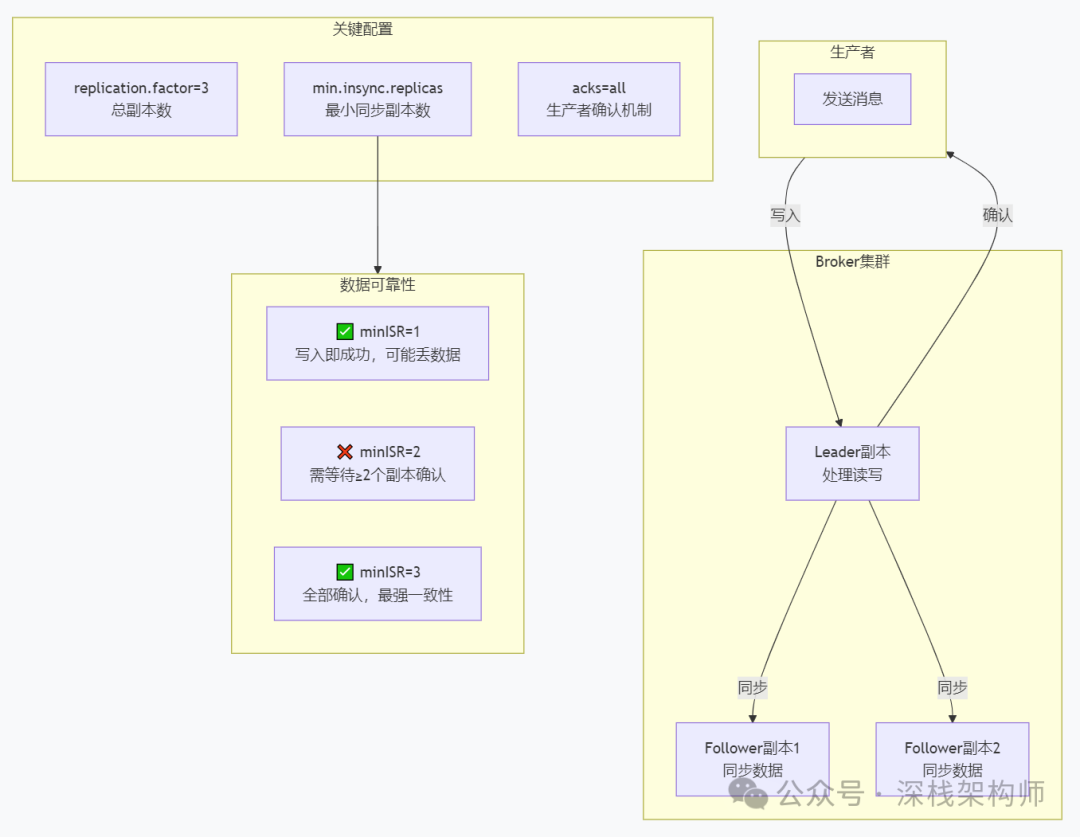
原图的阅读边界
原图保留了副本数、minISR 和
acks的关系示意,但左侧对 minISR 为 2 的叉号,以及“minISR 为 3 即最强一致性”的标注容易误导。配置含义和取舍以本节正文及上表为准。
检查实际生效配置
审查时同时核对 Broker 默认值、Topic 覆盖值和 Producer 配置。控制台的三个实例或三个副本标识,不能替代分区的实际 ISR;托管服务的默认值、限制和可修改项,也要按具体产品、规格与版本确认。
# 示例地址;有 TLS/SASL 时按客户端要求补充认证参数。
KAFKA_BOOTSTRAP='kafka-bootstrap.kafka.svc:9092'

# 查看 Leader、分区副本及 ISR。
kafka-topics.sh --bootstrap-server "$KAFKA_BOOTSTRAP" \
  --describe --topic order-events

# --all 用于连同默认值查看配置;以所用 CLI 版本支持为准。
kafka-configs.sh --bootstrap-server "$KAFKA_BOOTSTRAP" \
  --entity-type topics --entity-name order-events --describe --all

# 消费者空闲或积压时,独立查看消费组分配与 Lag。
kafka-consumer-groups.sh --bootstrap-server "$KAFKA_BOOTSTRAP" \
  --describe --group order-service
生产环境标准配置
生产基线与适用条件
下面是一套面向三副本、优先保护已确认数据的起点,需要结合负载、故障域和业务 RPO/RTO 调整。测试环境的单副本只适合验证功能;测试环境也应保持安全选主规则,避免把有风险的配置带入生产。
| 项目 | 单 Broker 开发环境示例 | 三副本生产基线 | 说明 |
|---|---|---|---|
| Topic 副本数 | 1 | 3 | 生产副本应分散到不同 Broker,并考虑节点与可用区 |
min.insync.replicas | 1 | 2 | 与 Producer 的 acks=all 配合 |
Producer acks | all | all | 单副本使用 all 仍只有一份数据 |
unclean.leader.election.enable | false | false | 数据优先的基线;灾难恢复中的取舍需单独决策 |
enable.idempotence | true | true | 限制 Producer 重试造成的重复写入 |
Broker 的关键参数示例:
default.replication.factor=3
min.insync.replicas=2
unclean.leader.election.enable=false
offsets.topic.replication.factor=3
transaction.state.log.replication.factor=3
transaction.state.log.min.isr=2
业务 Topic、消费位移内部 Topic 和事务状态内部 Topic 都要检查。副本因子不得超过可用 Broker 数;修改 Broker 默认值通常不会重建已经存在的内部 Topic 或业务 Topic 副本。已有 Topic 增加副本需要按对应版本执行副本重分配,不能只改默认参数。Broker 配置
创建 Topic
kafka-topics.sh --bootstrap-server "$KAFKA_BOOTSTRAP" \
  --create \
  --topic order-events \
  --partitions 6 \
  --replication-factor 3 \
  --config min.insync.replicas=2 \
  --config unclean.leader.election.enable=false
六个分区只是示例,应按吞吐、消费并行度和顺序要求规划。现代管理命令使用 --bootstrap-server;旧笔记中的 --zookeeper localhost:2181 不适用于这里的命令。创建后应再次 --describe,检查副本分布和 ISR。
Java Producer 配置
Properties props = new Properties();
props.put("bootstrap.servers", "kafka-bootstrap.kafka.svc:9092");
props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer");
props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer");
props.put("acks", "all");
props.put("enable.idempotence", true);
props.put("max.in.flight.requests.per.connection", 5);
props.put("delivery.timeout.ms", 120000); // 示例总交付时限,按业务要求调整。
// 不把 retries 固定为 3;保留客户端默认值,并用交付时限约束重试。启用幂等性时,acks 必须为 all、retries 必须大于 0,max.in.flight.requests.per.connection 不超过 5。满足条件时可以保持分区内发送顺序,无需一律降到 1;设为 1 是更保守、并发度更低的选择。应用仍需处理发送回调或 Future 中的最终失败,不能把入客户端缓冲区当作 Broker 已确认。Producer 参数约束
监控与告警
先区分“配置下限是否合适”和“运行时副本是否健康”:
| 检查项 | 含义 | 检查方式 |
|---|---|---|
| minISR 配置低于基线 | Topic 即使处于单 ISR 状态,也可能继续确认写入 | Admin API、CLI 或已有配置采集指标 |
| UnderReplicatedPartitions | ISR 数小于配置副本数,冗余不足 | kafka.server:type=ReplicaManager,name=UnderReplicatedPartitions |
| UnderMinIsrPartitionCount | ISR 数小于 minISR,要求 acks=all 的写入受影响 | kafka.server:type=ReplicaManager,name=UnderMinIsrPartitionCount |
| Consumer Lag | 某消费组处理落后,不能直接等同于副本复制延迟 | 消费组 Offset、Log End Offset 和处理速率 |
JMX MBean 是 Kafka 的指标入口,导出后的 Prometheus 名称由 JMX Exporter 规则决定。下面两条规则保留原文的告警意图,但指标名是示例,使用前必须确认真实采集结果;kafka_topic_partition_min_isr 通常还需要单独的 Topic 配置采集。Kafka 监控指标
groups:
  - name: kafka-replication
    rules:
      - alert: KafkaMinISRTooLow
        expr: kafka_topic_partition_min_isr < 2
        for: 1m
        annotations:
          summary: "Topic {{ $labels.topic }} 的 minISR 配置低于生产基线"
      - alert: KafkaUnderReplicatedPartitions
        expr: kafka_server_replicamanager_underreplicatedpartitions > 0
        for: 30s
        annotations:
          summary: "Broker {{ $labels.instance }} 存在副本不足的分区"
      - alert: KafkaUnderMinISR
        expr: kafka_server_replicamanager_underminisrpartitioncount > 0
        for: 30s
        annotations:
          summary: "Broker {{ $labels.instance }} 存在 ISR 低于 minISR 的分区"
同时监控请求错误、生产延迟、磁盘空间与延迟、网络、消费积压,以及元数据仲裁健康。阈值和持续时间应结合允许的恢复时间、维护窗口与业务影响设置。
Kubernetes 迁移与 ZooKeeper 排障
迁移时要重新声明哪些前提
从单机 Docker Compose 迁到 Kubernetes 后,Pod 可能被驱逐、重建和调度到其他节点。原来由固定主机名、宿主机目录和单机路由维持的条件,需要落实到持久卷、稳定身份和网络规划上。
原案例的 Compose 网络使用 172.17.x.x,平时通过 docker logs --tail 100 -f <container> 查日志,并曾用定时 docker system prune -a --volumes 清理。清理命令可能删除符合条件的未使用卷,不能作为数据库或消息系统的通用清理办法;迁移前应先确认实际挂载和备份。Kubernetes 中也应通过日志采集保留历史,避免 Pod 重建后失去现场。
Kafka 和 ZooKeeper 的自管部署通常使用 StatefulSet 或具备相应生命周期管理能力的 Operator。稳定身份、每成员独立持久卷和成员配置需要同时满足。StatefulSet 提供的创建顺序不决定 ZooKeeper 的 Leader;集群首次启动时还要避免“第一个 Pod 等待仲裁就绪,后续 Pod 又等待它 Ready”的依赖。
先确认为什么重启
CrashLoopBackOff 表示容器反复退出后的重启退避;Session Expired 表示会话失效,两者不能直接画等号。ZooKeeper 连接断开或重新选举,也不必然意味着服务进程退出。先看退出原因、探针、OOM、事件和上一实例日志,再判断存储或网络问题。
# 先改为目标集群的 context;下列示例都显式指定集群与命名空间。
KAFKA_CONTEXT='your-kafka-context'
KAFKA_NAMESPACE='kafka'

kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" get pods -o wide
kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" describe pod zk-0
kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" logs zk-0 -c zk --tail=100
kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" logs zk-0 -c zk --previous --tail=100
kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" get events --sort-by=.lastTimestamp
kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" get pvc
kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" describe sts zk
kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" exec zk-0 -c zk -- zkServer.sh status
--previous 只在存在上一容器实例日志时有效。zkServer.sh 的路径和管理命令支持取决于镜像;预期三节点集群应检查是否形成一个 Leader、其余为 Follower。意外显示 standalone 时,要核查成员配置,不能仅凭进程存活就判定仲裁正常。
数据与身份:emptyDir、myid 和 PVC
现象与原因。 Pod 删除或重建后,数据目录为空、myid 缺失、事务日志丢失,可能导致 ZooKeeper 无法启动或无法正常加入原仲裁。Kafka 可能出现连接或元数据操作超时,但“丢失 myid”不能单独证明发生了脑裂、Topic 损坏或消费位移丢失;现代 Kafka 消费组位移主要保存在 Kafka 的 __consumer_offsets 中。
emptyDir 随 Pod 生命周期存在,同一 Pod 内的容器崩溃重启不会清空它;Pod 删除或离开节点后,数据不再保留。PVC 列表非空也不能单独证明数据已持久化,需要检查实际挂载的卷是否对应 dataDir / dataLogDir,PVC 是否 Bound,目录是否可写、剩余空间和 inode 是否充足。Kubernetes emptyDir
kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" get sts zk -o yaml
kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" describe pvc data-zk-0
kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" exec zk-0 -c zk -- \
  sh -c 'cat /data/myid; df -h /data /datalog; df -i /data /datalog'
持久化示例。 下列清单补齐 Headless Service、三节点成员配置、独立数据卷和事务日志卷。示例沿用原文的 ZooKeeper 3.8 系列,要求已存在 kafka 命名空间和可用的默认 StorageClass;实际使用时应锁定经验证的镜像版本,并选择符合延迟要求的存储。这里展示存储与身份配置,未在真实集群部署验证。
apiVersion: v1
kind: Service
metadata:
  name: zk
  namespace: kafka
spec:
  clusterIP: None
  publishNotReadyAddresses: true
  selector:
    app: zk
  ports:
    - name: client
      port: 2181
    - name: quorum
      port: 2888
    - name: election
      port: 3888
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: zk-config
  namespace: kafka
data:
  zoo.cfg: |
    tickTime=2000
    initLimit=10
    syncLimit=5
    dataDir=/data
    dataLogDir=/datalog
    clientPort=2181
    standaloneEnabled=false
    4lw.commands.whitelist=srvr
    autopurge.snapRetainCount=3
    autopurge.purgeInterval=1
    server.1=zk-0.zk:2888:3888
    server.2=zk-1.zk:2888:3888
    server.3=zk-2.zk:2888:3888
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: zk
  namespace: kafka
spec:
  serviceName: zk
  replicas: 3
  podManagementPolicy: Parallel
  selector:
    matchLabels:
      app: zk
  template:
    metadata:
      labels:
        app: zk
    spec:
      initContainers:
        - name: init-myid
          image: busybox:1.36
          command:
            - sh
            - -ec
            - |
              ordinal=${POD_NAME##*-}
              expected=$((ordinal + 1))
              if [ -s /data/myid ]; then
                actual=$(cat /data/myid)
                [ "$actual" = "$expected" ] || {
                  echo "Existing myid $actual differs from expected $expected" >&2
                  exit 1
                }
              else
                printf '%s\n' "$expected" > /data/myid
              fi
          env:
            - name: POD_NAME
              valueFrom:
                fieldRef:
                  fieldPath: metadata.name
          volumeMounts:
            - name: data
              mountPath: /data
      containers:
        - name: zk
          image: zookeeper:3.8
          ports:
            - name: client
              containerPort: 2181
            - name: quorum
              containerPort: 2888
            - name: election
              containerPort: 3888
          volumeMounts:
            - name: data
              mountPath: /data
            - name: datalog
              mountPath: /datalog
            - name: config
              mountPath: /conf/zoo.cfg
              subPath: zoo.cfg
              readOnly: true
      volumes:
        - name: config
          configMap:
            name: zk-config
  volumeClaimTemplates:
    - metadata:
        name: data
      spec:
        accessModes: [ReadWriteOnce]
        resources:
          requests:
            storage: 20Gi
    - metadata:
        name: datalog
      spec:
        accessModes: [ReadWriteOnce]
        resources:
          requests:
            storage: 20Gi
zk-0/1/2 在这里映射到 myid=1/2/3,与 server.1/2/3 一致。原片段直接把 Pod 序号写成 0/1/2,却配上 server.1=zk-0.zk,身份会错位。已有数据卷的成员身份应先核对,不能靠覆盖 myid 强行重建集群。ZooKeeper 成员配置
Headless Service 提供稳定域名,publishNotReadyAddresses 允许成员在尚未 Ready 时互相发现;Parallel 让初始成员能够一起启动。两个 PVC 也只有在后端实际分配独立存储设备时,才能实现预期的 I/O 隔离,不能只看挂载路径不同。生产还需要配置资源、Pod 分布、探针、PDB、访问控制及备份。ConfigMap 以 subPath 挂载时不会自动更新容器中的该文件,变更应通过受控滚动流程生效。
删除行为分两层检查:
| 层级 | 控制什么 | 核查重点 |
|---|---|---|
| StatefulSet PVC 保留策略 | 删除 StatefulSet 或缩容时是否自动删除其 PVC | persistentVolumeClaimRetentionPolicy.whenDeleted / whenScaled,默认 Retain |
| PV 回收策略 | PVC 删除后,PV 及底层存储如何处理 | 实际 PV 的 persistentVolumeReclaimPolicy;动态卷通常从 StorageClass 继承 |
StorageClass 设为 Delete 不意味着删除 StatefulSet 必然删除 PVC。若需要保护误删后的数据,可以评估 PV 的 Retain,但它还带来人工回收责任,也不能替代备份。详情见 PVC 删除后的数据保护 及 StatefulSet PVC 保留策略。
磁盘 I/O:先消除争用,再调整超时
现象与原因。 原文记录了 Session Expired、Connection broken for session、同步超时和副本滞后。Kafka 的持续读写与 ZooKeeper 事务日志共用受限设备时,可能增加 ZooKeeper 持久化延迟,继而影响请求处理与会话稳定性。连接中断还可能与 GC、CPU 限流或网络有关,应结合时间线判断。
kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" logs zk-0 -c zk --tail=100
kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" exec zk-0 -c zk -- \
  sh -c 'iostat -x 1 3 || cat /proc/diskstats'
镜像可能没有 iostat;/proc/diskstats 也只是累计计数,不能直接替代延迟分析。应结合节点或云盘监控,核对实际设备、await、队列、IOPS、吞吐和带宽上限。
处理顺序:
- 将 ZooKeeper 事务日志
dataLogDir放到独立的低延迟设备,避免与 Kafka 数据盘争用;dataDir中的快照也应与事务日志的 I/O 需求分别评估。 - 核查云盘规格和宿主机带宽限制。只把目录或 PVC 拆开,未必改变底层瓶颈。
- 在测得延迟后评估超时参数;适当放宽
syncLimit可以增加容忍时间,但无法解决持续的磁盘拥塞。
tickTime=2000
initLimit=10
syncLimit=5
dataDir=/data
dataLogDir=/datalog
tickTime 单位为毫秒,是部分超时参数的基准;initLimit 和 syncLimit 以 tick 为单位,后者约束 Follower 与 Leader 的同步容忍时间。上例分别约为 20 秒和 10 秒。客户端 Session Timeout 是另一组协商参数,并非所有超时都直接等于某个 tick 倍数。ZooKeeper 集群参数
原案例描述的处理过程是:先修复 StatefulSet 与 20Gi 持久卷,节点恢复为 follower;约两小时后再次出现会话超时,观测到共享云盘 await 超过 200ms,随后独立事务日志 SSD,并把 syncLimit 从 5 调到 8。这个数值和恢复结果来自原案例,不能直接当作其他集群的调参目标;一般应先修复 I/O,再按实测评估从 5 调到 8 或 10 的影响。
网络:检查 CIDR、DNS 与实际路由
现象与原因。 Pod 间连接不稳定、访问外部服务时通时断、ZooKeeper 无法形成仲裁,或 zkServer.sh status 超时,可能来自地址重叠、DNS、路由、防火墙或 NetworkPolicy。kubectl exec 卡住还可能涉及 API Server 到 kubelet 的链路,不能直接认定是 Pod CIDR 冲突。
原案例关注 Docker 常见的 172.17.0.0/16 bridge 网段。关键是确认仍在使用的 Docker bridge、节点/VPC、Pod CIDR、Service CIDR、VPN 和外部网络之间不存在冲突;不是所有 172.17.x.x 地址都必然有问题。
kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" get pods -o wide
kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" get svc zk
kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" exec zk-0 -c zk -- \
  getent hosts zk-1.zk
kubectl --context "$KAFKA_CONTEXT" get nodes \
-o custom-columns=NAME:.metadata.name,PODCIDRS:.spec.podCIDRsgetent、ip route 等工具是否可用取决于镜像。Pod IP 列表不能单独证明地址冲突,应结合 CNI/IPAM 配置、节点及对端路由和抓包结果;某些 CNI 也不通过 Node 的 podCIDRs 字段表达全部地址分配。再检查 ZooKeeper 的 2181、2888、3888 端口,以及 Kafka Broker 和客户端 Listener 的实际连通性。
下面保留原文的网络规划示例,仅作为 kubeadm ClusterConfiguration 中的字段片段;网段必须按实际环境选择:
networking:
  podSubnet: "10.244.0.0/16"
  serviceSubnet: "10.96.0.0/12"
托管集群也应在创建前核对 Pod、Service 和节点网络。运行中修改 CIDR 往往涉及重建或专门迁移,应遵循相应 CNI 与云平台的支持路径。Kubernetes 集群网络模型
Kafka 自身的持久化与 Listener
ZooKeeper 恢复后,还要继续检查 Kafka 的数据卷、内部 Topic 和客户端可达性。ZooKeeper 保存的元数据不能替代 Kafka 消息日志;KRaft 的元数据卷也不能替代业务数据卷。
# 仅示意集群内的 Listener;生产认证与加密另行配置。
listeners=PLAINTEXT://:9092
advertised.listeners=PLAINTEXT://kafka-0.kafka.kafka.svc:9092
offsets.topic.replication.factor=3
每个 Broker 应发布自己可达的地址,不能都填同一个 Pod 名。advertised.listeners 是客户端获得元数据后实际连接的地址,外部客户端不能直接使用仅在集群内解析的 DNS。普通 server.properties 不会自动展开 ${POD_NAME};如果需要变量替换,应由镜像启动逻辑、模板或 Operator 显式生成配置。Kafka Listener 配置
kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" exec kafka-0 -- \
  kafka-topics.sh --bootstrap-server kafka-bootstrap.kafka.svc:9092 --list
kubectl --context "$KAFKA_CONTEXT" -n "$KAFKA_NAMESPACE" exec kafka-0 -- \
  kafka-topics.sh --bootstrap-server kafka-bootstrap.kafka.svc:9092 \
  --describe --topic order-events
Pod 和 Service 名称需替换为实际部署值。能列出 Topic 只证明该管理请求成功,不能证明历史数据完整;验收还应包含业务记录核对、消费进度,以及经批准的故障切换与恢复测试。
通用原则:云厂商默认配置审查清单
默认值可能来自开源版本、Chart、镜像、托管产品或具体规格。审查对象应是实际生效配置,并判断它是否满足业务要求,不能把某个产品或某次事故的配置当作所有云厂商的统一默认值。
常见审查项目
| 组件 | 需要确认的实际配置 | 风险 | 评估方向 |
|---|---|---|---|
| Kafka | 副本数、minISR、Producer acks、选主策略 | 单副本确认、冗余不足或故障切换时丢失数据 | 三副本 / minISR 2 / acks=all 的组合、跨故障域部署和告警 |
| MySQL RDS | 单可用区还是多可用区,备份和恢复是否启用 | 可用区故障、误操作后无法按目标恢复 | 按 SLA、RPO/RTO 选择部署与恢复方案 |
| Redis | 实际持久化和复制策略,产品是否支持 AOF | 重启或故障转移时丢失尚未持久化的数据 | 按用途评估 AOF、快照、复制;appendfsync everysec 也有数据窗口 |
| Nginx | keepalive_timeout、连接容量与上下游超时 | 空闲连接占用资源,或超时不匹配 | 原文的 75 秒、15–30 秒只作为检查与调优例子,按实测选择 |
| Kubernetes Deployment | 副本数、故障域分布、PDB 与发布策略 | 单点或维护时中断 | 业务允许时至少两个副本并分散部署;PDB 仅保护相应自愿中断 |
部署前审查六问
- 高可用: 副本是否分散到不同节点和可用区?故障转移依赖什么,是否验证过?
- 数据持久性: 哪些故障可能丢失已经确认的数据?备份、保留策略和恢复验证是否满足 RPO/RTO?
- 监控告警: 是否覆盖配置偏差、ISR、分区不可用、生产错误、消费积压及磁盘与仲裁健康?
- 容量规划: 磁盘空间、IOPS、带宽、分区数、连接数和服务配额是否足够?
- 升级策略: 是否自动升级?客户端、Broker、Operator、元数据版本和回退边界是否兼容?
- 费用: 副本、备份、跨可用区或跨地域流量、扩容和恢复是否带来额外费用?
核查时落实三件事:读取实际配置并保留证据;同时查看控制台、API、配置文件及客户端设置;理解参数的适用条件后再调整,尤其区分单机示例、开发环境和生产基线。
排查与验收清单
- 确认集群使用 ZooKeeper 还是 KRaft;选择对应的元数据仲裁排障路径。
- 核对目标 context、namespace、容器退出原因、Events、当前日志和上一实例日志。
- 检查每个成员的真实数据挂载、PVC 绑定、PV 回收策略、剩余空间与 inode。
- ZooKeeper 集群核对
myid、server.N、Headless Service DNS,以及 Leader/Follower 角色;KRaft 集群核对节点 ID 与 Controller 仲裁。 - 检查数据盘与事务日志或元数据日志的实际后端设备、延迟和争用,避免只放宽超时。
- 核对 Pod、Service、节点/VPC、旧 Docker bridge、VPN 网段及路由;验证 DNS 和端口连通性。
- 核对每个 Broker 的
advertised.listeners、数据卷、业务 Topic 和内部 Topic 的副本配置。 - 查看分区 Leader、Replicas、ISR、minISR、Producer
acks与最终发送错误;另查消费组分配和 Lag。 - 使用获准的测试数据验证生产、消费与重放,并核对业务数据;维护和故障切换验证须有独立计划。
资料来源
- WAKEUP 技术:K8s 跑 Kafka?zk 总重启:迁移背景、持久化、磁盘 I/O、CIDR 排障与案例记录;原剪藏未完整说明版本和验证条件。
- Helm 部署 Strimzi Kafka:原有副本同步、事故记录、生产配置与默认值审查材料;部署内容保留在该文。
- Kafka 官方的 入门、设计、Topic 配置、Producer 配置、监控 与 4.0 升级:用于补充概念和核对参数边界。
- ZooKeeper 管理指南 与 官方镜像说明:用于核对成员身份、数据目录、事务日志及镜像配置方式。
- Kubernetes Volumes 与 StatefulSet:用于核对临时卷生命周期、稳定身份及 PVC 保留行为。