大模型精度与量化:FP64 到 NVFP4
阅读提示
本文归档自原始技术文章,保留其精度格式、缩放机制、显存估算和训练/推理选择内容;文中的 70B 示例仅估算权重显存,不代表完整运行时显存。
看 AI 芯片、GPU、模型训练和推理时,经常会看到这些词:
FP64、FP32、TF32、BF16、FP16、FP8、INT8、INT4、NVFP4
它们本质上都在回答一个问题:
计算机到底用多少 bit 来表示一个数字,以及这个数字怎么被表示。
大模型里到处都是数字:参数是数字,激活值是数字,梯度也是数字。不同数字格式的差别,最后都会落到四件事上:
准不准?
能表示多大 / 多小?
占多少显存?
算得快不快?
01
先用 π 理解:什么是精度?
精度可以先理解成:一个数字能被记录得多细。
数学里的 π 是最好的例子。
3
3.14
3.1415926
3.141592653589793
这些都在表示 π,但精细程度完全不同。
如果只是小学估算圆的周长,用 3.14 就够了;如果是高精度科学计算,可能需要保留更多位。也就是说:
位数越多,越接近真实值;
位数越少,越省事、越快,但误差更大。
放到 AI 模型里也是一样。模型里有大量参数和中间结果,如果数字格式太粗,模型可能不准;如果数字格式太精细,又会占更多显存、消耗更多算力。
所以模型精度的核心就是一句话:
在准确度、显存、速度之间做取舍。
02
为什么有这么多精度?
因为不同场景对“准确”和“成本”的要求不一样。
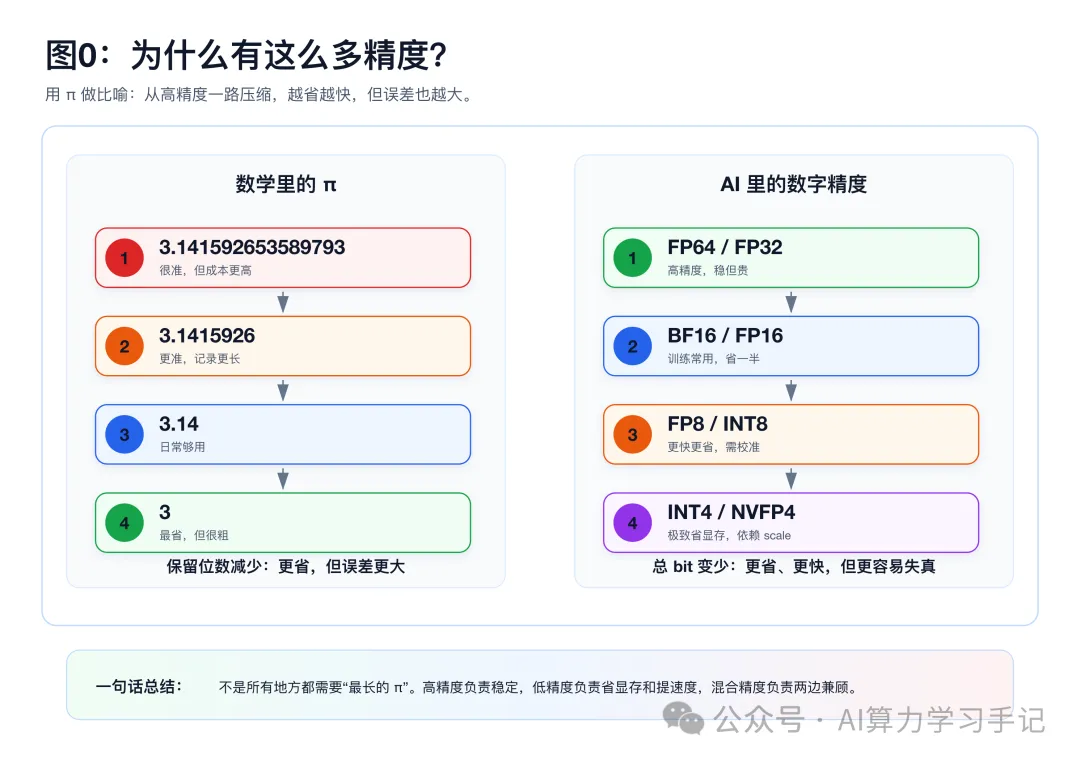
还是拿 π 来比喻:
3.141592653589793 更准,但成本更高
3.1415926         更准,但记录更长
3.14              日常够用
3                 最省,但太粗
AI 里的 FP64、FP32、BF16、FP16、FP8、INT8、INT4 也是类似的思路。不是所有地方都需要“最长的 π”。如果一个地方用 3.14 已经够准,就没必要用几十位小数;如果连 3 都够用,就可以进一步压缩。
所以才会有这么多精度格式:
高精度:更准,但更占显存、更慢
低精度:更省显存、更快,但更容易失真
混合精度:重要地方保高精度,大量计算用低精度
高精度更准确,但代价也更高:
FP64:一个数字 8 Byte
FP32:一个数字 4 Byte
FP16 / BF16:一个数字 2 Byte
FP8 / INT8:一个数字 1 Byte
INT4:一个数字约 0.5 Byte
NVFP4:数值本体 0.5 Byte;计入分组 scale 后约 0.5625 Byte
粗略估算模型权重显存,可以用:
模型权重显存 ≈ 参数量 × 每个参数占用字节数
举个直觉例子,一个 700 亿参数模型,如果只看权重:
FP16 / BF16:约 70B × 2 Byte = 140GB
INT8:约 70B × 1 Byte = 70GB
INT4:约 70B × 0.5 Byte = 35GB
NVFP4:约 70B × 0.5625 Byte ≈ 39GB
这里的 0.5625 Byte 是粗略把 NVFP4 的分组 scale 也算进去:4 bit 数值本体 + 每 16 个值共享 1 个 FP8 scale,平均每个值多 0.5 bit,也就是约 4.5 bit / 值。更高层的 tensor-level FP32 scale 很小,通常可以忽略。
这就是为什么大模型推理特别关心 INT8、INT4、FP8、NVFP4:它们能显著降低显存和带宽压力。
但低精度不是免费午餐。bit 越少,数字越容易失真,所以需要 scale、校准、混合精度和硬件支持来兜底。
03
都有哪些精度?
常见精度可以先分成两大类:
浮点数:FP64、FP32、TF32、BF16、FP16、FP8、NVFP4
整数 / 量化:INT8、INT4
浮点数像“科学计数法”,适合表示很大、很小、有小数的数。整数格式本身不直接表示小数,通常要配合 scale,把小数近似映射成整数。
从高精度到低精度,可以粗略这样看:
FP64:最高精度,科学计算常用
FP32:传统深度学习标准精度
TF32:NVIDIA 上加速 FP32 矩阵计算
BF16 / FP16:16-bit 半精度,训练常见
FP8:8-bit 浮点,更快更省
INT8:8-bit 整数量化,推理常见
INT4 / NVFP4:4-bit 路线,极致省显存
接下来先看浮点数怎么表示一个数字。
04
先懂浮点数:符号、指数、尾数
FP 是 Floating Point,中文叫浮点数。可以把它理解成计算机里的“二进制科学计数法”。
十进制里我们会这样写:
1230000 = 1.23 × 10^6
0.000123 = 1.23 × 10^-4
计算机里类似,只是底数从 10 换成了 2:
数值 ≈ 符号 × 尾数 × 2^指数
也就是三部分:
[符号位] [指数位] [尾数位]
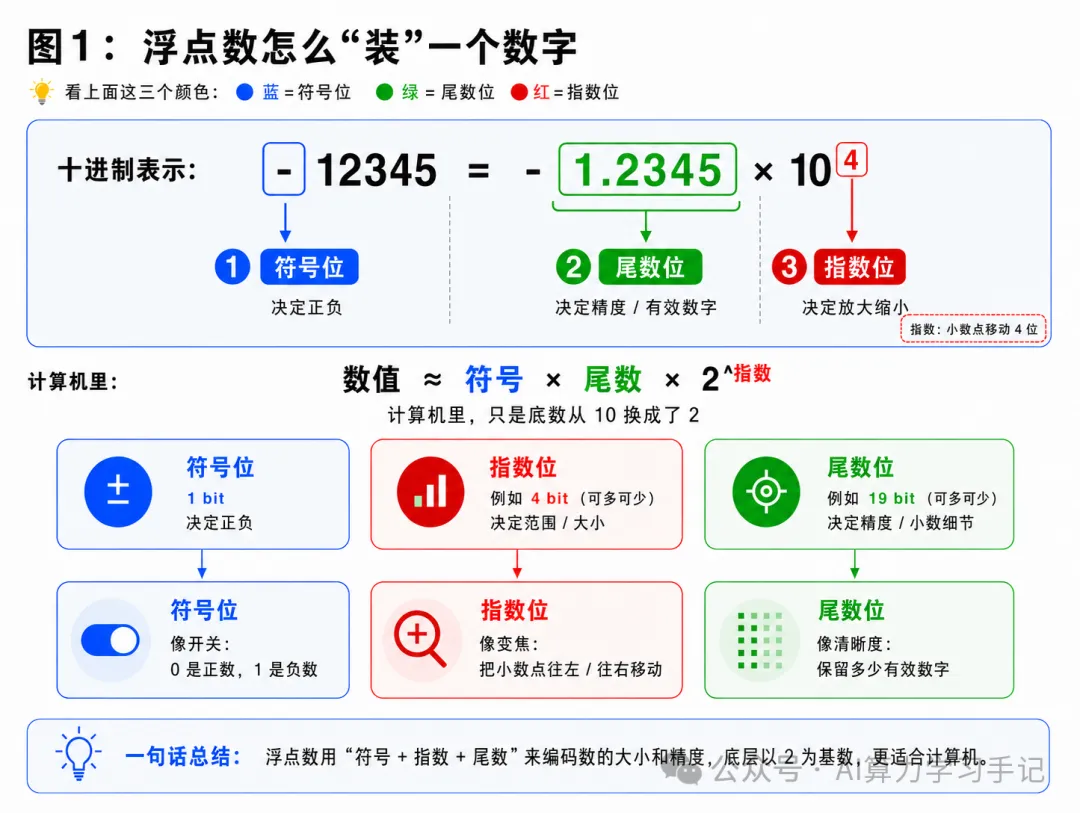
最重要的口诀:
符号位:决定正负
指数位:决定范围,能表示多大 / 多小
尾数位:决定精度,能表示多细
符号位通常是 1 bit:
0 = 正数
1 = 负数
指数位像“小数点移动器”。指数位越多,能表示的数字范围越大。比如 BF16 和 FP32 都有 8 个指数位,所以 BF16 虽然只有 16 bit,但范围接近 FP32。
尾数位像“清晰度”。尾数位越多,小数细节越多。例如 3.1415926 如果只保留 3 位有效数字,就只能近似成 3.14。
所以要记住:
范围大,不等于精度高。
精度高,也不等于范围大。
05
常见格式一张图看懂
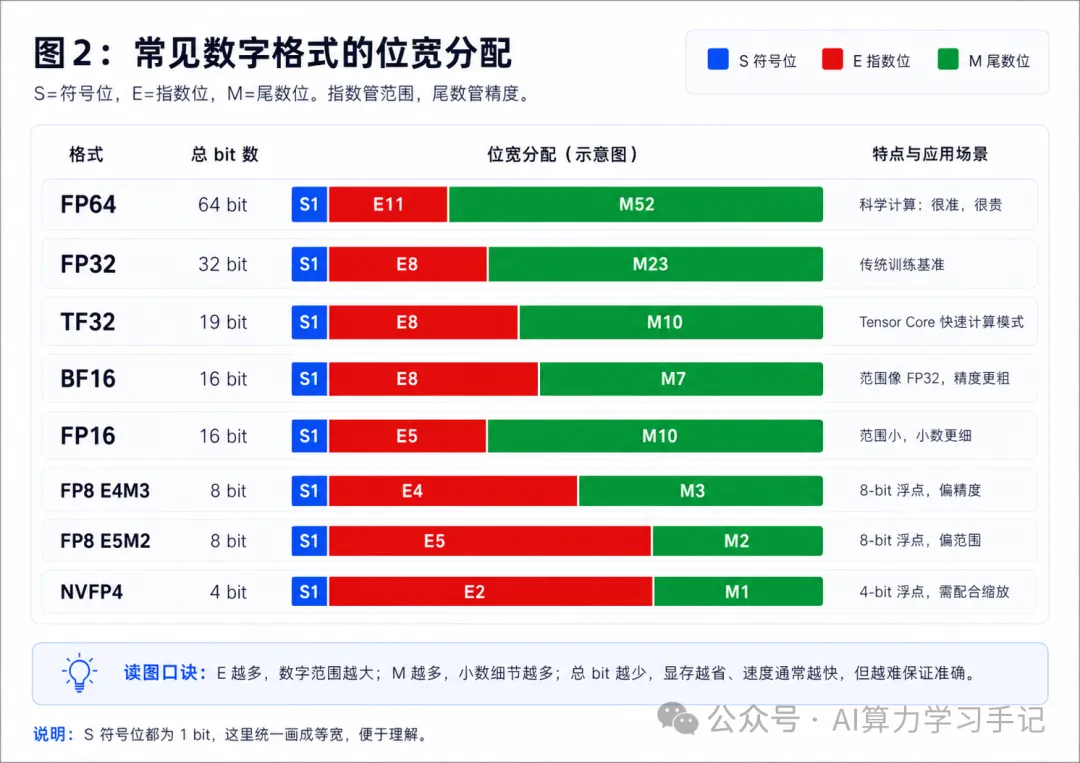
注意:这张图是“字段表格”,不是按面积比例画的。下面这些浮点格式的符号位都是 1 bit,所以图里统一写成 S1;指数位和尾数位用 E/M 后面的数字表示。
| 格式 | 总位宽 | 结构 | 直观理解 |
|---|---|---|---|
| FP64 | 64 bit | 1 符号 + 11 指数 + 52 尾数 | 超高清,很准,很贵 |
| FP32 | 32 bit | 1 + 8 + 23 | 标准高清,传统训练基准 |
| TF32 | 32 bit 存储 / 19 bit 计算 | 1 + 8 + 10 | FP32 的 Tensor Core 加速模式,不省显存 |
| BF16 | 16 bit | 1 + 8 + 7 | 范围像 FP32,小数更粗 |
| FP16 | 16 bit | 1 + 5 + 10 | 小数更细,但范围小 |
| FP8 E4M3 | 8 bit | 1 + 4 + 3 | 8-bit 浮点,偏精度 |
| FP8 E5M2 | 8 bit | 1 + 5 + 2 | 8-bit 浮点,偏范围 |
| NVFP4 | 4 bit | 1 + 2 + 1 | 4-bit 浮点,需要配合缩放 |
读这张表,只看两个问题就够了:
E 越多,范围越大。
M 越多,精度越高。
总 bit 越少,通常越省显存、越快,但越难保证准确。
06
这些格式分别是什么?
FP64 是双精度浮点数,精度高、范围大,但计算和显存成本都高,常见于科学计算、仿真、金融数值等场景。大模型训练和推理一般不会大规模使用 FP64。
FP32 是传统深度学习里的标准单精度格式,结构是 1 符号 + 8 指数 + 23 尾数。它比较稳,但显存和算力开销大,所以后来出现了各种低精度和混合精度方案。
TF32 是 NVIDIA Tensor Core 上的一种 FP32 加速计算模式。严格说,它通常不是一种新的内存存储格式:数据在内存里仍然按 FP32 存,所以不省显存;只是进入 Tensor Core 做矩阵乘法时,乘法精度近似为 1 符号 + 8 指数 + 10 尾数。它保留 8 个指数位,所以范围像 FP32;但尾数只有 10 位,所以精度比 FP32 低。可以简单理解成:FP32 的快速计算模式,主要省算力、提吞吐,不是省显存。
BF16 和 FP16 都是 16 bit,但性格不一样:
FP16 = 1 符号 + 5 指数 + 10 尾数
BF16 = 1 符号 + 8 指数 + 7 尾数
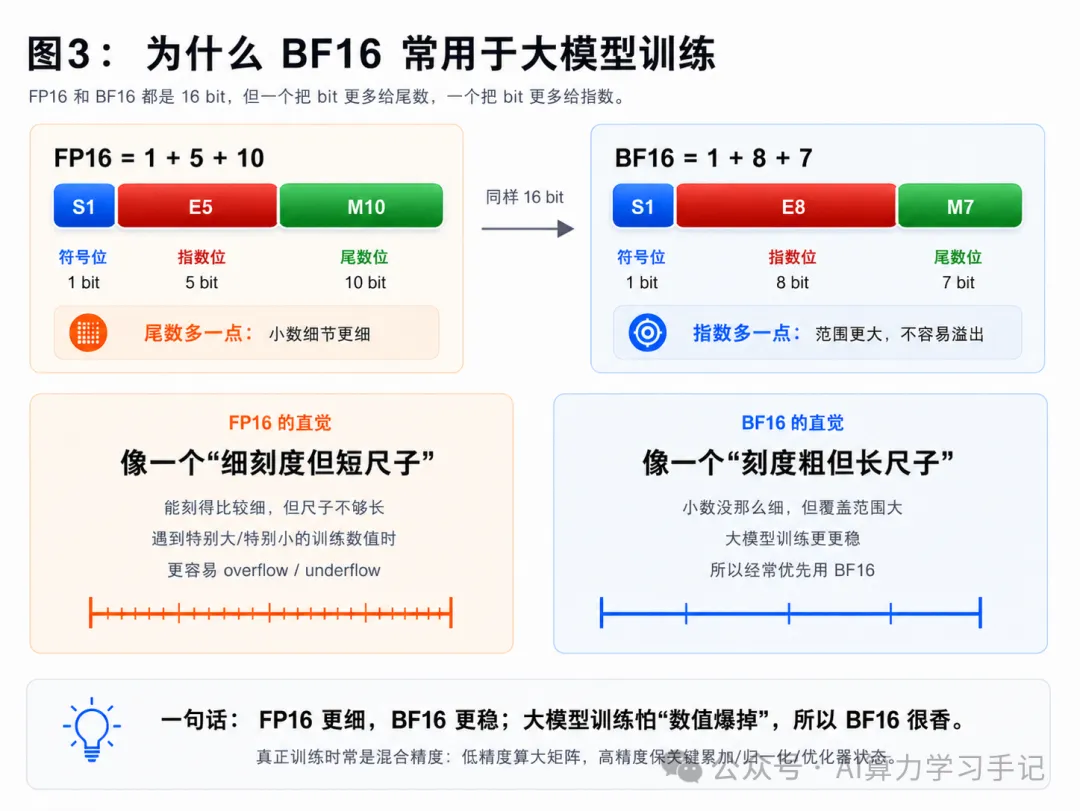
FP16 尾数更多,小数更细;但指数更少,范围更小。BF16 尾数更少,小数更粗;但指数更多,范围接近 FP32,更不容易 overflow。
一句话:
FP16 更细,BF16 更稳。大模型训练怕数值爆掉,所以 BF16 很常见。
FP8 是更激进的 8-bit 浮点格式,常见两种:
E4M3:4 个指数位 + 3 个尾数位,偏精度
E5M2:5 个指数位 + 2 个尾数位,偏范围
区别可以这样记:
| 格式 | 指数位 | 尾数位 | 直观理解 | 常见倾向 |
|---|---|---|---|---|
| FP8 E4M3 | 4 | 3 | 刻度更细,但尺子短一点 | 更偏权重、激活 |
| FP8 E5M2 | 5 | 2 | 尺子更长,但刻度粗一点 | 更偏梯度等范围变化大的值 |
一句话:E4M3 偏精度,E5M2 偏范围。
FP8 更省显存、带宽压力更小、吞吐更高,但也更依赖 scale、校准、框架和硬件支持。它不是只用于推理,从 H100 这类支持 FP8 Tensor Core 的硬件开始,训练中也可以使用 FP8;但通常是 FP8 + FP16/BF16/FP32 的混合精度训练,关键累加、归一化、优化器状态等路径仍会保留更高精度。纯 FP8 训练目前并不常见。
NVFP4 是 NVIDIA Blackwell 架构上引入的 4-bit 浮点格式,结构是:
NVFP4 = E2M1 = 1 符号 + 2 指数 + 1 尾数
单个 4 bit 数字非常粗,所以实际使用时会配合分组缩放。可以理解成:每个数字很小,但一小组数字共享一个 scale,让它仍然能服务于模型计算。
NVIDIA 官方介绍里,NVFP4 会采用“每 16 个值共享一个 FP8 E4M3 scale + 每个 tensor 一个 FP32 scale”的两级缩放机制,尽量降低 4-bit 量化带来的误差。
在 NVIDIA 展示的语言模型评测中,NVFP4 相比 FP8 的精度损失可控制在 1% 以内;同时,模型内存占用相比 FP16 约减少 3.5 倍,相比 FP8 约减少 1.8 倍。配合 Blackwell 第五代 Tensor Core 对 microscaled FP4 的硬件支持,NVFP4 更适合超大规模推理中追求显存、带宽和吞吐效率的场景。
07
INT8 / INT4:整数怎么表示小数?
INT 是 integer,整数。它和 FP 不一样。
FP 有:
符号位 + 指数位 + 尾数位
INT 没有指数位和尾数位。有符号 INT 通常也不是像浮点数那样单独拆出“符号位 + 指数位 + 尾数位”,而是用整数编码方式表示正负。比如有符号 INT8 大约表示 -128 到 127,有符号 INT4 大约表示 -8 到 7。
那模型参数明明是小数,INT8 / INT4 怎么表示?
答案是:靠 scale。
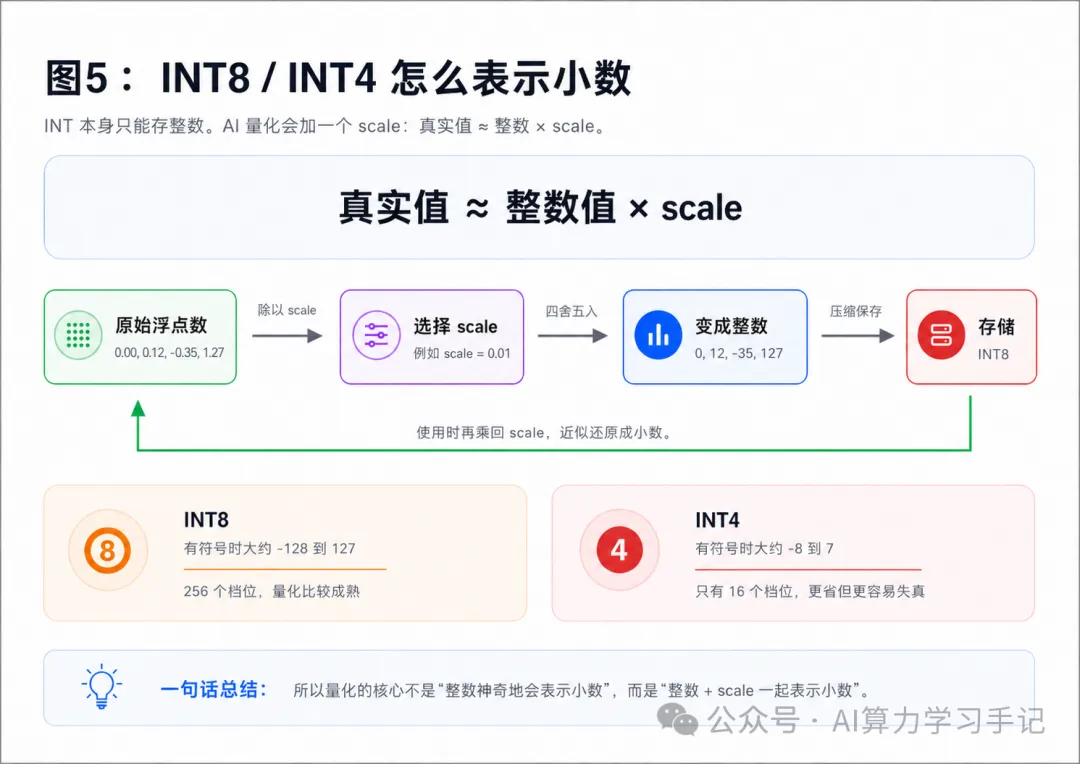
量化可以理解成:
真实值 ≈ 整数值 × scale
比如:
scale = 0.01
整数 123 表示 1.23
整数 -27 表示 -0.27
所以 INT8 / INT4 不是直接存小数,而是:
整数 + scale 一起近似表示小数。
INT8 有 256 个档位,量化比较成熟,推理里很常见。INT4 只有 16 个档位,更省显存,但更容易失真,常用于大模型权重量化。
08
范围 vs 精度:它们到底在取舍什么?
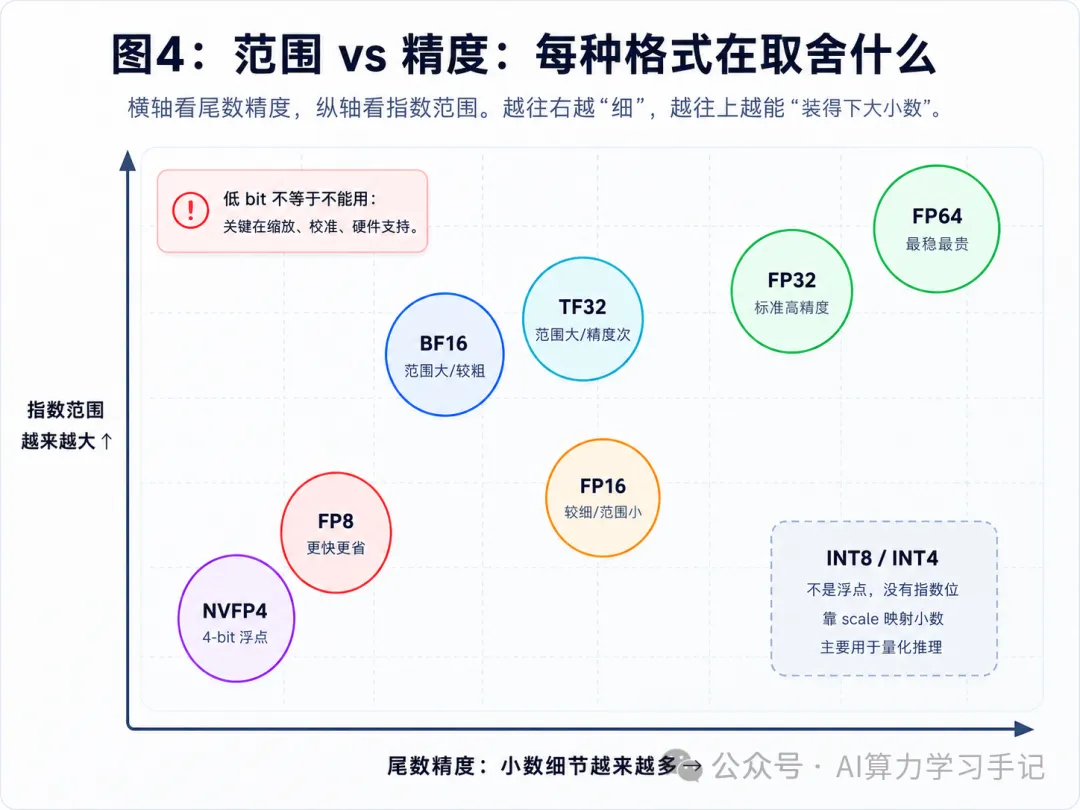
可以用两个维度看:
横轴:尾数精度,越往右小数越细
纵轴:指数范围,越往上越能表示大数 / 小数
大致记法:
FP64:范围大,精度高,最贵
FP32:范围大,精度较高,传统基准
BF16:范围大,精度较粗,训练常用
FP16:范围小一些,精度比 BF16 细
FP8:更快更省,但更依赖缩放
NVFP4:4-bit 浮点,非常激进
INT8 / INT4:不是浮点,靠 scale 表示小数
09
训练和推理到底怎么选?
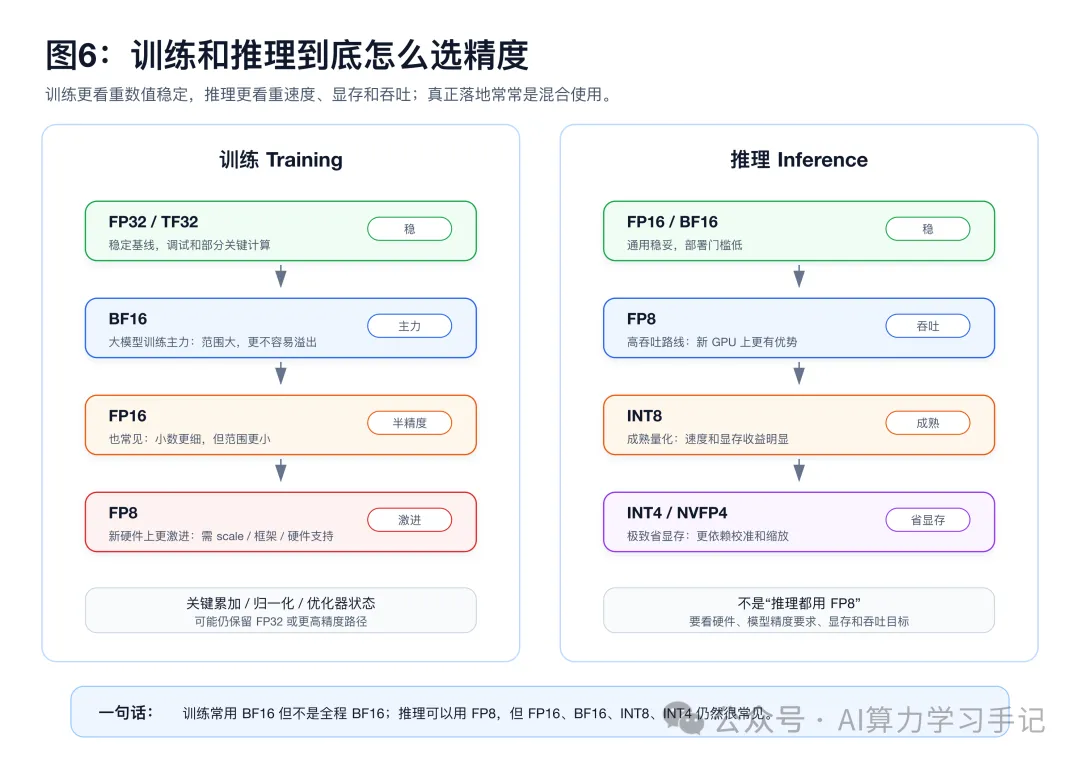
很多人会问:
训练是不是都用 BF16?
推理是不是都用 FP8?
答案都是:不是。
更准确地说:
训练:BF16 是现在大模型训练里很常见的主力选择
推理:FP8 是高吞吐路线之一,但不是唯一选择
训练更看重数值稳定。BF16 范围大,所以很常见;但训练通常是混合精度,关键累加、归一化、优化器状态等地方可能仍然保留 FP32。
推理更看重速度、显存和成本。常见选择包括:
要稳定:FP16 / BF16
要成熟量化:INT8
要极致省显存:INT4
要新硬件高吞吐:FP8 / NVFP4
所以不能简单说:
训练 = BF16
推理 = FP8
更合理的说法是:
训练常用 BF16,但不是全程只有 BF16。
推理可以用 FP8,但 FP16、BF16、INT8、INT4 仍然很常见。
10
最后总结
把所有内容压成四句话:
符号位决定正负。
指数位决定范围。
尾数位决定精度。
scale 决定低 bit 量化怎么还原小数。
再记一张路线图:
| 格式 | 一句话理解 |
|---|---|
| FP64 | 最稳最贵,科学计算用 |
| FP32 | 传统深度学习标准精度 |
| TF32 | NVIDIA 上 FP32 的快速计算模式 |
| BF16 | 大模型训练常用,范围大,更稳 |
| FP16 | 半精度,范围小但小数更细 |
| FP8 | 更激进,训练/推理都可能用 |
| INT8 | 成熟推理量化 |
| INT4 | 极致省显存的大模型量化 |
| NVFP4 | NVIDIA Blackwell 的 4-bit 浮点路线 |
如果只记一句话:
没有一种格式永远最好。训练更看重稳定,推理更看重速度和显存,真正落地时要看硬件、模型和目标。
参考阅读: