KV Cache:从原理到集群调度
你跟 AI 聊天,它一个字一个字蹦回答。但你有没有想过——它是怎么"记住"你说了什么的?答案藏在 GPU 里一个叫 KV Cache 的东西里。
一、KV Cache 是什么?
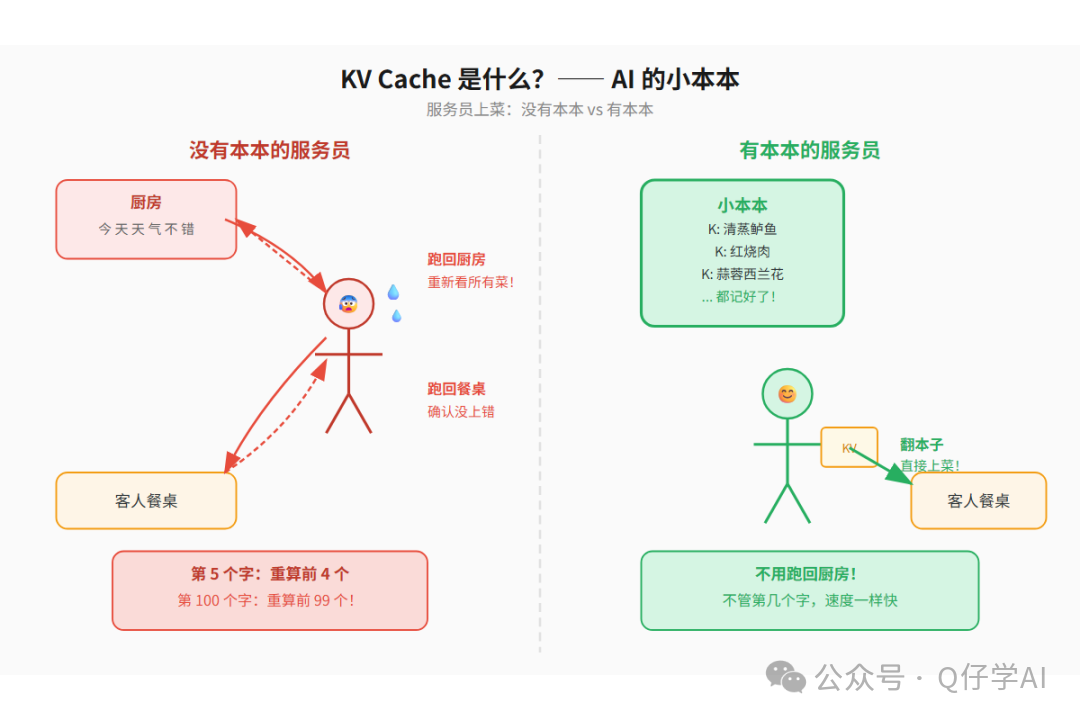
想象你是一个餐厅服务员,客人点了一桌菜,你要一道道端上去。
没有小本本的服务员 :每端一道新菜,都要从厨房跑回餐桌,把之前端过的所有菜再看一遍,确认没上错。菜越多,跑得越累。
有本本的服务员 :端过的菜记在本子上,每端新菜只看本子,不用跑回去。
KV Cache 就是 AI 的"小本本"。
本子上记了什么?
AI 的"脑子"里有一套叫 Attention 的机制,工作时有三样东西:
- Query(问题) :客人现在问"这道鱼怎么做的?"
- Key(标签) :每道菜的名字——"清蒸鲈鱼""红烧肉""蒜蓉西兰花"
- Value(内容) :每道菜的具体做法和配料
AI 生成每个字时,都要拿当前的问题去和每道菜的"标签"比对,找到最相关的,然后从"内容"里提取信息。
KV Cache = 把之前所有菜的"标签"和"内容"抄在本子上。 下次客人问新问题,直接翻本子,不用跑回厨房重新看。
没有本子有多惨?
假设 AI 已经生成了 4 个字:"今天天气不错"。现在要生成第 5 个字:
| 生成第几个字 | 需要重新算的 token | 浪费程度 |
|---|---|---|
| 第 1 个 | 今 | 1 次 |
| 第 2 个 | 今、天 | 今被算了第 2 次 |
| 第 3 个 | 今、天、天 | 今被算了第 3 次 |
| 第 4 个 | 今、天、天、气 | 今被算了第 4 次 |
"今"这个字被反复算了 4 次!而且每次算出来的结果一模一样,因为模型参数是固定的。
生成 n 个字的总计算量:1 + 2 + 3 +... + n = O(n²) 。写到第 1000 个字时,每步要重算前 999 个字。难怪没有 KV Cache 的时候,AI 说话慢到令人发指。
有了 KV Cache,计算量从 O(n²) 降到 O(n)。 这就是为什么你现在能和 AI 流畅聊天。
二、KV Cache 怎么产生的?
AI 回答你分两个阶段,像餐厅的 备菜 和 上菜 。
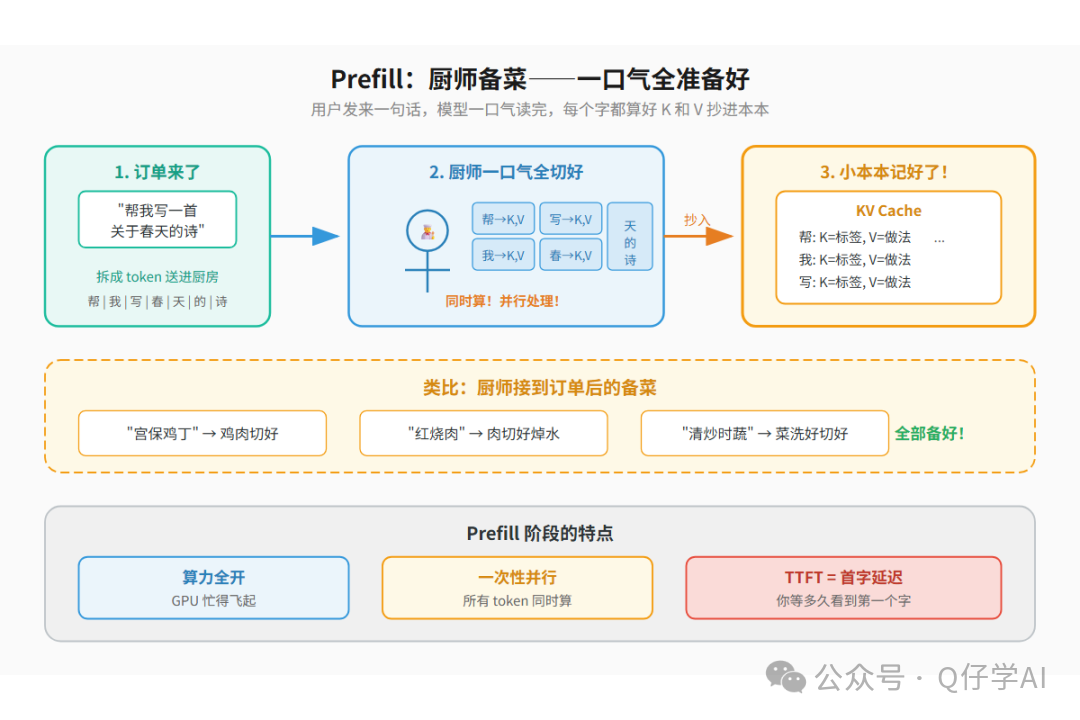
Prefill:备菜——一次性读完你的问题
你发了一句"帮我写一首关于春天的诗"。
AI 不会一个字一个字读,而是 一口气把所有字同时读进去 ,每个字都算好自己的 K(标签)和 V(内容),全部抄进小本本。
这就像厨师接到订单后,先把所有食材准备好、切好、配好料—— 一次性把活干完 。
这一步的特点是: 算力全开,GPU 忙得飞起 。耗时叫 TTFT (首字延迟)——你从发送消息到看到第一个字的时间。
Decode:上菜——一个字一个字蹦
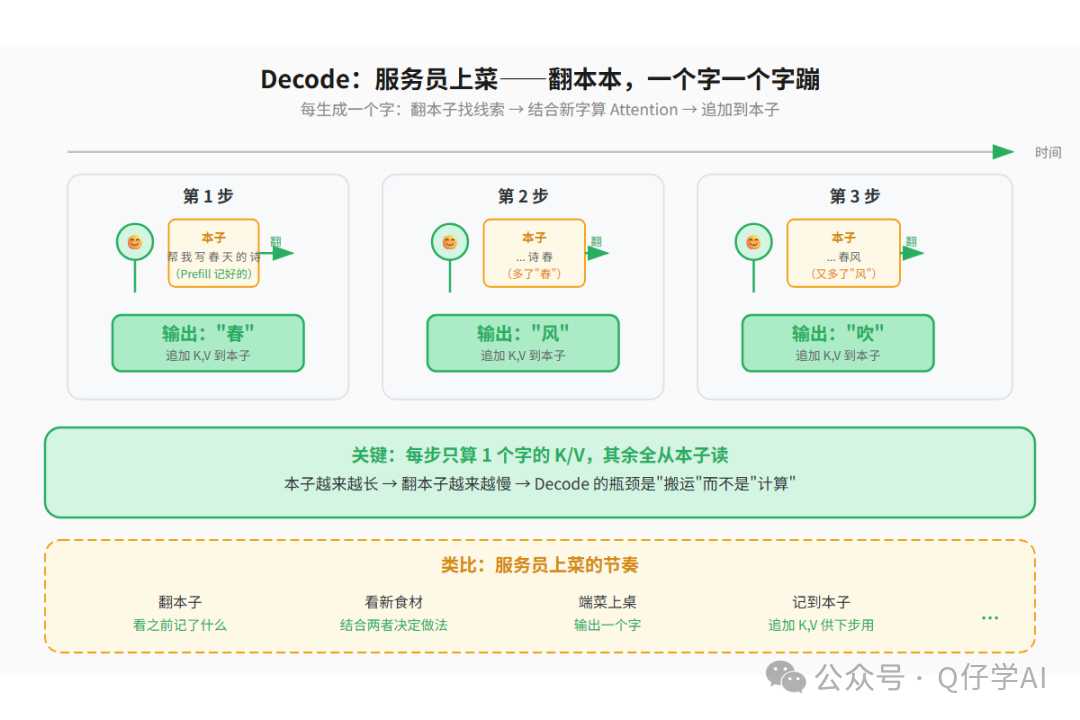
备菜结束后,AI 开始一个字一个字地生成回答。
每生成一个字: 1. 拿这个新字的 Query,去翻小本本上 所有历史 Key → 找到最相关的 2. 用注意力分数对 所有历史 Value 加权求和 → 拼出答案 3. 把这个新字的 K 和 V 追加到本子上 ,供下一步使用
关键洞察 :每步只算 1 个字的 K/V,但要从本子上读所有历史。所以——
- Prefill = 算力瓶颈 (手速不够快)
- Decode = 搬运瓶颈 (翻本子翻不过来)
| 对比 | Prefill(备菜) | Decode(上菜) |
|---|---|---|
| 做什么 | 一口气读完输入 | 逐字生成回答 |
| 瓶颈 | 算力(手速) | 搬运(翻本子) |
| 并行性 | 所有字同时算 | 每次只算 1 个字 |
| GPU 利用率 | 高 | 不到 1% |
| 指标 | TTFT(等多久看到第一个字) | TPOT(每个字间隔多久) |
三、KV Cache 的生命周期
每个请求的 KV Cache 都有完整的一生,像一颗 气球 :
吹气(诞生+生长) → 用户发消息,系统分配显存。Prefill 写入初始 KV,Decode 每生成一个字追加一条。气球越吹越大。
最大(峰值) → 对话结束,或达到上下文窗口上限(如 128K token)。气球吹到最大。
放气(消亡) → 请求结束,显存释放。气球瘪了。
这个气球到底有多大?
每个 token 的 KV = 2 × 层数 × KV头数 × 头维度 × 精度字节数
| 模型 | 每 token | 4K 字 | 32K 字 | 128K 字 |
|---|---|---|---|---|
| 7B 小模型 | 128 KB | 512 MB | 4 GB | 16 GB |
| 70B 大模型 | 80 KB | 320 MB | 2.5 GB | 10 GB |
一个人聊天还好,人一多就炸了:
70B 模型 × 128K 上下文 × 64 人同时聊 = 640 GB 。8 张 H100 显卡的 640 GB 总显存,光装"小本本"就满了,模型本身的"大脑"还没地方放。
四、单节点内:瓶颈在"搬"
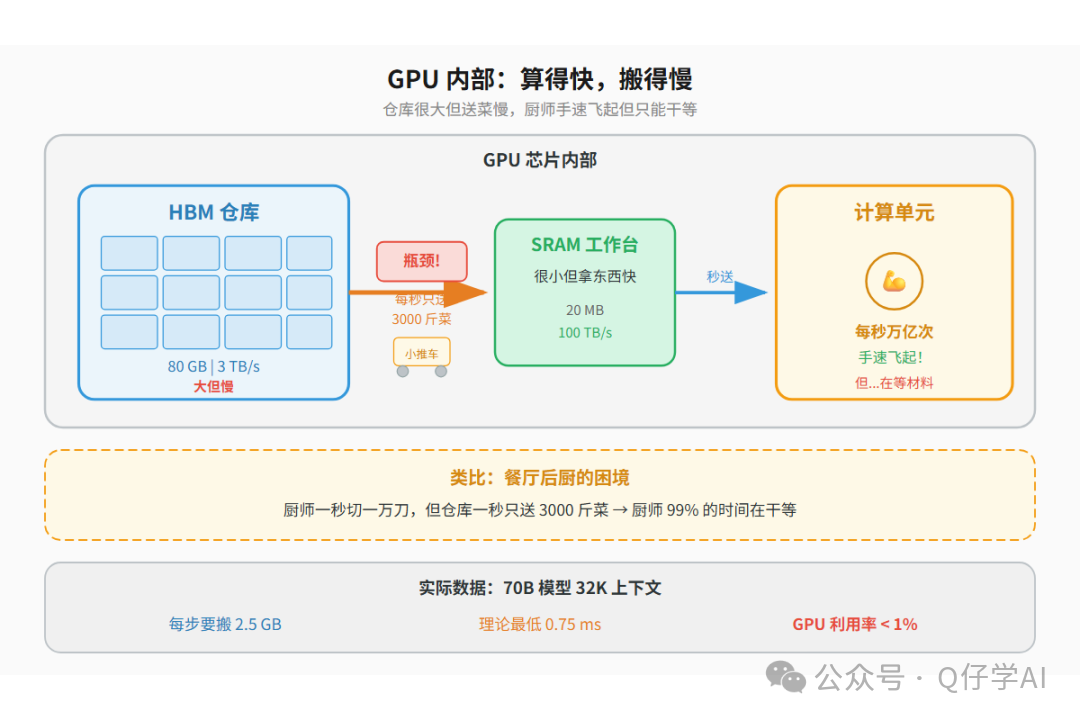
在 GPU 内部,KV Cache 的流动路径是:
HBM(显存仓库) → SRAM(工作台) → 计算单元(厨师的手) 80 GB, 3 TB/s 20 MB, 100 TB/s 每秒万亿次
打个比方:
- HBM = 仓库,很大(80GB),但搬货慢(每秒 3TB)
- SRAM = 工作台,很小(20MB),但拿东西极快(每秒 100TB)
- 计算单元 = 厨师的手,快得飞起(每秒万亿次)
问题 :厨师的手一秒能切一万刀,但仓库每秒只能送 3000 斤菜过来。手再快也没用—— 菜送不过来 。
Decode 阶段每生成一个字,都要把整个 KV Cache 从仓库搬到工作台。70B 模型 32K 上下文时,每步要搬 2.5 GB。H100 带宽 3.35 TB/s,理论最低延迟 0.75 ms。加上模型权重等开销,实际更慢。
算得快,搬得慢 → 瓶颈在搬运(IO Bound)。
这就是 FlashAttention 的意义——它重新安排计算顺序,让厨师在工作台上一次多切几刀,减少往返仓库的次数。
五、集群中:KV Cache 是共享资源
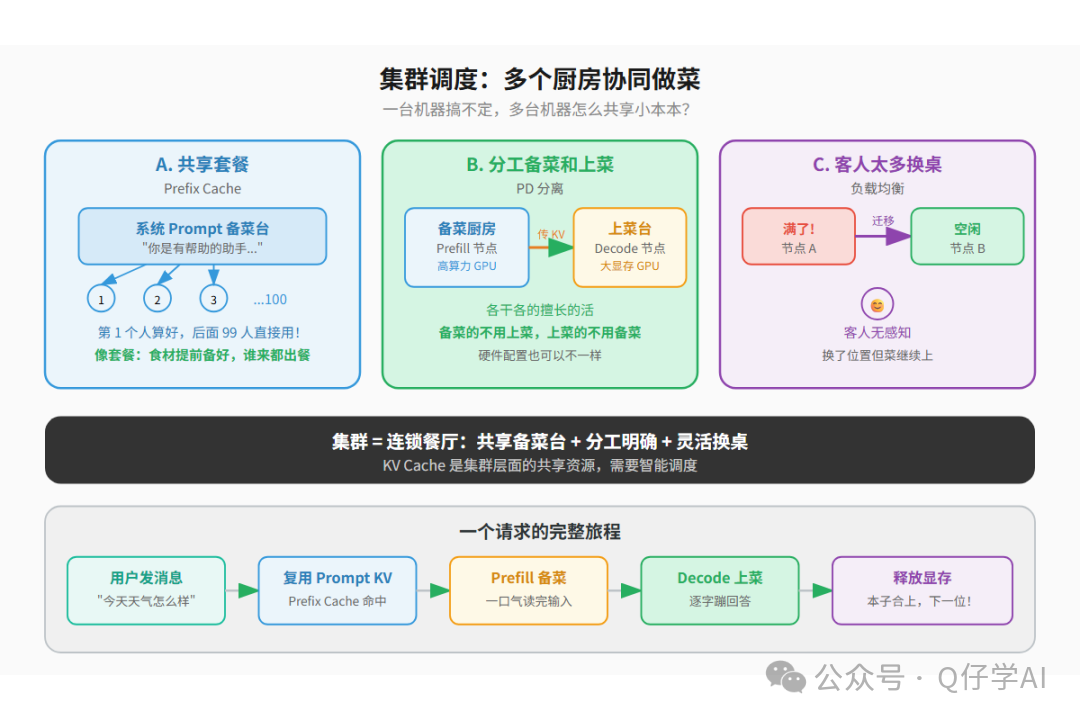
一台机器搞不定 64 个人同时聊天的 KV Cache,那就多台机器组集群。这时 KV Cache 变成了可以 跨机器共享 的资源。
A. Prefix Cache — 共享系统 Prompt
大多数 AI 应用都有系统 Prompt("你是一个有帮助的助手..."),可能长达几千 token。
- 第一个用户来了,系统 Prompt 的 KV Cache 算好,存下来
- 第二个用户来了,同样的系统 Prompt? 直接复用,不算了
- 第 100 个用户来了? 还是复用
就像餐厅的固定套餐——食材提前备好,谁来点直接出餐。
B. PD 分离 — 备菜和上菜分开做
Prefill(备菜)需要强算力,Decode(上菜)需要大显存。两种活对"厨房"的要求完全不同。
- Prefill 节点 :配算力强的 GPU,专门负责"读输入、生成 KV Cache"
- Decode 节点 :配显存大的 GPU,专门负责"翻本子、逐字生成"
Prefill 节点算完后,把 KV Cache 通过网络传给 Decode 节点。各干各的擅长的活。
C. 负载均衡 — 客人太多就换桌
某个节点快满了,把请求迁到空闲节点。KV Cache 跟着请求一起迁移,用户无感知,服务不中断。
就像餐厅满了,服务员带你去另一桌,菜继续上,你感觉不到换了位置。
总结
| 问题 | 答案 |
|---|---|
| KV Cache 是什么? | AI 的小本本,抄下读过的标签和内容 |
| 省了多少? | 计算量从 O(n²) 降到 O(n) |
| 怎么产生? | Prefill 一口气读完,全部抄好 |
| 谁在用? | Decode 逐字生成时翻本子 |
| 生命周期? | 吹气→最大→放气 |
| 占多少显存? | 70B×128K×64人 = 640 GB |
| 单节点瓶颈? | 厨师手快但仓库送菜慢(IO Bound) |
| 集群怎么管? | 共享套餐、分工备菜上菜、换桌 |
KV Cache 贯穿 AI 聊天的每一个环节。下次你和 AI 对话时,可以想象:有一个服务员,正在飞快地翻他的小本本。