Dragonfly + Harbor:AI 集群的 P2P 镜像与大文件分发
版本与阅读边界
本文重点解释大规模镜像与模型分发的架构动机。Dragonfly v1 已归档,现代部署应以 Dragonfly v2 文档为准;v2 的核心角色是 Manager、Scheduler、Seed Peer 和 Peer,其中 Manager 可按部署模型省略。Harbor 的 P2P Preheat 是面向外部 P2P 引擎的预热策略,不等同于运行时拉取链路本身。具体版本兼容性见文末“版本与集成边界”。
在普通 Kubernetes 集群里,镜像拉取通常不是一个特别突出的问题。
但当集群规模从几十台节点扩展到几百台甚至上千台,尤其是在 AI / GPU 集群中,镜像和模型文件动辄几十 GB、上百 GB,这时传统的 Registry → Node 下载模式很容易成为基础设施瓶颈。
一个典型场景:
单个镜像:100 GB
GPU 节点:100 台
理论重复传输量:100 × 100 GB = 10 TB
如果 100 台服务器同时从 Harbor 拉取同一个镜像,就意味着 Harbor 后端存储和出口网络短时间内需要承载接近 10TB 的重复数据传输 。
传统架构:
flowchart LR
    H[Harbor Registry] --> N1[Node 01]
    H --> N2[Node 02]
    H --> N3[Node 03]
    H --> NX[...]
    H --> N100[Node 100]
问题很明显:
- Harbor 出口带宽成为瓶颈
- Registry 后端存储 IOPS 增大
- 核心交换网络产生大量重复流量
- 大规模扩容时容易出现镜像拉取“惊群”
- 节点启动速度受 Harbor 性能影响
而 Dragonfly 要解决的,正是这个问题。
1. Dragonfly 本质上是什么?
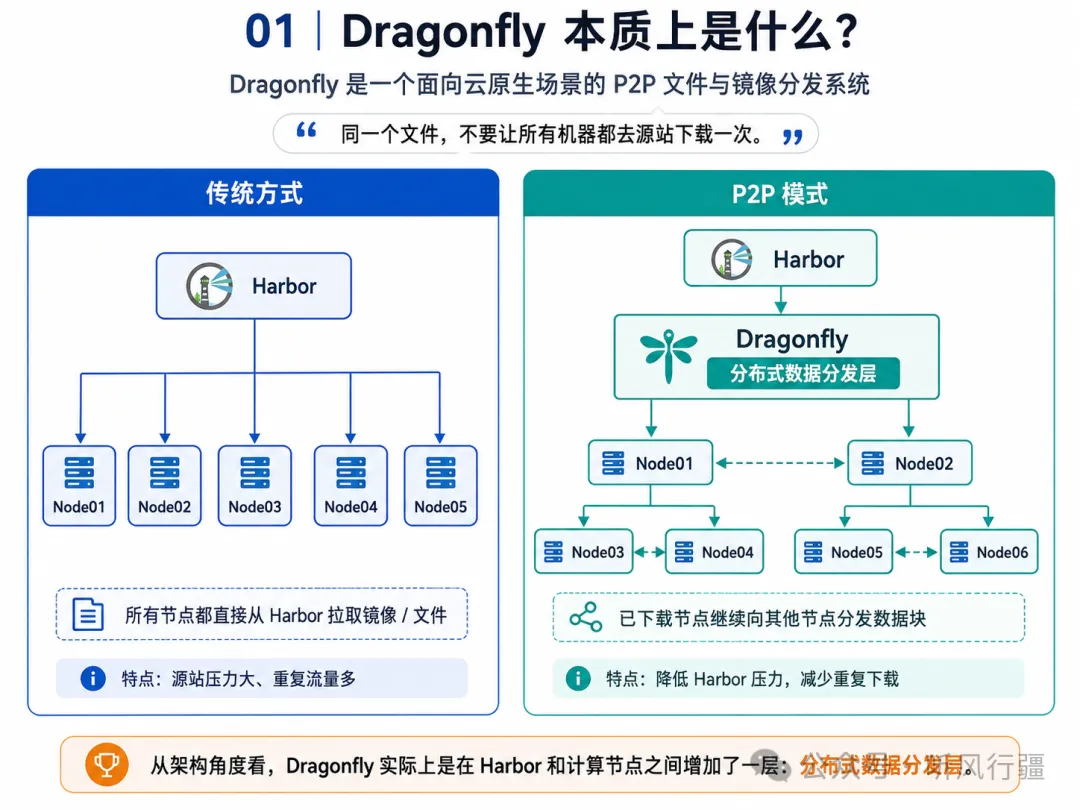
Dragonfly 是一个面向云原生场景的 P2P 文件与镜像分发系统 。
它的核心思想非常简单:
同一个文件,不要让所有机器都去源站下载一次。
而是让已经下载到数据的节点继续向其他节点提供数据。
传统方式:
flowchart LR
    H[Harbor] --> N1[Node 01]
    H --> N2[Node 02]
    H --> N3[Node 03]
    H --> N4[Node 04]
    H --> N5[Node 05]
P2P 模式:
flowchart TB
    H[Harbor 源站] --> D[Dragonfly 分发层]
    D --> N1[Node 01 / Peer]
    D --> N2[Node 02 / Peer]
    N1 --> N3[Node 03 / Peer]
    N1 --> N4[Node 04 / Peer]
    N2 --> N5[Node 05 / Peer]
    N2 --> N6[Node 06 / Peer]
    N3 <--> N4
    N4 <--> N5
这样一来,Harbor 不再承担所有节点的完整下载流量。
节点之间会互相提供已经下载的数据块。
从架构角度看,Dragonfly 实际上是在 Harbor 和计算节点之间增加了一层:分布式数据分发层
2. Harbor 和 Dragonfly 分别负责什么?
很多人第一次接触 Dragonfly 时容易误解:
“用了 Dragonfly,是不是 Harbor 就不需要了?”
不是。
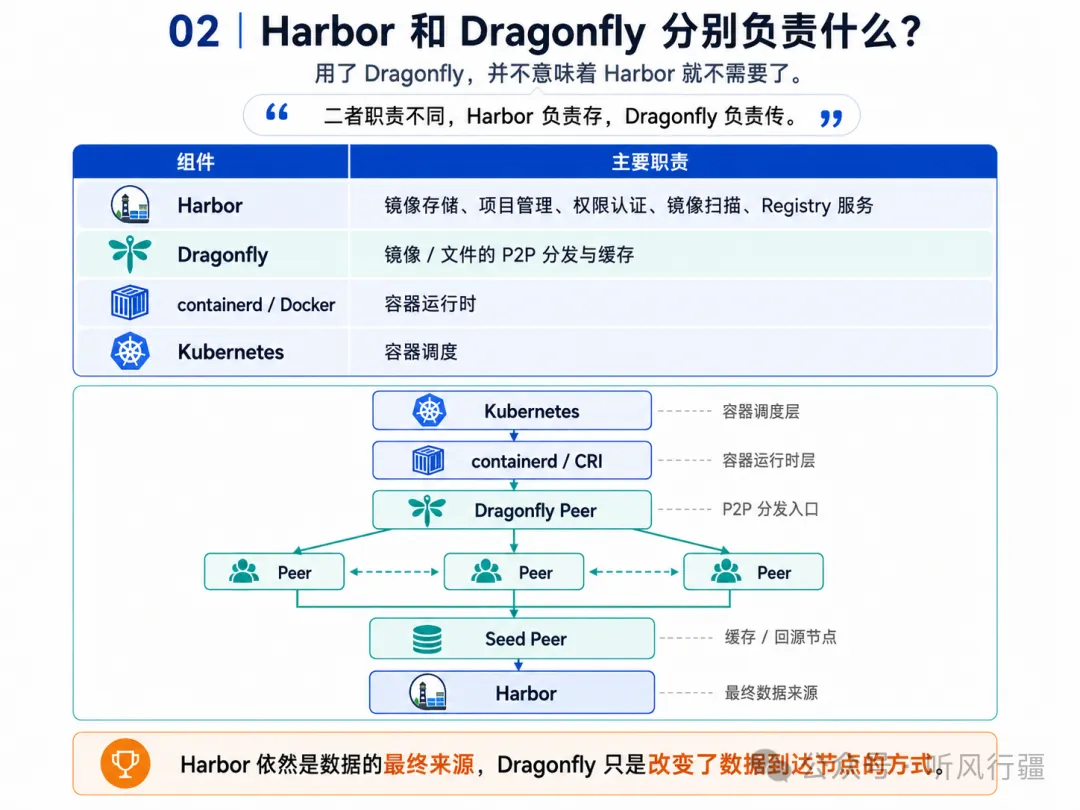
二者职责完全不同。
| 组件 | 主要职责 |
|---|---|
| Harbor | 镜像存储、项目管理、权限认证、镜像扫描、Registry 服务 |
| Dragonfly | 镜像 / 文件的 P2P 分发与缓存 |
| containerd / Docker | 容器运行时 |
| Kubernetes | 容器调度 |
可以简单理解为:
Harbor = 镜像仓库与源站
Dragonfly = 分布式下载加速层

Harbor 仍然是数据的最终来源。
Dragonfly 只是改变了“数据如何到达节点”。
完整链路可以理解为:
flowchart TB
    K[Kubernetes / kubelet] --> C[containerd / CRI]
    C --> P[本机 dfdaemon / Peer]
    P -. 调度请求 .-> S[Scheduler]
    S -. 返回候选父节点 .-> P
    P <--> P1[其他 Peer]
    P <--> P2[其他 Peer]
    SP[Seed Peer] --> P
    H[Harbor] --> SP
    H -. 回源兜底 .-> P
3. 为什么 P2P 可以降低 Harbor 压力?
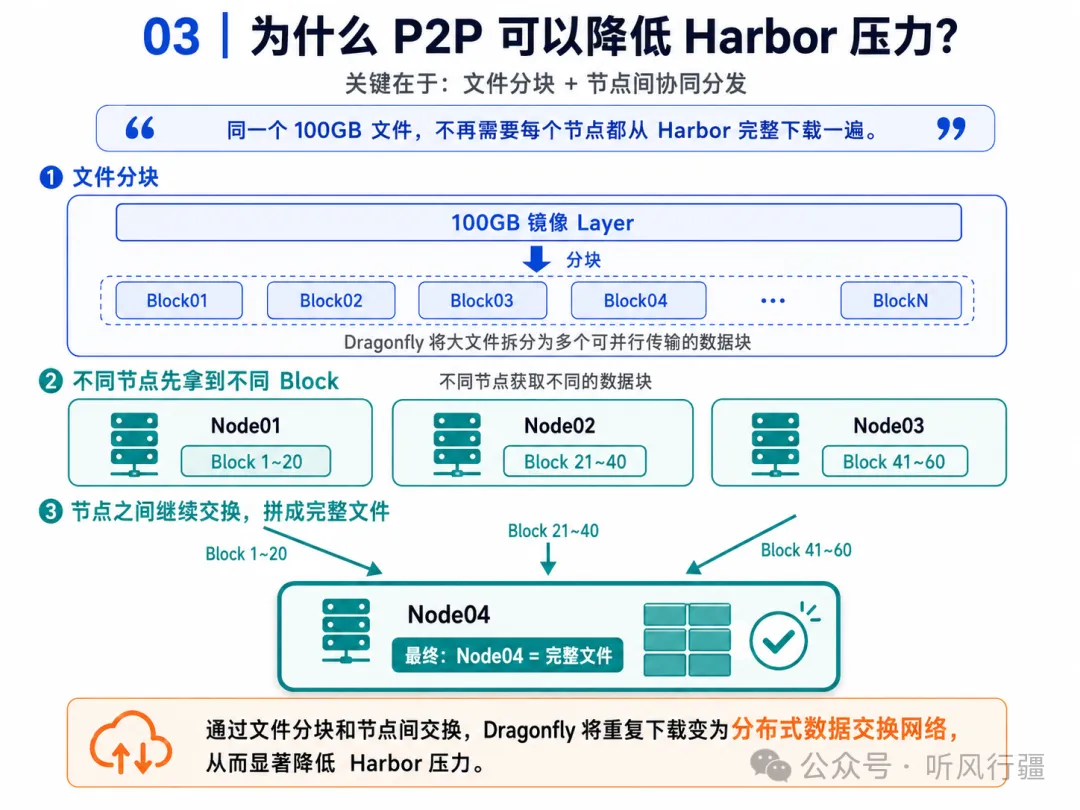
关键在于:
文件分块
Dragonfly 不会简单地把一个 100GB 文件作为整体传输。
而是将文件拆分成多个数据块。
例如:
100 GB 镜像 Layer
  ↓ 分块
Block 01
Block 02
Block 03
Block 04
...
Block N
不同节点可以从不同节点获取不同 Block。
例如:
flowchart LR
    N1["Node 01<br/>Block 1–20"] -->|Block 1–20| N4[Node 04]
    N2["Node 02<br/>Block 21–40"] -->|Block 21–40| N4
    N3["Node 03<br/>Block 41–60"] -->|Block 41–60| N4
    N4 --> F[组装并校验完整文件]
因此整个系统形成一个分布式数据交换网络。
这也是 Dragonfly 能够扩展到大规模集群的重要原因。
4. 传统 Harbor 模式的问题
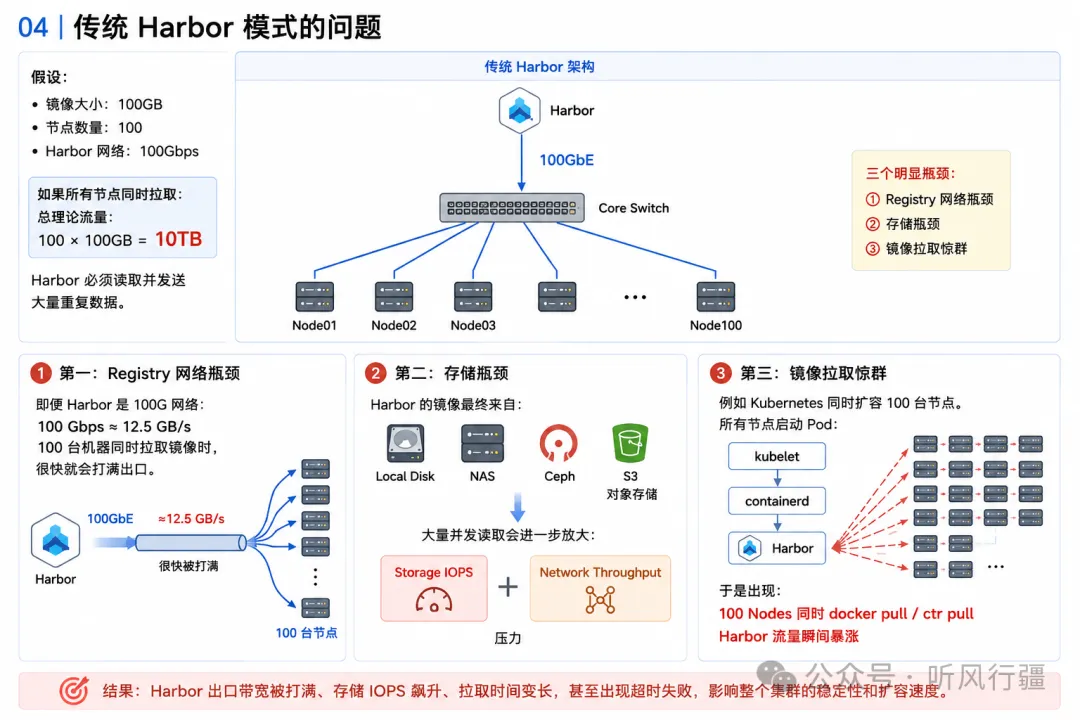
假设:
镜像大小:100 GB
节点数量:100
Harbor 网络:100 Gbps

所有节点同时拉取时,理论重复传输量:
100 × 100 GB = 10 TB
Harbor 必须读取并发送大量重复数据。
架构:
flowchart TB
    H[Harbor] -->|100 GbE 出口| S[Core Switch]
    S --> N1[Node 01]
    S --> N2[Node 02]
    S --> N3[Node 03]
    S --> NX[...]
    S --> N100[Node 100]
这里存在三个明显瓶颈。
第一:Registry 网络瓶颈
100 Gbps ≈ 12.5 GB/s

即便 Harbor 使用 100G 网络,100 台机器同时拉取镜像时,
也可能很快打满出口带宽。
第二:存储瓶颈
Harbor 镜像后端可能是:
- Local Disk
- NAS
- Ceph
- S3 对象存储

大量并发读取会同时放大 Storage IOPS 与 Network Throughput 压力。
第三:镜像拉取惊群
flowchart TB
    E[Kubernetes 同时扩容 100 个节点] --> K[各节点 kubelet 启动 Pod]
    K --> C[containerd 并发拉取]
    C --> H[Harbor 瞬时流量暴涨]
5. Dragonfly 如何改变这个模型?
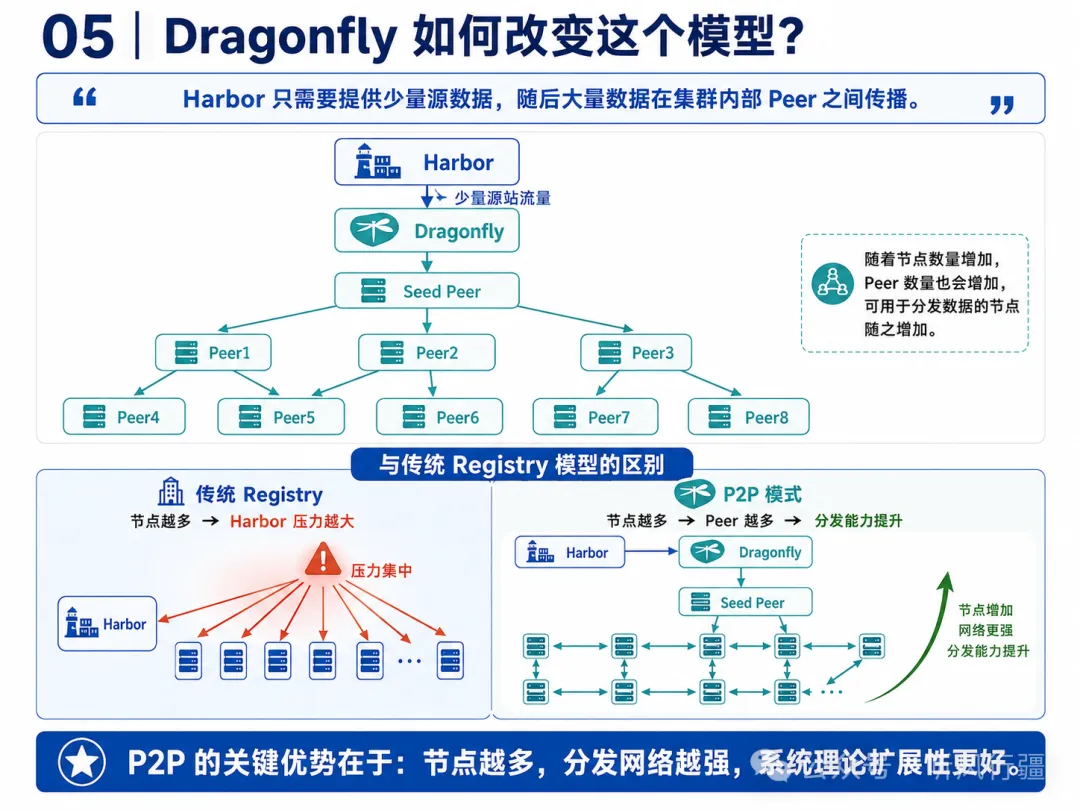
使用 Dragonfly 后:
Harbor 只需要提供少量“源数据”。
之后大量数据由集群内部 Peer 之间传播。
例如:
flowchart TB
    H[Harbor] -->|少量源站流量| SP[Seed Peer]
    SP --> P1[Peer 1]
    SP --> P2[Peer 2]
    SP --> P3[Peer 3]
    P1 --> P4[Peer 4]
    P1 --> P5[Peer 5]
    P2 --> P6[Peer 6]
    P3 --> P7[Peer 7]
    P3 --> P8[Peer 8]
这与传统 Registry 模型最大的区别就在这里。
flowchart LR
    subgraph R[传统 Registry]
      RN[节点越多] --> RH[Harbor 压力越大]
    end
    subgraph D[P2P]
      DN[节点越多] --> DP[可参与分发的 Peer 越多]
      DP --> DC[集群分发能力提升]
    end
6. 老版本 Dragonfly 的实现方式
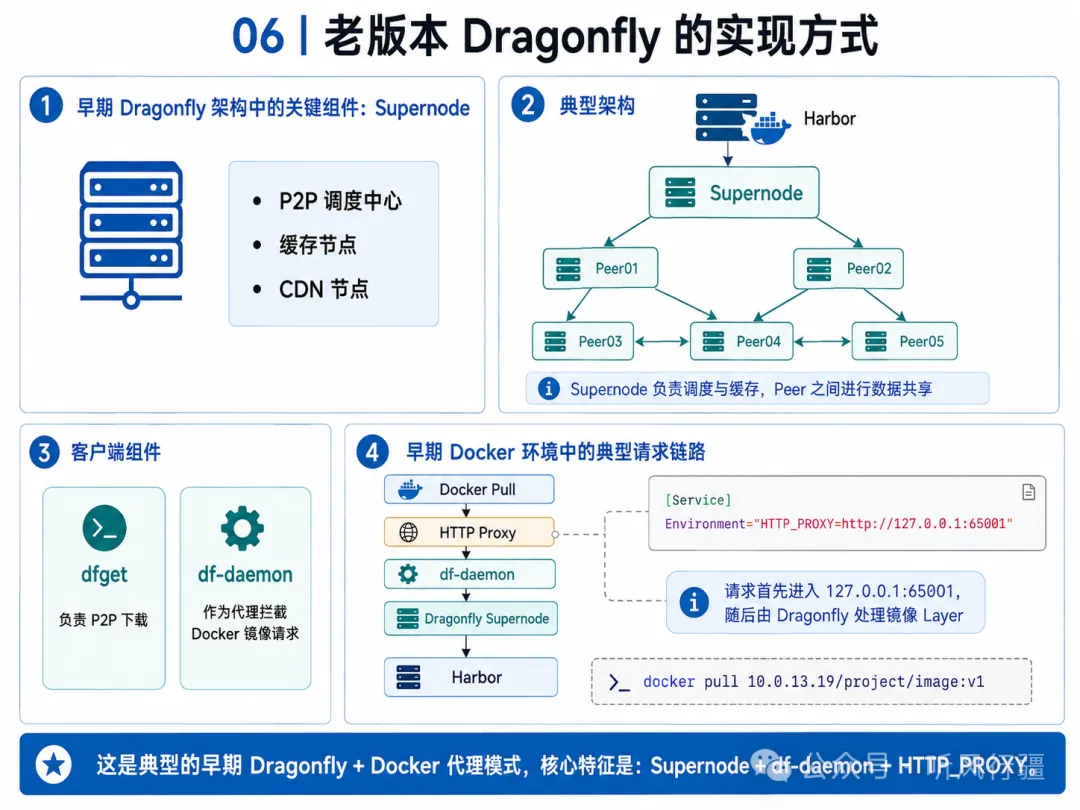
早期 Dragonfly 架构中存在一个重要组件:
Supernode
其角色类似于:
P2P 调度中心
+
缓存节点
+
CDN 节点
典型架构:
flowchart TB
    H[Harbor] --> S[Supernode]
    S --> P1[Peer 01]
    S --> P2[Peer 02]
    P1 <--> P2
    P1 --> P3[Peer 03]
    P1 --> P4[Peer 04]
    P2 --> P4
    P2 --> P5[Peer 05]
客户端主要由:
dfget
df-daemon
组成。
其中:
dfget
负责 P2P 下载。
而:
df-daemon
可以作为代理拦截 Docker 镜像请求。
早期 Docker 环境里常见配置方式是:
flowchart TB
    D[Docker Pull] --> HP[HTTP Proxy]
    HP --> DF[df-daemon]
    DF --> S[Dragonfly Supernode]
    S --> H[Harbor]
例如:
[Service]
Environment="HTTP_PROXY=http://127.0.0.1:65001"
docker pull 10.0.13.19/project/image:v1
请求先进入 127.0.0.1:65001,随后由 Dragonfly 处理镜像 Layer。
7. 为什么这种旧方案现在不建议直接照抄?
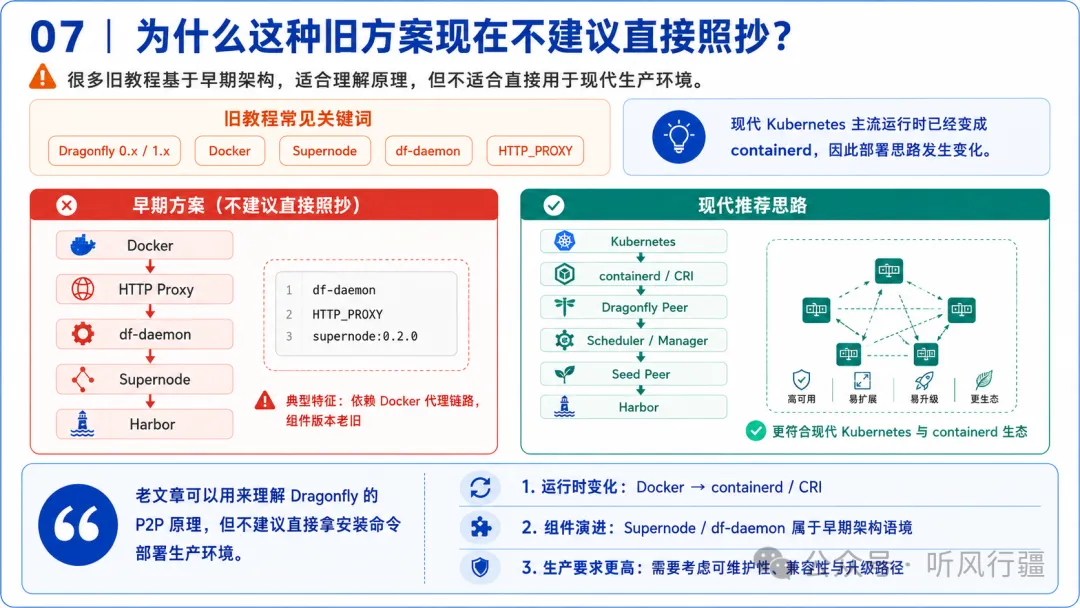
这也是阅读很多 2020~2023 年 Dragonfly 教程时最容易踩坑的地方。
那些文章使用的通常是:
旧教程常见组合:
- Dragonfly 0.x / 1.x
- Docker
- Supernode
- df-daemon
- HTTP_PROXY

现代 Kubernetes 主流容器运行时:
- containerd
现代架构更倾向于:
flowchart TB
    K[Kubernetes / kubelet] --> C[containerd / CRI]
    C --> P[dfdaemon / Peer]
    P -. 获取调度结果 .-> S[Scheduler]
    M[Manager 可选] -. 动态配置与集群管理 .-> S
    M -. 选择 Scheduler 集群 .-> P
    P <--> OP[其他 Peer]
    SP[Seed Peer] --> P
    H[Harbor] --> SP
所以:
老文章可以用来理解 Dragonfly 的 P2P 原理,但不建议直接拿安装命令部署生产环境。
特别是下面这些配置:
df-daemon
HTTP_PROXY
supernode:0.2.0
基本都属于早期 Dragonfly 架构。
8. 一个实际测试结果
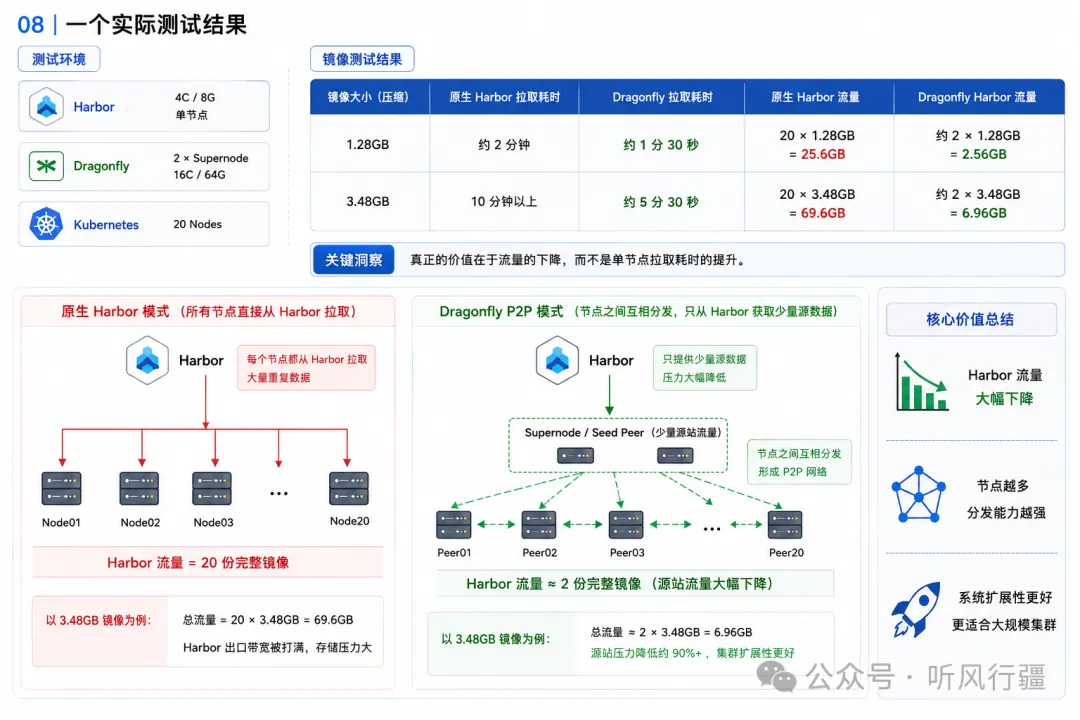
早期一个典型测试环境如下:
Harbor:4C / 8G,单节点
Dragonfly:2 × Supernode,16C / 64G
Kubernetes:20 Nodes
镜像测试:
| 镜像大小 | 原生 Harbor | Dragonfly | 原生 Harbor 流量 | Dragonfly Harbor 流量 |
|---|---|---|---|---|
| 1.28GB | 约 2 分钟 | 约 1 分 30 秒 | 20 × 1.28GB | 约 2 × 1.28GB |
| 3.48GB | 10 分钟以上 | 约 5 分 30 秒 | 20 × 3.48GB | 约 2 × 3.48GB |
这里真正值得关注的,并不是“快了几十秒”。
而是:
Harbor 流量

20 份完整镜像
      ↓
约 2 份源站数据
这才是 Dragonfly 的核心价值。
9. 为什么单节点反而可能更慢?
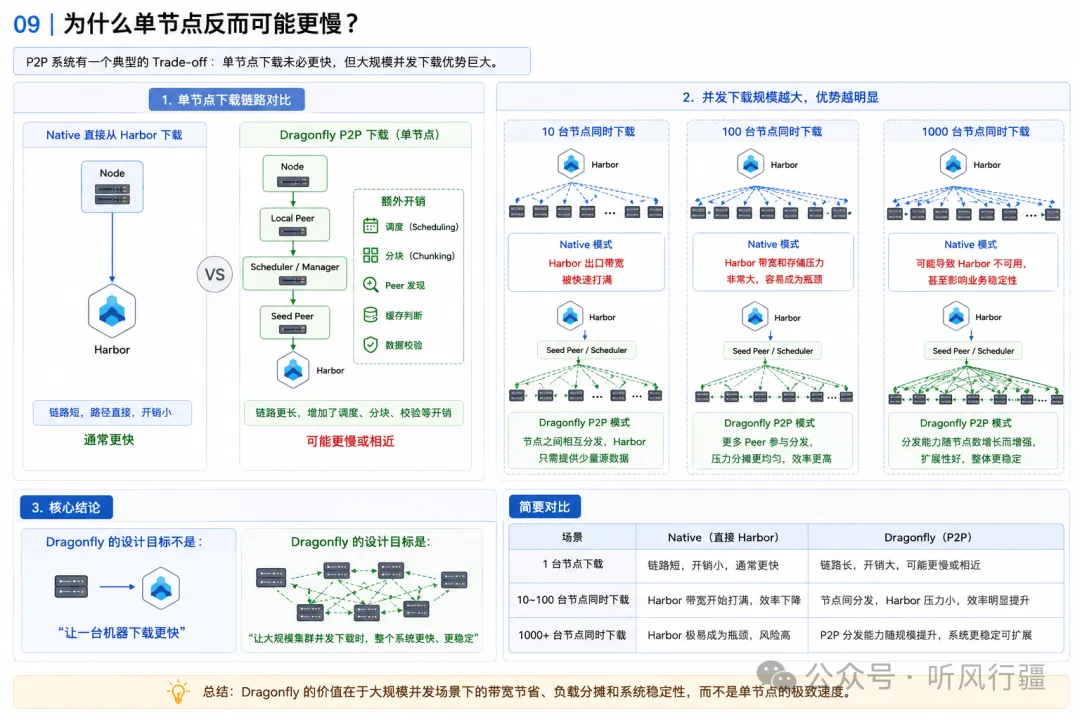
P2P 系统有一个非常典型的 Trade-off。
单节点下载时:
flowchart LR
    N[Node] --> H[Harbor]
链路非常短。
Dragonfly:
flowchart LR
    N[Node] --> P[dfdaemon / Peer]
    P -. 调度 .-> S[Scheduler]
    SP[Seed Peer] --> P
    H[Harbor] --> SP
增加了:
- 调度
- 分块
- Peer 发现
- 缓存判断
- 数据校验
所以:
1 台节点下载
Dragonfly 未必比直接 Harbor 快。
甚至可能略慢。
但如果是:
10 台
100 台
1000 台
同时下载相同镜像,那么 P2P 的优势就会越来越明显。
所以 Dragonfly 的设计目标从来不是:
“让一台机器下载更快。”
而是:
“让大规模集群并发下载时,整个系统更快、更稳定。”
这是两个完全不同的优化目标。
10. Dragonfly 真正适合什么场景?
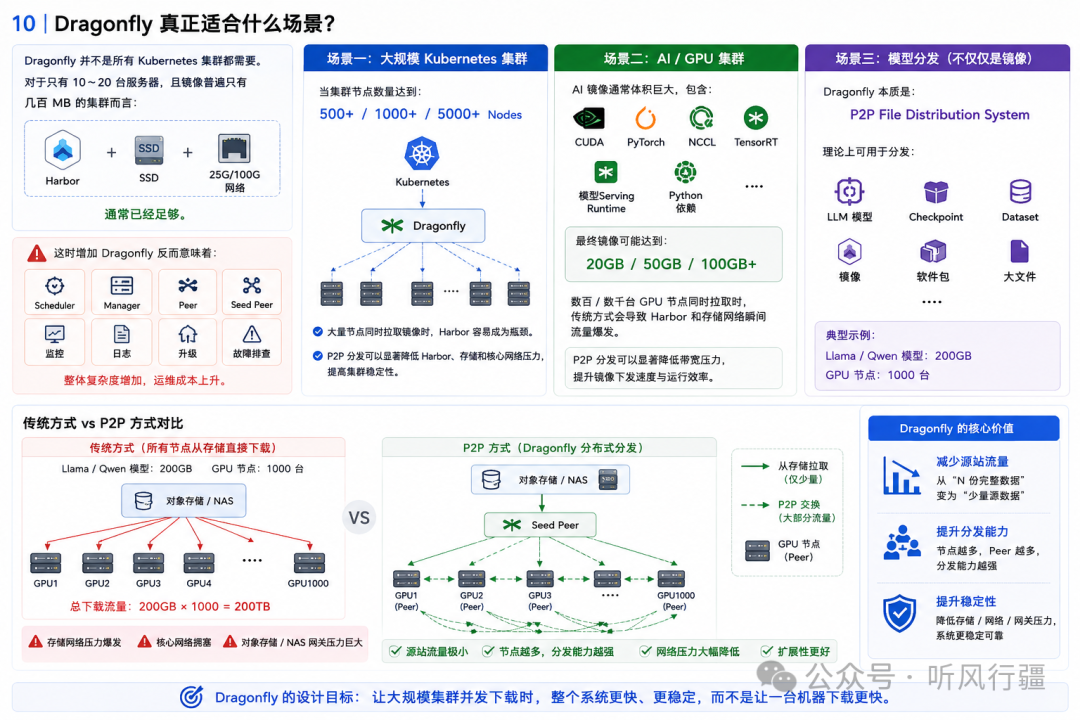
Dragonfly 并不是所有 Kubernetes 集群都需要。
对于只有:
10~20 台服务器
且镜像普遍只有:
几百 MB
的集群而言:
Harbor + SSD + 25G/100G网络
通常已经足够。
这时增加 Dragonfly 反而意味着:
Scheduler
Manager
Peer
Seed Peer
监控
日志
升级
故障排查
整体复杂度增加。
但下面这些场景,Dragonfly 的价值会非常明显。
场景一:大规模 Kubernetes 集群
500+
1000+
5000+ Nodes
场景二:AI / GPU 集群
AI 镜像通常非常大:
CUDA
PyTorch
NCCL
TensorRT
模型 Serving Runtime
Python 依赖
最终镜像可能达到:
20GB
50GB
100GB+
场景三:模型分发
更值得关注的是:
Dragonfly 不只能分发镜像。
它本质是:
P2P File Distribution System
因此理论上可以用于:
LLM模型
Checkpoint
Dataset
镜像
软件包
大文件
例如:
Llama / Qwen 模型:200GB

GPU 节点:1000 台
传统方式:
200GB × 1000

=
200TB
如果全部从对象存储或者 NAS 下载:
存储网络
+
核心网络
+
对象存储 Gateway
都会承受巨大的瞬时流量。
P2P 则可以变成:
flowchart TB
    O[Object Storage] --> SP[Seed Peer]
    SP --> G1[GPU 1 / Peer]
    SP --> G2[GPU 2 / Peer]
    SP --> G3[GPU 3 / Peer]
    G1 --> G4[GPU 4 / Peer]
    G1 --> G5[GPU 5 / Peer]
    G2 --> G6[GPU 6 / Peer]
    G3 --> G7[GPU 7 / Peer]
11. 从 AI 数据中心角度看,Dragonfly 的价值
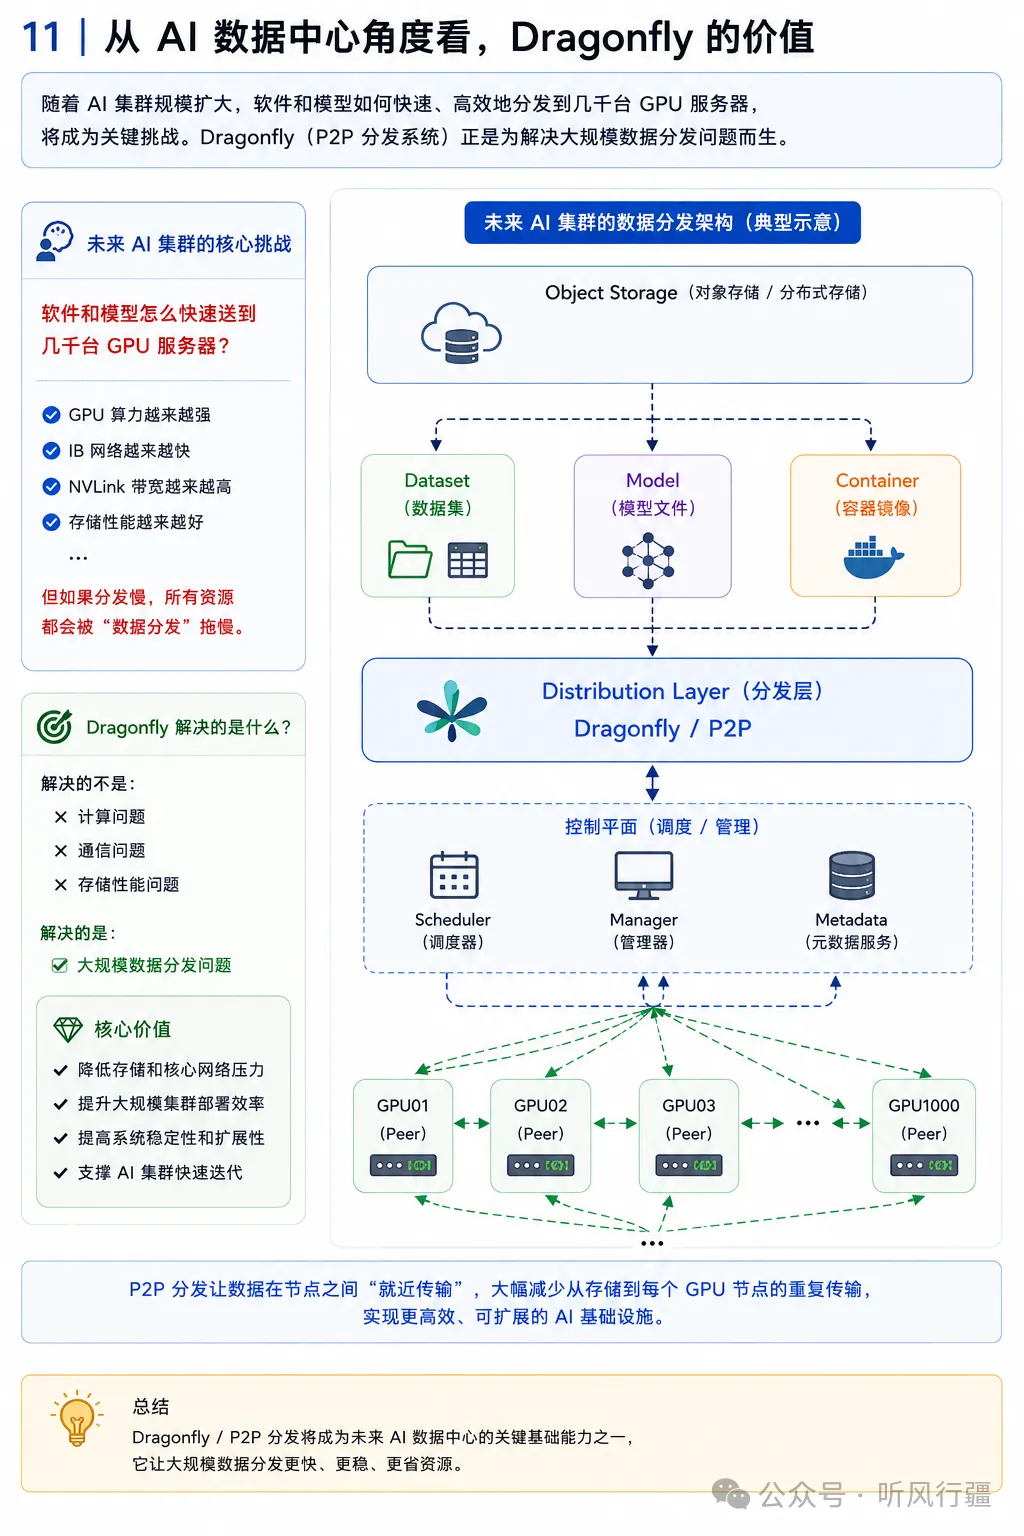
未来 AI 集群的数据分发问题会越来越突出。
很多人现在关注的是:
GPU 算力
IB 网络
NVLink
存储性能
但随着 GPU 集群规模扩大,还有一个经常被忽略的问题:
软件和模型怎么快速送到几千台 GPU 服务器?
未来 AI 集群的数据流可能是:
flowchart TB
    O[Object Storage] --> D[Dataset]
    O --> M[Model]
    O --> C[Container Image]
    D --> L[Dragonfly / P2P Distribution Layer]
    M --> L
    C --> L
    L --> G1[GPU 01 / Peer]
    L --> G2[GPU 02 / Peer]
    L --> G3[GPU 03 / Peer]
    L --> GX[...]
    L --> G1000[GPU 1000 / Peer]
因此 P2P 分发实际上可能成为 AI 基础设施中的一个重要基础能力。
它解决的不是:
计算问题
而是:大规模数据分发问题
12. Dragonfly 的优缺点
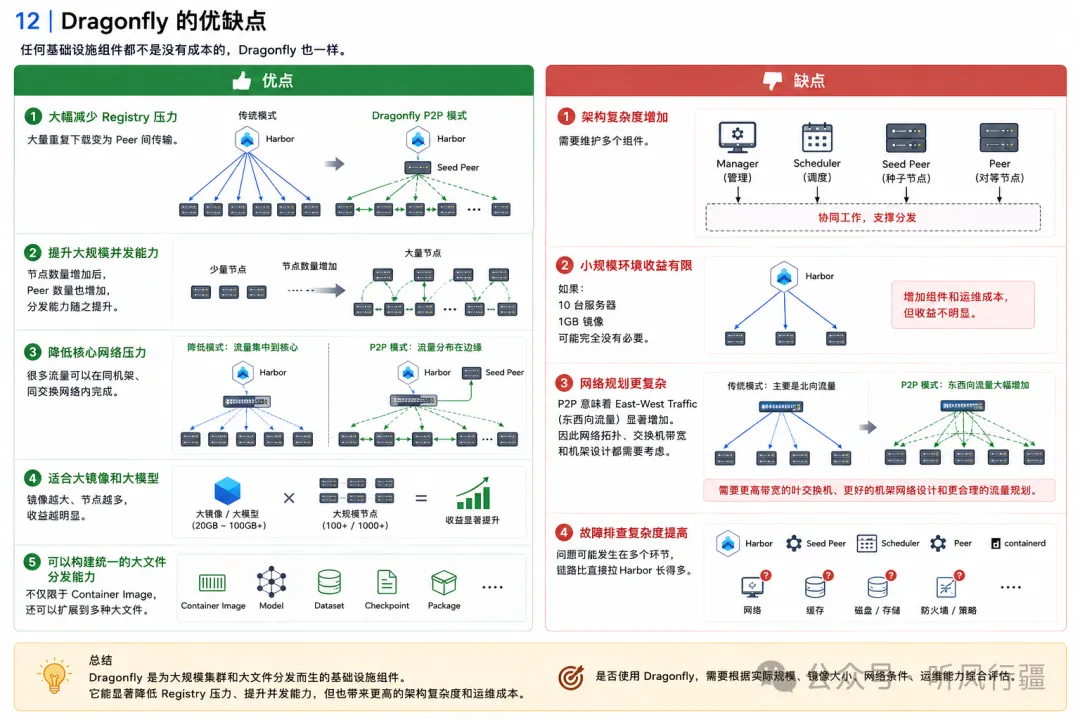
任何基础设施组件都不是没有成本的。
Dragonfly 也一样。
优点
① 大幅减少 Registry 压力
大量重复下载变为 Peer 间传输。
② 提升大规模并发能力
节点数量增加后,Peer 数量也增加。
③ 降低核心网络压力
很多流量可以在同机架、同交换网络内完成。
④ 适合大镜像和大模型
镜像越大、节点越多,收益越明显。
⑤ 可以构建统一的大文件分发能力
不仅限于:
Container Image
还可以扩展到:
Model
Dataset
Checkpoint
Package
缺点
① 架构复杂度增加
需要维护:
Manager
Scheduler
Seed Peer
Peer
② 小规模环境收益有限
如果:
10 台服务器
1 GB 镜像
可能完全没有必要。
③ 网络规划更复杂
P2P 意味着:
East-West Traffic
显著增加。
因此网络拓扑、交换机带宽和机架设计都需要考虑。
④ 故障排查复杂度提高
问题可能发生在:
Harbor
Seed Peer
Scheduler
Peer
containerd
网络
缓存
链路比直接拉 Harbor 长得多。
13. 一个值得关注的趋势
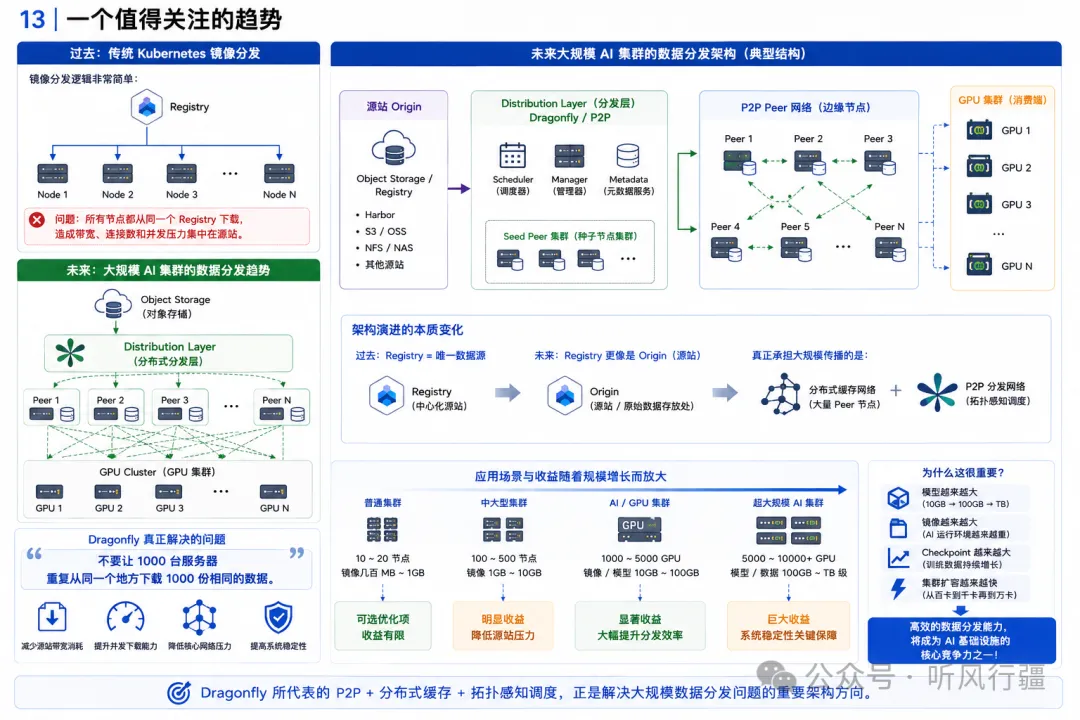
过去 Kubernetes 的镜像分发逻辑基本是:
Registry
   ↓
Node
未来大规模 AI 集群的数据分发很可能逐渐变成:
flowchart TB
    O[Object Storage / Registry] --> L[Distribution Layer]
    L --> P1[Peer]
    L --> P2[Peer]
    L --> P3[Peer]
    P1 --> G[GPU Cluster]
    P2 --> G
    P3 --> G
也就是说:
Registry
未来可能越来越像:
源站 Origin
而真正承担大规模数据传播的,是:
分布式缓存
+
P2P 分发网络
从这个角度理解 Dragonfly,就比单纯把它理解为一个“Docker 镜像加速工具”更准确。
14. 版本与集成边界
- Dragonfly v1 已归档,v2 对 v1 做了完整重构,二者不兼容。旧教程中的 Supernode、
df-daemon、DockerHTTP_PROXY适合帮助理解历史架构,不应直接作为现代生产部署模板。 - Dragonfly v2 官方架构将服务分为 Manager、Scheduler、Seed Peer 和 Peer。Scheduler 负责选择下载父节点;Peer/Seed Peer/源站承担数据传输。Manager 主要负责动态配置、多 P2P 集群关系、指标和控制台,在部分部署模型中是可选组件。
- Harbor 的 P2P Preheat 需要先部署外部 P2P 引擎,再由 Harbor 通过 Provider 与项目级策略进行预热。根据 Harbor 2.14 文档,Harbor
>= 2.12.0对应 Dragonfly>= 2.1.59;实际部署仍应检查所用 Harbor 与 Dragonfly 版本的官方兼容矩阵。 - 本文测试数据来自原文中的早期环境,只能说明该场景下源站流量下降,不应直接外推为其他网络、镜像结构或 Dragonfly 版本的性能结论。
官方参考:
相关阅读
总结
Dragonfly 真正解决的问题可以总结成一句话:
不要让 1000 台服务器重复从同一个地方下载 1000 份相同的数据。
对于普通 Kubernetes 集群,这可能只是一个优化项。
但对于未来:
1000 GPU
5000 GPU
10000 GPU
规模的 AI 集群而言,随着:
模型越来越大
镜像越来越大
Checkpoint 越来越大
集群扩容越来越快
如何高效完成软件、镜像和模型分发,会成为一个越来越重要的基础设施问题。
而 Dragonfly 所代表的:
P2P + 分布式缓存 + 拓扑感知调度
正是解决这一问题的一种重要架构方向。