Kubernetes 原生部署 Prometheus 与 Grafana
本文合并了三份 Kubernetes 原生部署与 Grafana 笔记。主流程固定使用 Prometheus v2.33.5 与 Grafana v8.4.5,保留旧版 v2.2.1 的架构、应用监控和 Pushgateway 实验经验,以及 Grafana v5.0.4 的界面、面板排障与 kube-state-metrics 实验。这里的版本用于复现实验,不代表当前生产版本建议。PromQL 语法集中在 Prometheus 基础;Operator/Helm 部署见 Prometheus Stack。
1. 监控范围与部署方案
Kubernetes 监控至少覆盖以下对象:
- 节点操作系统:Node Exporter 提供 CPU、内存、文件系统和网络指标。
- 容器:通过 kubelet 的 cAdvisor 指标观察容器资源用量。
- 控制面:抓取 API Server、Scheduler、Controller Manager 等组件指标;后两者的端点配置见 系统组件监控。
- 应用与 Service:应用自身暴露
/metrics,或通过 Exporter 暴露指标,再由 Prometheus 服务发现。 - 可视化:Grafana 以 Prometheus 为数据源构建仪表盘。
高可用与联邦
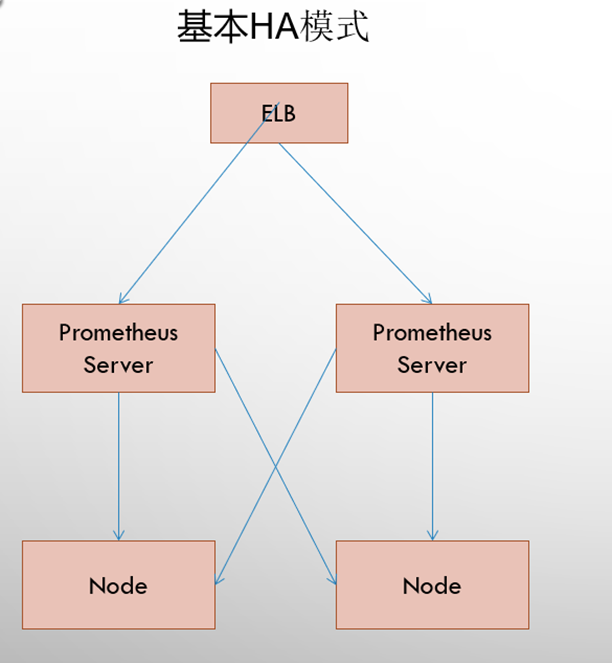
- 双实例 HA:两个 Prometheus 独立抓取同一批目标,可提高查询和采集可用性;各自的本地 TSDB 不会自动同步,需处理查询层去重和持久化。
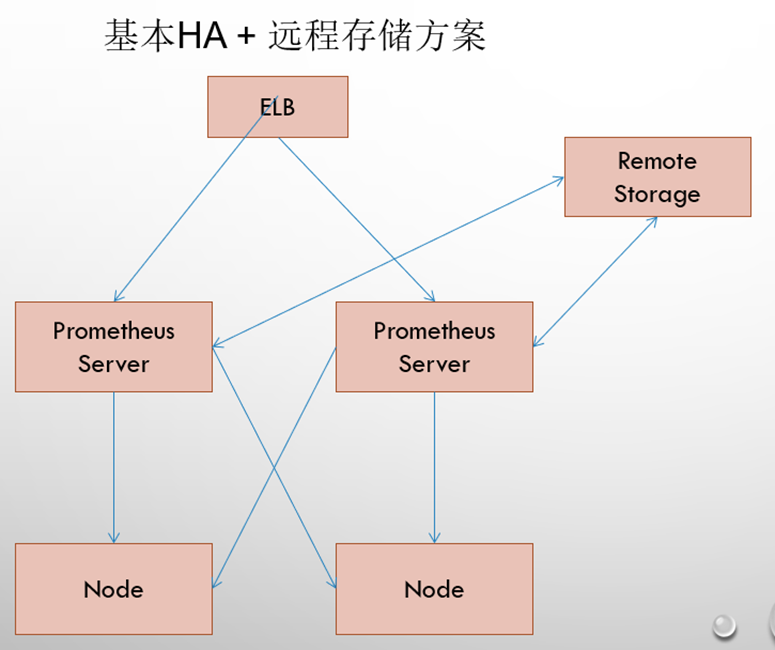
- HA + 远程存储:通过 remote write 等方式保存较长期数据;远程存储能力、查询路径与恢复方式取决于具体后端,不能仅凭启用远程写入就假定数据自动恢复。
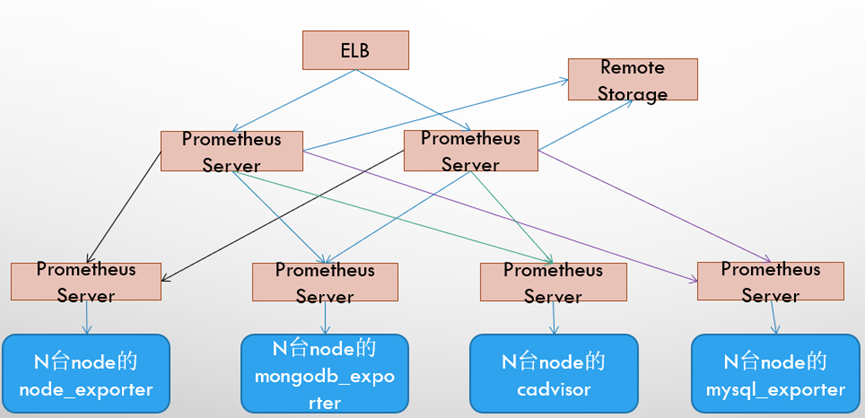
- HA + 远程存储 + 联邦:下层 Prometheus 分担不同抓取任务,上层通过
/federate汇聚选定序列。联邦适合分层聚合,不会自动复制全部数据;配置示例见 联邦集群。
2. 部署 Node Exporter
Node Exporter 以 DaemonSet 运行在各节点,并从宿主机根目录读取文件系统信息。容器化部署需明确 --path.rootfs 与挂载路径的对应关系;如下示例不需要 privileged: true、hostIPC 或 hostPID。镜像版本以部署时经过验证的版本为准,升级前检查参数兼容性。
apiVersion: v1
kind: Namespace
metadata:
  name: monitor-sa
---
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: node-exporter
  namespace: monitor-sa
spec:
  selector:
    matchLabels:
      app: node-exporter
  template:
    metadata:
      labels:
        app: node-exporter
    spec:
      hostNetwork: true
      tolerations:
        - key: node-role.kubernetes.io/control-plane
          operator: Exists
          effect: NoSchedule
        - key: node-role.kubernetes.io/master
          operator: Exists
          effect: NoSchedule
      containers:
        - name: node-exporter
          image: quay.io/prometheus/node-exporter:v1.12.1
          args:
            - --path.rootfs=/host
            - --collector.filesystem.mount-points-exclude=^/(dev|proc|sys|var/lib/docker/.+|var/lib/kubelet/pods/.+)($|/)
          ports:
            - name: metrics
              containerPort: 9100
              hostPort: 9100
          volumeMounts:
            - name: host
              mountPath: /host
              readOnly: true
              mountPropagation: HostToContainer
      volumes:
        - name: host
          hostPath:
            path: /
            type: Directory
验证时按实际节点地址替换示例 IP:
kubectl -n monitor-sa get ds node-exporter
curl http://192.0.2.10:9100/metrics
版本差异
旧笔记使用 prom/node-exporter:v0.16.0、--collector.filesystem.ignored-mount-points 和宿主机多个目录挂载;合并后的示例改用当前 Node Exporter 的 --path.rootfs 与 --collector.filesystem.mount-points-exclude 参数。
3. 部署 Prometheus
3.1 创建 ServiceAccount 与只读发现权限
旧笔记将 cluster-admin 绑定给监控账号,还重复绑定了一个写错命名空间的 User。服务发现只需要读取相应资源;以下示例显式授权所用的 node、endpoints 与 kubelet 代理路径。按集群实际指标端点调整权限。
apiVersion: v1
kind: ServiceAccount
metadata:
  name: monitor
  namespace: monitor-sa
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  name: prometheus-discovery
rules:
  - apiGroups: [""]
    resources: ["nodes", "services", "endpoints", "pods"]
    verbs: ["get", "list", "watch"]
  - apiGroups: [""]
    resources: ["nodes/proxy"]
    verbs: ["get"]
  - nonResourceURLs: ["/metrics"]
    verbs: ["get"]
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRoleBinding
metadata:
  name: prometheus-discovery
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: ClusterRole
  name: prometheus-discovery
subjects:
  - kind: ServiceAccount
    name: monitor
    namespace: monitor-sa
3.2 配置抓取目标
kubernetes-node:发现 Node 后抓取该节点的 Node Exporter:9100。kubernetes-node-cadvisor:通过 API Server 的节点代理访问 kubelet/metrics/cadvisor。kubernetes-apiserver:发现default/kubernetesService 的 HTTPS 端点。kubernetes-service-endpoints:仅抓取标有prometheus.io/scrape: "true"的 Service 端点,并尊重端口、协议和路径注解。
以下配置沿用原文的 endpoints 发现角色,适合复现所述 Prometheus 2.x 实验;新集群也可根据 EndpointSlice 的使用情况改为 endpointslice 角色及对应标签。Service 注解并非 Kubernetes 自动采集机制,只有此处的 relabel 规则启用后才会生效。
apiVersion: v1
kind: ConfigMap
metadata:
  name: prometheus-config
  namespace: monitor-sa
data:
  prometheus.yml: |
    global:
      scrape_interval: 15s
      scrape_timeout: 10s
      evaluation_interval: 1m
    scrape_configs:
      - job_name: kubernetes-node
        kubernetes_sd_configs:
          - role: node
        relabel_configs:
          - source_labels: [__meta_kubernetes_node_address_InternalIP]
            regex: (.+)
            replacement: $1:9100
            target_label: __address__
          - action: labelmap
            regex: __meta_kubernetes_node_label_(.+)
      - job_name: kubernetes-node-cadvisor
        kubernetes_sd_configs:
          - role: node
        scheme: https
        tls_config:
          ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crt
        bearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/token
        relabel_configs:
          - action: labelmap
            regex: __meta_kubernetes_node_label_(.+)
          - target_label: __address__
            replacement: kubernetes.default.svc:443
          - source_labels: [__meta_kubernetes_node_name]
            regex: (.+)
            target_label: __metrics_path__
            replacement: /api/v1/nodes/$1/proxy/metrics/cadvisor
      - job_name: kubernetes-apiserver
        kubernetes_sd_configs:
          - role: endpoints
        scheme: https
        tls_config:
          ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crt
        bearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/token
        relabel_configs:
          - source_labels: [__meta_kubernetes_namespace, __meta_kubernetes_service_name, __meta_kubernetes_endpoint_port_name]
            action: keep
            regex: default;kubernetes;https
      - job_name: kubernetes-service-endpoints
        kubernetes_sd_configs:
          - role: endpoints
        relabel_configs:
          - source_labels: [__meta_kubernetes_service_annotation_prometheus_io_scrape]
            action: keep
            regex: "true"
          - source_labels: [__meta_kubernetes_service_annotation_prometheus_io_scheme]
            action: replace
            target_label: __scheme__
            regex: (https?)
          - source_labels: [__meta_kubernetes_service_annotation_prometheus_io_path]
            action: replace
            target_label: __metrics_path__
            regex: (.+)
          - source_labels: [__address__, __meta_kubernetes_service_annotation_prometheus_io_port]
            action: replace
            target_label: __address__
            regex: ([^:]+)(?::\d+)?;(\d+)
            replacement: $1:$2
          - action: labelmap
            regex: __meta_kubernetes_service_label_(.+)
          - source_labels: [__meta_kubernetes_namespace]
            target_label: kubernetes_namespace
          - source_labels: [__meta_kubernetes_service_name]
            target_label: kubernetes_name
3.3 准备存储并部署
以下示例使用 PVC。它必须由支持 Prometheus 本地 TSDB 的 POSIX 兼容块/本地文件系统提供;请按集群实际 StorageClass 创建 PVC,不要照搬旧笔记的 NFS 示例。实验环境也可将 prometheus-data 卷换成 emptyDir: {},但 Pod 重建会丢失本地数据。旧版 hostPath: /data 需要固定调度节点和正确的目录属主,不能用 chmod 777 代替权限规划。
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: prometheus-data
  namespace: monitor-sa
spec:
  accessModes: [ReadWriteOnce]
  resources:
    requests:
      storage: 20Gi
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: prometheus-server
  namespace: monitor-sa
spec:
  replicas: 1
  selector:
    matchLabels:
      app: prometheus-server
  template:
    metadata:
      labels:
        app: prometheus-server
    spec:
      serviceAccountName: monitor
      securityContext:
        fsGroup: 65534
      containers:
        - name: prometheus
          image: prom/prometheus:v2.33.5
          args:
            - --config.file=/etc/prometheus/prometheus.yml
            - --storage.tsdb.path=/prometheus
            - --storage.tsdb.retention.time=30d
            - --web.enable-lifecycle
          ports:
            - name: http
              containerPort: 9090
          volumeMounts:
            - name: config
              mountPath: /etc/prometheus
              readOnly: true
            - name: data
              mountPath: /prometheus
      volumes:
        - name: config
          configMap:
            name: prometheus-config
        - name: data
          persistentVolumeClaim:
            claimName: prometheus-data
---
apiVersion: v1
kind: Service
metadata:
  name: prometheus
  namespace: monitor-sa
spec:
  selector:
    app: prometheus-server
  ports:
    - name: http
      port: 9090
      targetPort: http
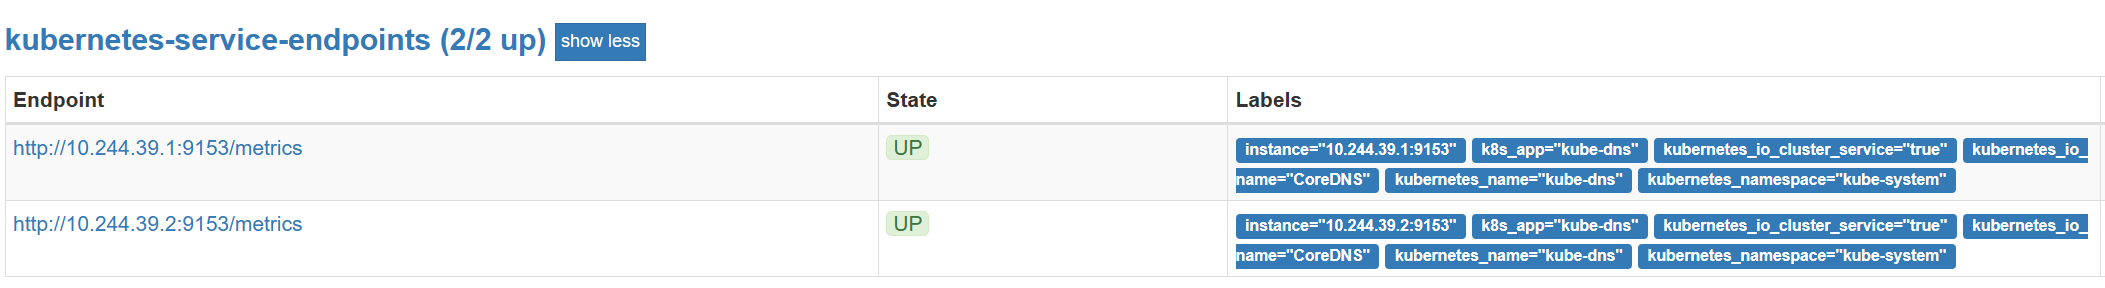
安装顺序:先创建 Namespace、Node Exporter,再应用 RBAC、ConfigMap、PVC、Deployment 与 Service。可用 kubectl -n monitor-sa port-forward svc/prometheus 9090:9090 访问 UI;在 Status → Targets 检查四个 job 及失败原因。旧实验中 CoreDNS Service 带有 prometheus.io/port: 9153 与 prometheus.io/scrape: true,因此能被上述注解规则发现:
3.4 更新配置
- 修改并应用 ConfigMap;先检查 YAML 结构及 Prometheus 配置。
- 若启用了
--web.enable-lifecycle,向 Prometheus 的/-/reload发送 POST 请求。更新 ConfigMap 本身不会让运行中的 Prometheus 自动重新读取配置。 - 回到 Status → Configuration 和 Status → Targets 确认生效。将生命周期接口限制在可信网络内。
kubectl -n monitor-sa port-forward svc/prometheus 9090:9090
curl -X POST http://127.0.0.1:9090/-/reload
也可以向进程发送 SIGHUP。不要通过删除 PVC 或数据目录来触发配置更新。
4. Grafana 部署与可视化
4.1 主流程:Grafana v8.4.5
Grafana 数据目录为 /var/lib/grafana。旧笔记同时挂载 /var、/var/lib/grafana,并给匿名用户 Admin 权限;下面保留单一数据卷和管理员登录。示例 Secret 请在部署时填入实际密码,避免把明文写入 Git。
kubectl -n monitor-sa create secret generic grafana-admin \
  --from-literal=admin-password='<strong-password>'
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: grafana-data
  namespace: monitor-sa
spec:
  accessModes: [ReadWriteOnce]
  resources:
    requests:
      storage: 2Gi
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: grafana
  namespace: monitor-sa
spec:
  replicas: 1
  selector:
    matchLabels:
      app: grafana
  template:
    metadata:
      labels:
        app: grafana
    spec:
      securityContext:
        fsGroup: 472
      containers:
        - name: grafana
          image: grafana/grafana:8.4.5
          ports:
            - name: http
              containerPort: 3000
          env:
            - name: GF_SECURITY_ADMIN_PASSWORD
              valueFrom:
                secretKeyRef:
                  name: grafana-admin
                  key: admin-password
          volumeMounts:
            - name: data
              mountPath: /var/lib/grafana
      volumes:
        - name: data
          persistentVolumeClaim:
            claimName: grafana-data
---
apiVersion: v1
kind: Service
metadata:
  name: grafana
  namespace: monitor-sa
spec:
  selector:
    app: grafana
  ports:
    - name: http
      port: 80
      targetPort: http
- 运行
kubectl -n monitor-sa port-forward svc/grafana 3000:80,访问http://127.0.0.1:3000并用刚设置的管理员密码登录。若需从集群外访问,按环境选择 Ingress 或将 Service 改为 NodePort,并配置认证与网络访问限制。 - 在 Data sources 添加 Prometheus,URL 使用集群内地址
http://prometheus.monitor-sa.svc:9090。 - 导入原实验中的 Node Exporter、Docker 监控模板(记录的 Dashboard ID:
8919、9276、11074),按实际指标与版本检查面板查询。


历史部署差异
原 Grafana 实验将 Pod 放在 kube-system,采用 grafana/grafana:8.4.5 镜像、NodePort 暴露,并示例了两个 NFS PVC;其中 PVC 却写在 monitor-sa 命名空间,无法被 kube-system 的 Pod 挂载。合并后的示例统一使用 monitor-sa 命名空间。
4.2 旧版 Grafana v5.0.4 实验记录
早期实验使用 k8s.gcr.io/heapster-grafana-amd64:v5.0.4,在 kube-system 创建 monitoring-grafana Deployment 和 NodePort Service。它与上面的 Grafana v8.4.5 主流程承担相同的部署与数据源配置,因此无需再维护一份重复的 Deployment YAML。若需要复现旧环境,应先确认镜像来源与 Kubernetes 兼容性;docker load -i 的参数应是本地镜像归档文件路径,而非镜像名称。
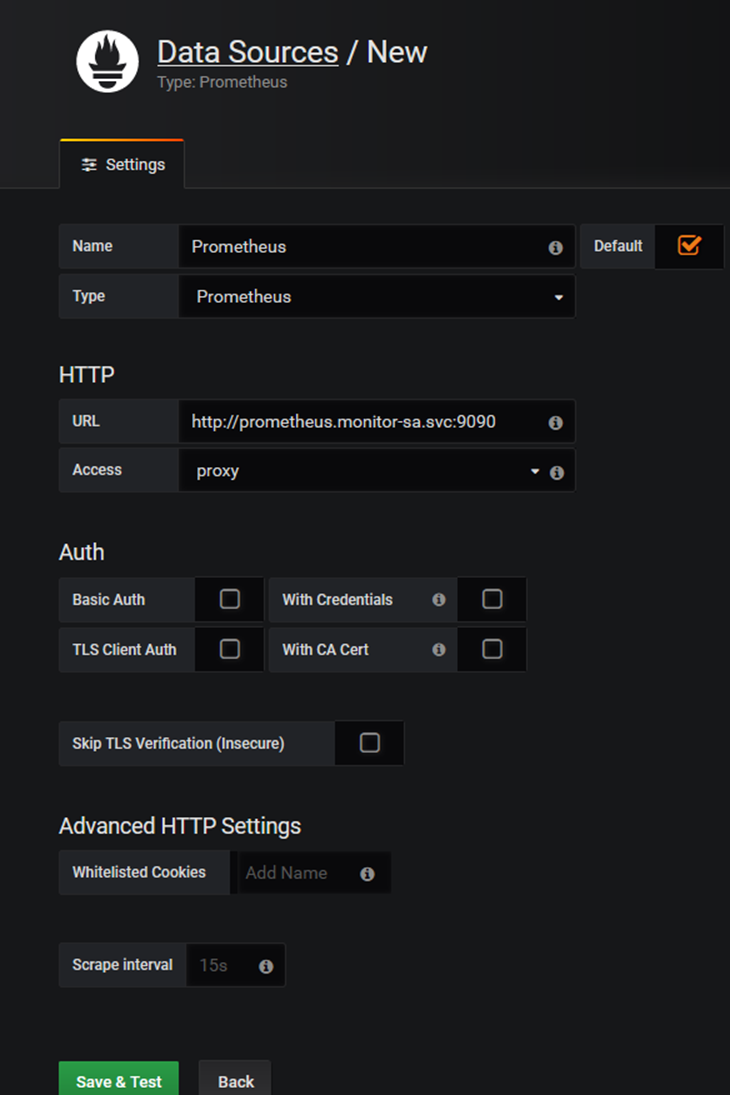
旧版 UI 中,从 Create your first data source 选择 Prometheus,填写 http://prometheus.monitor-sa.svc.cluster.local:9090,再点击 Save & Test。v5 实验的配置页面如下:
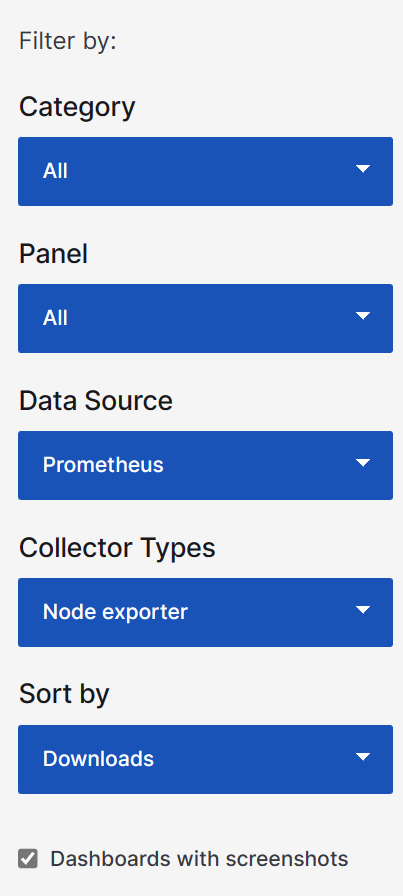
原实验从 Grafana Dashboards 查找模板,包括 Node Exporter Full,并导入 docker_rev1.json 与 node_exporter.json。这些模板可能依赖旧版 Exporter 指标,导入后要逐个验证。
旧 Deployment 中的 GF_AUTH_ANONYMOUS_ENABLED=true 与 GF_AUTH_ANONYMOUS_ORG_ROLE=Admin 会赋予匿名访问者管理权限,合并后的部署示例已删除这组设置。INFLUXDB_HOST 也不是连接 Prometheus 数据源所必需的环境变量。
原笔记把 Grafana 告警概括为“不常用”,现在应按告警源选择:Grafana 可评估和路由自身管理的规则,Prometheus 规则也可交给 Alertmanager 处理。两者都不是另一个的简单替代。
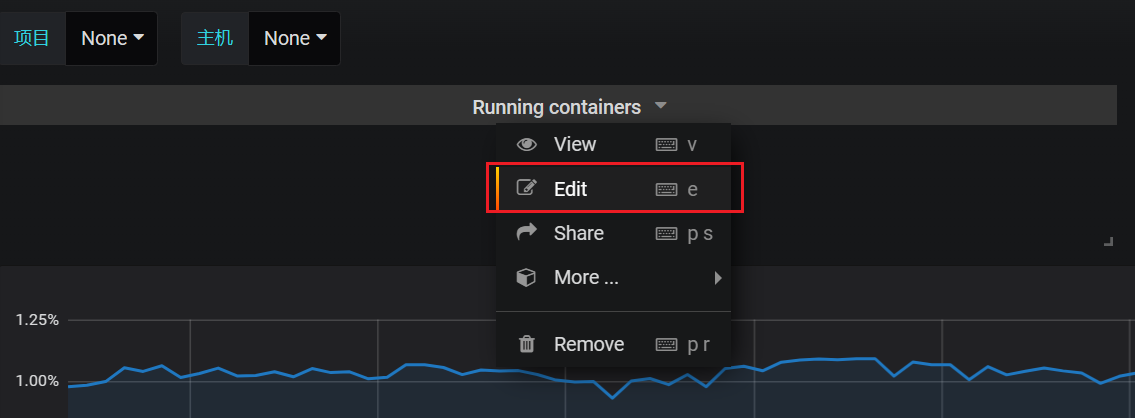
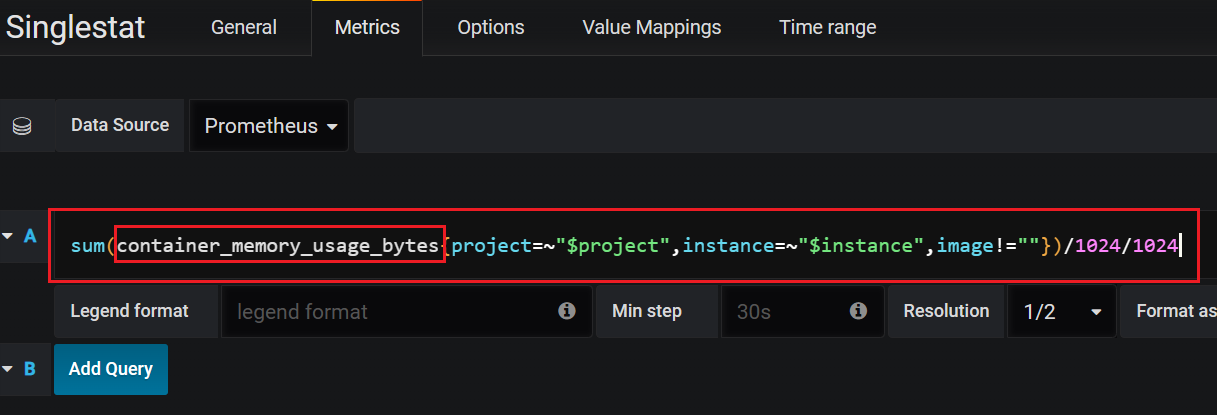
4.3 面板没有数据时如何定位
- 在 Grafana 面板的 Edit 页面查看 PromQL、变量和时间范围。
- 把表达式复制到 Prometheus 查询页执行;如果这里也没有数据,先检查 Status → Targets、Exporter 指标和标签。
- 如果 Prometheus 有数据而面板没有,对照实际指标名、标签和值类型修改查询。旧 Dashboard 可能使用已经变化的指标名。
5. kube-state-metrics:采集 Kubernetes 对象状态
kube-state-metrics(KSM)监听 Kubernetes API,为 Pod、Deployment、Node 等资源对象的状态生成指标;它不存储指标,也不代替 Node Exporter 或 kubelet/cAdvisor 的资源用量指标。Prometheus 负责抓取并保存其 /metrics,Grafana 再用这些时间序列展示副本数、Pod 阶段和 Job 状态。
5.1 安装与权限
旧实验采用 quay.io/coreos/kube-state-metrics:v1.9.0,手写 ServiceAccount、ClusterRole、ClusterRoleBinding、Deployment 和 Service;其中 Deployment、DaemonSet、ReplicaSet 的 RBAC 规则还放在 extensions API 组。当前 Kubernetes 的这些工作负载应使用 apps 组。KSM 的镜像和所需 RBAC 也随版本变化,复现时应按 上游兼容矩阵 选择版本,并使用该版本的 standard 清单 作为完整部署基线,而不是直接套用 v1.9.0 的旧清单。
部署关系与原实验一致:
- ServiceAccount
kube-state-metrics供 Deployment 调用 Kubernetes API。 - ClusterRole / ClusterRoleBinding 赋予所监控对象的
list、watch权限;对应资源组由所选版本的上游清单确定。 - Deployment 运行 KSM;Service 将指标端口
8080暴露为集群内端点。上游示例位于kube-system命名空间。
例如,在已经选好兼容版本并取得其对应清单后:
# 在所选 kube-state-metrics 源码版本的根目录执行
kubectl apply -f examples/standard/
kubectl -n kube-system get deploy,svc kube-state-metrics
kubectl -n kube-system port-forward svc/kube-state-metrics 8080:8080
curl http://127.0.0.1:8080/metrics
本文第 3.2 节的 Prometheus 配置依赖 Service 注解发现;上游 standard Service 默认没有这组注解,因此还需按实际 Service 名称和端口添加:
kubectl -n kube-system annotate svc kube-state-metrics \
  prometheus.io/scrape="true" prometheus.io/port="8080" --overwrite
5.2 在 Prometheus 和 Grafana 验证
- 在 Prometheus Status → Targets 查找 kube-state-metrics,并查询
kube_pod_status_phase、kube_deployment_status_replicas_available等指标。 - Grafana 中导入原实验记录的
Kubernetes Cluster (Prometheus)-1577674936972.json与Kubernetes cluster monitoring (via Prometheus) (k8s 1.16)-1577691996738.json。 - 如果模板没有数据,先核对模板所需的指标名、标签与当前 KSM 版本,再按第 4.3 节排查查询。
KSM 也用于 外部 Kubernetes 集群监控;该笔记记录了旧版镜像导入和远端抓取场景。
6. 监控常见应用
这些示例保留了原实验的服务、端口、Exporter、Dashboard 与关键命令。Tomcat 8、Redis 4、旧版 MySQL/Nginx Exporter 等版本仅供理解接入方式;生产部署应检查镜像维护状态、认证方式与 Service/Pod 的实际 /metrics 地址。Prometheus 的 kubernetes-service-endpoints job 只抓取带注解的 Service;外部主机或数据库可使用静态 target。更多 ServiceMonitor/ScrapeConfig 示例见 非云原生应用与主机监控。
6.1 Tomcat
原实验使用 tomcat_exporter,将 metrics.war、simpleclient-0.8.0.jar、simpleclient_common-0.8.0.jar、simpleclient_hotspot-0.8.0.jar、simpleclient_servlet-0.8.0.jar 和 tomcat_exporter_client-0.0.12.jar 加入 Tomcat 镜像:
FROM tomcat:8.5-jdk8-corretto
ADD metrics.war /usr/local/tomcat/webapps/
ADD simpleclient-0.8.0.jar /usr/local/tomcat/lib/
ADD simpleclient_common-0.8.0.jar /usr/local/tomcat/lib/
ADD simpleclient_hotspot-0.8.0.jar /usr/local/tomcat/lib/
ADD simpleclient_servlet-0.8.0.jar /usr/local/tomcat/lib/
ADD tomcat_exporter_client-0.0.12.jar /usr/local/tomcat/lib/
docker build -t tomcat_prometheus:v1 .
docker save -o tomcat_prometheus_v1.tar tomcat_prometheus:v1
原实验通过两副本 Deployment 和 svc-tomcat NodePort 31360 暴露 8080:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: dep-tomcat
  namespace: default
spec:
  replicas: 2
  selector:
    matchLabels:
      app: tomcat
  template:
    metadata:
      labels:
        app: tomcat
    spec:
      containers:
        - name: tomcat
          image: tomcat_prometheus:v1
          ports:
            - containerPort: 8080
---
apiVersion: v1
kind: Service
metadata:
  name: svc-tomcat
  namespace: default
  annotations:
    prometheus.io/scrape: "true"
    prometheus.io/port: "8080"
spec:
  type: NodePort
  selector:
    app: tomcat
  ports:
    - port: 80
      targetPort: 8080
      nodePort: 31360
如果用上文的 Service 注解发现规则,还需根据此 Exporter 实际暴露路径设置 prometheus.io/path。先用 curl 验证目标端点返回 Prometheus 文本格式,再检查 Targets。原笔记仅给出了 scrape 注解,未确认路径;不能仅凭注解认为采集成功。
6.2 Redis
原实验把 Redis 和 oliver006/redis_exporter 放进同一 Pod,Redis 监听 6379,Exporter 监听 9121。Service 同时开放两个端口,其中 metrics 端口加注解供 Prometheus 发现:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: redis
  namespace: kube-system
spec:
  replicas: 1
  selector:
    matchLabels:
      app: redis
  template:
    metadata:
      labels:
        app: redis
    spec:
      containers:
        - name: redis
          image: redis:4
          ports:
            - containerPort: 6379
        - name: redis-exporter
          image: oliver006/redis_exporter:latest
          ports:
            - containerPort: 9121
apiVersion: v1
kind: Service
metadata:
  name: redis
  namespace: kube-system
  annotations:
    prometheus.io/scrape: "true"
    prometheus.io/port: "9121"
spec:
  selector:
    app: redis
  ports:
    - name: redis
      port: 6379
      targetPort: 6379
    - name: metrics
      port: 9121
      targetPort: 9121
原示例使用 redis:4 与 oliver006/redis_exporter:latest,并在 Grafana 导入 Redis Cluster-1571393212519.json。实用时固定 Exporter 版本并确认其 Redis 连接地址;同 Pod 场景通常可通过 localhost 连接。原笔记参考:Redis 监控实验。
6.3 MySQL
原实验以 mysqld_exporter-0.10.0.linux-amd64 监控本机 MySQL,Exporter 端口为 9104。下载与目标平台匹配的归档后,按原实验步骤安装二进制:
tar -xvf mysqld_exporter-0.10.0.linux-amd64.tar.gz
install -m 0755 mysqld_exporter-0.10.0.linux-amd64/mysqld_exporter /usr/local/bin/mysqld_exporter
创建专用账号并赋予采集所需权限,密码应通过安全方式注入,以下仅展示配置形状:
CREATE USER 'mysql_exporter'@'localhost' IDENTIFIED BY '<password>';
GRANT PROCESS, REPLICATION CLIENT, SELECT ON *.* TO 'mysql_exporter'@'localhost';
# my.cnf(限制文件读取权限)
[client]
user=mysql_exporter
password=<password>
chmod 600 my.cnf
./mysqld_exporter --config.my-cnf=./my.cnf
curl http://127.0.0.1:9104/metrics
将 192.168.40.180:9104 替换成实际 Exporter 地址,并将下面的 job 放在 scrape_configs 列表中:
- job_name: mysql
  static_configs:
    - targets: ["192.168.40.180:9104"]
原实验在 Grafana 导入 mysql-overview_rev5.json;修改配置后按第 3.4 节热加载,不必删除 Deployment。Kubernetes 内的 MySQL Exporter + ServiceMonitor 示例也见前述“非云原生应用与主机监控”。
6.4 Nginx VTS
原实验为 Nginx 1.15.7 编译 nginx-module-vts,再用 nginx-vts-exporter-0.5 把模块提供的 JSON 指标转换为 Prometheus 格式:
- 解压模块并在 Nginx 编译参数中加入
--add-module=/usr/local/nginx-module-vts-master;原实验还启用http_ssl、http_stub_status、http_gzip_static等模块。
unzip nginx-module-vts-master.zip
mv nginx-module-vts-master /usr/local/nginx-module-vts-master
tar zxvf nginx-1.15.7.tar.gz
cd nginx-1.15.7
./configure --prefix=/usr/local/nginx --with-http_gzip_static_module --with-http_stub_status_module --with-http_ssl_module --with-pcre --with-file-aio --with-http_realip_module --add-module=/usr/local/nginx-module-vts-master
make && make install
- 在 Nginx 的
http块中配置vhost_traffic_status_zone;,在server块中配置以下位置。Nginx 配置文件使用#注释,不能照搬旧笔记里的//。 - 运行
nginx -t,确认/status/format/json可访问,再启动 Exporter。
location /status {
    vhost_traffic_status_display;
    vhost_traffic_status_display_format html;
}
./nginx-vts-exporter -nginx.scrape_uri http://192.168.40.180/status/format/json
Exporter 监听 9913;在 scrape_configs 中增加:
- job_name: nginx
  scrape_interval: 5s
  static_configs:
    - targets: ["192.168.40.180:9913"]
原实验的 Grafana 模板为 nginx-vts-stats_rev2.json。对外暴露 /status 前应设置访问限制。
6.5 MongoDB
原实验以容器运行 MongoDB,使用 percona/mongodb_exporter:0.34.0 暴露 9104,宿主机映射为 30056。原命令先拉取 eses/mongodb_exporter,实际启动却使用 Percona 镜像;这里统一为运行时使用的镜像。数据库账号需具备 Exporter 要求的读取权限,并启用相应认证;仅创建 userAdminAnyDatabase 用户不能视为监控权限已经配置完成。按 Percona Exporter 文档 为专用用户授予 clusterMonitor@admin 和 read@local,例如在已认证的 mongosh 会话中执行:
use admin
db.createUser({
  user: "mongodb_exporter",
  pwd: "<password>",
  roles: [
    { role: "clusterMonitor", db: "admin" },
    { role: "read", db: "local" }
  ]
})
docker run -d --name mongodb -p 27017:27017 -v /data/db:/data/db mongo:7.0
docker run -d --name mongodb_exporter -p 30056:9104 \
  percona/mongodb_exporter:0.34.0 \
  --mongodb.uri='mongodb://<exporter-user>:<password>@192.168.40.180:27017/admin'
先用 curl http://192.168.40.180:30056/metrics 验证端点,再在 scrape_configs 中加入:
- job_name: mongodb
  scrape_interval: 5s
  static_configs:
    - targets: ["192.168.40.180:30056"]
原实验中的 docker exec 容器 ID 和 admin111111 明文口令属于一次性环境数据,不能作为可复用部署参数。
7. Pushgateway:短生命周期批处理指标
Pushgateway 接收任务主动推送的指标,Prometheus 仍定时从 Pushgateway 拉取。官方建议主要用于无法被抓取的、与具体机器实例无关的短生命周期批处理任务。它不会自动清理已推送的序列,也无法替代单个实例的 up 健康检查;不要把它当作普通主机/服务的通用防火墙穿透方案。
7.1 启动与抓取
docker run -d --name pushgateway -p 9091:9091 prom/pushgateway:VERSION
curl http://192.168.40.181:9091/metrics
在 Prometheus 的 scrape_configs 中新增:
- job_name: pushgateway
  honor_labels: true
  scrape_interval: 5s
  static_configs:
    - targets: ["192.168.40.181:9091"]
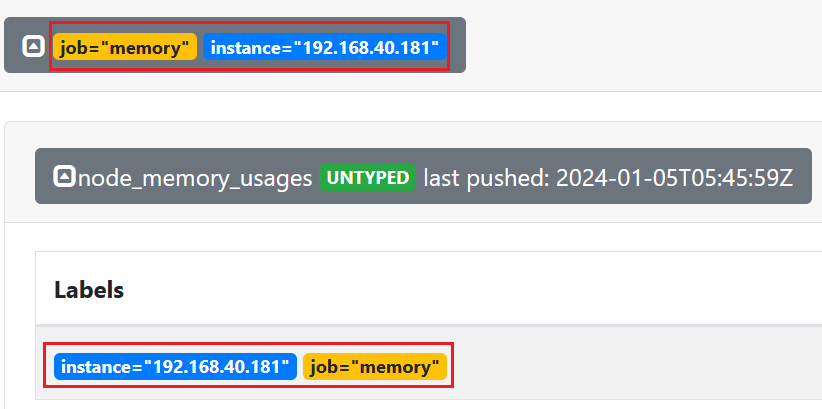
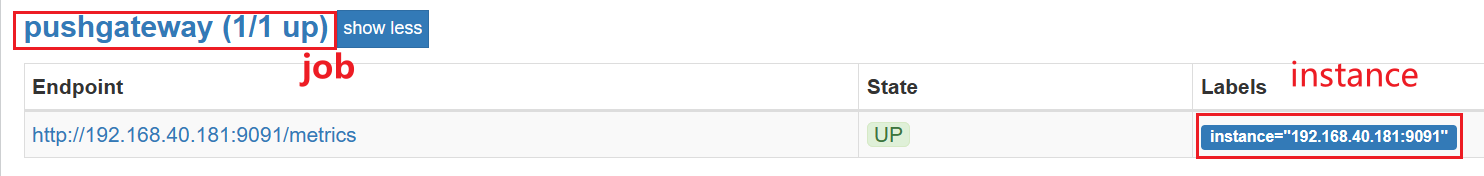
honor_labels: true 表示抓取样本中的 job、instance 等标签与 Prometheus 为 target 添加的标签冲突时,保留样本标签。默认 false 则会把样本中的冲突标签改名为 exported_job、exported_instance。这对 Pushgateway 和联邦尤其重要。
7.2 推送与清理
以下保留原实验的 test_job 示例。任务结束或标签维度不再使用时,要负责清理过期分组:
echo "metric 3.6" | curl --data-binary @- \
  http://192.168.40.181:9091/metrics/job/test_job

cat <<'EOF' | curl --data-binary @- \
  http://192.168.40.181:9091/metrics/job/test_job/instance/test_instance
node_memory_usage 37
node_memory_total 36000
EOF

curl -X DELETE \
  http://192.168.40.181:9091/metrics/job/test_job/instance/test_instance
curl -X DELETE \
  http://192.168.40.181:9091/metrics/job/test_job
旧笔记还用 free -m、awk '{print $3/$2*100}'、crontab */1 * * * * 每分钟推送主机内存百分比。这保留为历史实验思路,但持续运行的主机应通过 Node Exporter 抓取;与机器绑定的短任务可考虑 Node Exporter textfile collector。Pushgateway 按 instance 累积指标会形成陈旧序列,并使 up 仅反映 Gateway 自身。
8. 验证清单
kubectl -n monitor-sa get pods,pvc,svc:确认 Node Exporter、Prometheus、Grafana 及 PVC 状态。- Prometheus Status → Targets:检查 Node Exporter、cAdvisor、API Server 和带注解的 Service;从错误提示区分 RBAC、TLS、网络、端口和指标路径问题。
- Prometheus 查询
up与node_cpu_seconds_total;PromQL 例子见 Prometheus 基础。 - Grafana 保存并测试 Prometheus 数据源,再打开导入的 Dashboard,检查变量和指标名是否与当前 Exporter 匹配。